चेक-इन दरम्यान हॉटेलमधील इंटरनेट ॲक्सेस बंद होतो. गेस्ट WiFi वर ऑथेंटिकेट करू शकत नाहीत, कार्ड टर्मिनल टाईम आऊट होऊ लागतात, कर्मचाऱ्यांचा क्लाउड सिस्टमवरील ॲक्सेस निघून जातो आणि रिसेप्शनवर असा शेअर्ड पासवर्ड दिला जाऊ लागतो जो कोणीही रिव्होक करू शकत नाही. बॅकअप सर्किट अस्तित्वात आहे, परंतु फायरवॉल पॉलिसीची कधीही चाचणी घेण्यात आली नव्हती. दुसरे RADIUS सर्व्हर कॉन्फिगर केले आहे, परंतु ॲक्सेस पॉइंट्स तिथपर्यंत पोहोचू शकतील की नाही हे कोणालाही माहीत नाही. UPS चांगला स्टेटस दाखवत आहे कारण लोड असताना बॅटरीची कोणीही तपासणी केली नाही.
ही केवळ हार्डवेअरची समस्या नाही. हे एक redundancy नियोजनाचे अपयश आहे.
नेटवर्क रेझिलियन्स म्हणजे जेव्हा एखादा घटक, लिंक, साइट, पॉवर फीड किंवा आयडेंटिटी डिपेंडन्सी अयशस्वी होते, तेव्हा प्रमाणीकरण, कनेक्टिव्हिटी आणि आवश्यक सेवा उपलब्ध ठेवणे. कपाटात ठेवलेला अतिरिक्त स्विच रेझिलियन्स तयार करत नाही. तर पेमेंट VLAN, क्लिनिकल ॲप्लिकेशन, स्टाफ लॉगिन किंवा गेस्ट WiFi सेशन चालू ठेवणारा चाचणी केलेला मार्ग रेझिलियन्स तयार करतो.
आधुनिक नेटवर्कसाठी Redundancy नियोजनाचा अचूक अर्थ काय आहे
नेटवर्क रिडंडन्सी नियोजन ही व्यावसायिक सातत्य राखण्याची शिस्त आहे, उपकरणे खरेदी करण्याचा सराव नाही. प्रश्न तुमच्याकडे दोन स्विचेस आहेत की नाही हा नाही. प्रश्न हा आहे की एखादा निश्चित बिघाड झाल्यानंतरही वापरकर्ते कनेक्ट होऊ शकतात, ऑथेंटिकेट करू शकतात, सेवा रिझॉल्व्ह करू शकतात आणि ऑपरेशन चालू ठेवणाऱ्या ॲप्लिकेशन्सपर्यंत पोहोचू शकतात का.
त्यासाठी failure domains ची स्पष्ट माहिती आवश्यक आहे. failure domain हा असा घटक किंवा अवलंबित्व आहे जो स्वतंत्रपणे निकामी होऊ शकतो आणि संपूर्ण सेवा बंद पाडू शकतो. सामान्य डोमेन्समध्ये खालील गोष्टींचा समावेश होतो:
- ॲक्सेस इन्फ्रास्ट्रक्चर, ज्यामध्ये स्विचेस, ॲक्सेस पॉइंट्स, PoE बजेट्स, अपलिंक्स आणि वायरलेस कंट्रोलर्सचा समावेश आहे.
- आयडेंटिटी सर्व्हिसेस, ज्यामध्ये RADIUS, डिरेक्टरी इंटिग्रेशन्स, सर्टिफिकेट्स, Captive Portals आणि आयडेंटिटी प्रोव्हाइडर्सचा समावेश आहे.
- कोअर सर्व्हिसेस, ज्यामध्ये DHCP, DNS, गेटवे फंक्शन्स आणि नेटवर्क पॉलिसीचा समावेश आहे.
- बाह्य मार्ग, ज्यामध्ये WAN सर्किट्स, ISP उपकरणे, क्लाउड प्लॅटफॉर्म्स आणि थर्ड-पार्टी ऑथेंटिकेशन सर्व्हिसेसचा समावेश आहे.
- सुविधा, ज्यामध्ये पॉवर डिस्ट्रिब्युशन, UPS बॅटरी, जनरेटर कव्हरेज आणि इंटरमीडिएट डिस्ट्रिब्युशन फ्रेम रूम्सचा समावेश आहे.
डिझाईनमध्ये लवचिक कोअर राउटर असू शकतात आणि तरीही ते कडेला (edge) अयशस्वी होऊ शकतात. जर DNS रिझोल्यूशन थांबले, तर वापरकर्ते WiFi शी कनेक्ट केलेले असू शकतात परंतु त्यांना आवश्यक असलेल्या सेवांपर्यंत पोहोचू शकत नाहीत. जर RADIUS प्रतिसाद देणे थांबवेल, तर निरोगी वायरलेस नेटवर्क प्रत्येक कर्मचारी किंवा अतिथी लॉगिन नाकारू शकते. जर Captive Portal एका अगम्य क्लाउड पाथवर अवलंबून असेल, तर ठिकाणावर रेडिओ कव्हरेज असूनही वापरण्यायोग्य अतिथी प्रवेश नसेल.
घटक रिडंडन्सीपासून सेवा सातत्य वेगळे ठेवा
डिव्हाइसेसपासून नव्हे, तर सेवांपासून सुरुवात करा. व्यवसायाने जतन करणे आवश्यक असलेल्या सेवा लिहून काढा, त्यानंतर त्या प्रत्येकाच्या खालील प्रत्येक अवलंबित्व (dependency) शोधा. उदाहरणार्थ, गेस्ट WiFi ऑथेंटिकेशन हे ॲक्सेस पॉईंट्स, स्विचिंग, PoE, वायरलेस कंट्रोल प्लेन, DHCP, DNS, WAN ॲक्सेस, RADIUS, आयडेंटिटी प्रोव्हायडर आणि स्वतः पोर्टलवर अवलंबून असू शकते.
एक उपयुक्त नेटवर्क टीम WiFi नियोजन संदर्भ तुम्हाला याच निष्कर्षावर नेईल: वायरलेस ॲक्सेस ही एक कार्यरत प्रणाली आहे, LAN वर जोडलेला केवळ एक रेडिओ स्तर नाही.
UK मधील नियोक्ते सामूहिक कर्मचारी कपात नियोजनाचा स्वतंत्र वैधानिक अर्थ वापरतात. जेथे नियोक्ता फिरत्या ९० दिवसांच्या कालावधीत एकाच आस्थापनेत २० किंवा त्याहून अधिक कर्मचाऱ्यांना काढून टाकण्याचा प्रस्ताव ठेवतो, तेथे सामूहिक सल्लामसलत लागू होते. यामध्ये २० ते ९९ कपातींसाठी पहिल्या बडतर्फीच्या किमान ३० दिवस आधी किंवा १०० किंवा त्याहून अधिक कपातींसाठी पहिल्या बडतर्फीच्या ४५ दिवस आधी सल्लामसलत सुरू होते. UK सरकारचे सल्लामसलत मार्गदर्शन स्पष्ट करते की सल्लामसलतीमध्ये प्रस्तावित कपातीची कारणे, ती टाळण्याचे मार्ग आणि बडतर्फीची संख्या कमी करण्याचे मार्ग संबोधित केले पाहिजेत. हा एक HR नियोजनाचा आराखडा आहे. येथे वर्णन केलेली नेटवर्क शिस्त ही सेवा बिघाड, अवलंबित्व मॅपिंग आणि रिकव्हरी आर्किटेक्चरशी संबंधित आहे.
प्रायोगिक नियम: बॅकअप उपकरणांची गणना करू नका. वापरकर्त्यापासून ते सेवेपर्यंतच्या स्वतंत्र मार्गांची गणना करा.
या मार्गदर्शकाचा उर्वरित भाग त्याच व्यावहारिक दृष्टिकोनाचा वापर करतो. अपयशाचे धोके ओळखा, व्यवसायातील अडथळे दर्शवणारे रिकव्हरीचे उद्दिष्ट सेट करा, तुमचे पथक चालवू शकेल अशी आर्किटेक्चर निवडा, पॉवरपासून ओळखीपर्यंत (identity) प्रत्येक स्तराचे संरक्षण करा आणि नियंत्रित परिस्थितीत परिणामांची चाचणी घ्या. जर एखादा घटक सराव तालीममध्ये कधीही अयशस्वी झाला नसेल, तर त्याच्या रिडंडन्सीला एक गृहीतक समजा, क्षमता नाही.
तुम्ही समस्येचे निराकरण डिझाइन करण्यापूर्वी बिघाड जोखमींचे मॅपिंग करणे
बहुतेक नेटवर्क टीम्सना त्यांचे सर्वात धोकादायक आणि गंभीर बिघाड बिंदू (single points of failure) शोधण्यासाठी कोणत्याही गव्हर्नन्स प्लॅटफॉर्मची आवश्यकता नसते. त्यांना एका छोट्या नोंदवहीची आवश्यकता असते जी जोखमीचे नाव दर्शवते, त्याचे सातत्यपूर्ण वर्गीकरण करते, मालक नियुक्त करते आणि एखाद्याने तो धोका कमी केला आहे की नाही याची नोंद ठेवते.
तीन अक्ष वापरा:
- संभाव्यता (Likelihood), म्हणजेच तुलनात्मक मालमत्तेमध्ये बिघाड किती वेळा होतो किंवा तुमच्या स्वतःच्या वातावरणात किती वेळा झाला आहे.
- ब्लास्ट रेडियस (Blast radius), म्हणजेच किती युजर्स, साईट्स, सेवा किंवा महसूल मिळवून देणारे उपक्रम अनुपलब्ध होतात.
- रिकव्हरी वेदना (Recovery pain), म्हणजेच आज तुमच्याकडे असलेली कौशल्ये, ॲक्सेस, स्पेअर्स, व्हेंडर सपोर्ट आणि डॉक्युमेंटेशनसह रिस्टोरेशन करणे किती कठीण आहे.
स्थानिक स्केलवर प्रत्येक अक्षाचे गुण निश्चित करा, नंतर तिन्ही मूल्यांचा गुणाकार करा किंवा वेटेड फॉर्म्युला लागू करा. गणितापेक्षा सातत्य राखणे अधिक महत्त्वाचे आहे. एका सिंगल WAN सर्किटला विलग केलेल्या मार्केटिंग डिस्प्लेपेक्षा वरचे स्थान दिले पाहिजे कारण त्याचा बिघाड एकाच वेळी प्रत्येक संबंधित सेवेवर परिणाम करू शकतो.
वास्तविक डिपेंडन्सीभोवती रजिस्टर तयार करा
अशा मालमत्तांचा समावेश करा ज्यांच्याकडे टीम्स अनेकदा दुर्लक्ष करतात. पहिल्या उपयुक्त टप्प्यामध्ये खालील गोष्टींचा समावेश असावा:
- पूर्ण वेन्यूसाठी सेवा देणारे एकच WAN ISP किंवा सर्किट.
- एक RADIUS सेवा किंवा एक आयडेंटिटी-प्रदाता इंटिग्रेशन.
- एकच DNS रिझॉल्व्हर पाथ.
- एकच वायरलेस कंट्रोलर किंवा क्लाउड मॅनेजमेंट डिपेंडन्सी.
- कोणतेही जनरेटर कव्हरेज नसलेली इंटरमीडिएट डिस्ट्रिब्युशन फ्रेम रूम.
- UPS बॅटरी ज्या स्टेटस दाखवतात परंतु त्यांची कधीही प्रत्यक्ष लोडखाली चाचणी केली गेली नाही.
- कोणताही डॉक्युमेंटेड डिग्रेडेड मोड नसलेला Captive Portal.
- एक स्विच स्टॅक ज्यांच्या अपलिंक्स एकच फिजिकल मार्ग शेअर करतात.
- कोणतीही चाचणी केलेली रिकव्हरी पद्धत नसलेली DHCP सेवा.
रजिस्टरमध्ये सर्व्हिस ओनर, तांत्रिक ओनर, शेवटच्या बिघाडाची तारीख, सध्याची उपाययोजना, चाचणीची तारीख आणि पुढील कृती देखील नोंदवली पाहिजे. "नेटवर्क टीम" ही ओनर असू शकत नाही. बदल घडवून आणण्यासाठी आणि ते कार्यरत असल्याचे सिद्ध करण्यासाठी जबाबदार असलेल्या व्यक्तीचे किंवा टीमचे नाव द्या.
नेटवर्क जोखीम रजिस्टर स्कोरिंगचा नमुना
खालील केवळ एक कार्यरत टेम्पलेट आहे, कोणत्याही विशिष्ट मालमत्तेचा दावा नाही. प्रत्येक अक्षासाठी सुसंगत स्थानिक स्केल वापरा आणि प्रत्येक नोंदीसाठी अंतिम गुणांची गणना त्याच पद्धतीने करा.
| अपयश परिस्थिती | शक्यता (1-5) | परिणाम व्याप्ती (1-5) | पुनर्प्राप्ती त्रास (1-5) | धोका स्कोअर |
|---|---|---|---|---|
| एकल WAN सर्किट | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | शक्यता × परिणाम व्याप्ती × पुनर्प्राप्ती त्रास |
| एकल RADIUS सेवा | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | शक्यता × परिणाम व्याप्ती × पुनर्प्राप्ती त्रास |
| एकल DNS रिझोल्व्हर पाथ | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | शक्यता × परिणाम व्याप्ती × पुनर्प्राप्ती त्रास |
| एकल वायरलेस कंट्रोलर | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | शक्यता × परिणाम व्याप्ती × पुनर्प्राप्ती त्रास |
| जनरेटर नसलेली IDF रूम | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | शक्यता × परिणाम व्याप्ती × पुनर्प्राप्ती त्रास |
| देखरेख नसलेल्या UPS बॅटऱ्या | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | स्थानिक पातळीवर रेट करा | शक्यता × परिणाम व्याप्ती × पुनर्प्राप्ती त्रास |
परिपूर्ण रजिस्टरची वाट पाहू नका. कोणीही अपडेट न करणाऱ्या पॉलिश केलेल्या जोखीम प्रणालीपेक्षा विश्वासार्ह ओनर असलेली एका पानाची यादी अधिक उपयुक्त ठरते. तात्काळ उद्दिष्ट प्राधान्य ठरवणे हे आहे. गंभीर सेवा बंद पाडू शकणाऱ्या त्रुटींचे वर्गीकरण करा, नंतर रिकव्हरी उद्दिष्टे सेट करण्यासाठी आणि आर्किटेक्चर निवडण्यासाठी त्या निकालांचा वापर करा.
अधिकृत UK व्यवस्थापन माहिती दर्शवते की वेगवेगळ्या परंतु संबंधित वर्कफोर्स संदर्भात संरचनात्मक आगाऊ नियोजन का महत्त्वाचे आहे. सरकारच्या कर्मचारी कपात अधिसूचना डेटा नुसार, नियोक्त्यांनी जानेवारी २०२० मध्ये २९,४९६ संभाव्य कर्मचारी कपातीचा समावेश असलेले ३६८ HR1 फॉर्म आणि फेब्रुवारी २०२० मध्ये २७,८०४ संभाव्य कर्मचारी कपातीचा समावेश असलेले ३२६ फॉर्म सबमिट केले. नेटवर्क लीडर्ससाठी धडा सरळ आहे: औपचारिक नियोजन अस्तित्वात आहे कारण मोठे ऑपरेशनल बदल तात्काळ करणे कठीण असते. जेव्हा मल्टी-साइट नेटवर्क सामायिक अवलंबित्व गमावते तेव्हा देखील हेच लागू होते.
वास्तविक व्यावसायिक त्रासाशी सुसंगत असणारे RTO आणि RPO उद्दिष्टे निश्चित करणे
RTO आणि RPO तेव्हाच उपयुक्त ठरतात जेव्हा व्यवसायाच्या मालकांना ते समजू शकतात.
रिकव्हरी टाईम ऑब्जेक्टिव्ह (Recovery time objective), किंवा RTO, हा जास्तीत जास्त स्वीकार्य वेळ आहे ज्या दरम्यान एखादी सेवा अनुपलब्ध राहू शकते. रिकव्हरी पॉईंट ऑब्जेक्टिव्ह (Recovery point objective), किंवा RPO, हा शेवटच्या रिकव्हरेबल पॉईंटपासून डेटा, कॉन्फिगरेशन किंवा सेशन स्टेटचे जास्तीत जास्त स्वीकार्य नुकसान आहे. नेटवर्कसाठी, RPO चा संबंध पारंपारिक डेटाबेस व्यवहाराऐवजी कॉन्फिगरेशन, पॉलिसी, डिव्हाइस स्टेट, इव्हेंट रेकॉर्ड किंवा ॲक्टिव्ह ऑथेंटिकेशन कॉन्टेक्स्टशी असू शकतो.
दोन्ही उपायांचे ऑपरेशनल परिणामांमध्ये भाषांतर करा. जेव्हा सेवा अपयशी ठरते तेव्हा सर्वात आधी काय थांबते ते विचारा. रिसेप्शनवर पाहुण्यांची रांग लागते का? काउंटर पेमेंट स्वीकारणे थांबवतात का? डॉक्टरांचा इलेक्ट्रॉनिक रेकॉर्ड्सवरील प्रवेश सुटतो का? मालमत्ता व्यवस्थापकाचे भाडेकरूंच्या प्रवेश नियंत्रणावरील नियंत्रण सुटते का? सेवा मालकाने केवळ IT उद्दिष्टाची पुनरावृत्ती न करता व्यावसायिक परिणाम स्पष्ट केला पाहिजे.
संपूर्ण इस्टेटसाठी एकाच आश्वासनाऐवजी सेवा स्तरांचा वापर करा
एक व्यावहारिक सेवा नकाशा गंभीर ॲक्सेसला प्रतीक्षा करू शकणाऱ्या सेवांपासून वेगळा करतो.
| सेवा स्तर (Service Tier) | नमुना सेवा | लक्ष्य RTO | लक्ष्य RPO | आर्किटेक्चर परिणाम (Architecture Implication) |
|---|---|---|---|---|
| स्तर १ (Tier 1) | Guest WiFi प्रमाणीकरण, पेमेंट VLAN, क्लिनिकल ॲप्लिकेशन ॲक्सेस | मिनिटे, व्यावसायिक सहनशीलतेवर आधारित | पॉलिसी आणि प्रमाणीकरण स्थितीचे किमान नुकसान | स्वतंत्र मार्ग, जलद फेलओव्हर, लवचिक ओळख, चाचणी केलेली वीज |
| स्तर २ (Tier 2) | कर्मचारी WiFi, बॅक-ऑफिस सिस्टम, ॲनालिटिक्स सिंक्रोनाइझेशन | अंदाजे एक तास, जेथे ऑपरेशन परवानगी देते | अलीकडील कॉन्फिगरेशन आणि सेवा स्थिती | वॉर्म स्टँडबाय, जेथे न्याय्य असेल तेथे दुहेरी मार्ग, दस्तऐवजीकरण केलेली रिकव्हरी |
| स्तर ३ (Tier 3) | पाहुण्यांचे मनोरंजन, मार्केटिंग स्प्लॅश पेजेस, गैर-गंभीर रिपोर्टिंग | अनेक तास स्वीकार्य असू शकतात | बॅकअप-आधारित रिकव्हरी पुरेशी असू शकते | कमी खर्चाचा स्टँडबाय किंवा मॅन्युअल रिस्टोरेशन |
ही नियोजनाची उदाहरणे आहेत, युनिव्हर्सल सर्व्हिस लेव्हल्स नाहीत. फायनान्स विभागाने एका साध्या लॉस मॉडेलचा वापर करून लक्ष्याचे प्रमाणीकरण केले पाहिजे: अंदाजे तासाभरातील महसूल योगदान, ऑपरेशनल अडथळा, प्रतिष्ठेला होणारा धोका आणि कंप्लायन्सवरील परिणाम, या सर्वांना व्यवसाय सहन करू शकणाऱ्या डाउनटाइमने विभाजित करावे. खोट्या अचूकतेचा दावा टाळा. पेमेंट सेवेसाठी कोणताही अर्थपूर्ण "सरासरी तास" नसू शकतो, कारण व्यस्त ट्रेडिंग वेळेत झालेला छोटा आउटेज रात्रीच्या मोठ्या आउटेजपेक्षा जास्त नुकसान करू शकतो.
RTO मध्ये दोष शोधण्याचा आणि निर्णय घेण्याचा कालावधी देखील समाविष्ट असणे आवश्यक आहे. एखाद्या इंजिनिअरला त्रुटी आढळल्यानंतर वेगाने पूर्ण होणारे failover देखील व्यावसायिक उद्दिष्ट चुकवू शकते, जर मॉनिटरिंग अलर्ट जारी करण्यासाठी खूप जास्त वेळ घेत असेल. रिकव्हरीच्या अंदाजामध्ये DNS प्रोपॅगेशन वर्तन, सेशनचे पुन्हा प्रमाणीकरण, डिव्हाइसचे कनेक्शन पुन्हा जोडणे, फायरवॉल कन्व्हरजन्स आणि मानवी एस्केलेशन यांचा समावेश करा.
RPO ला देखील तितक्याच शिस्तीची गरज आहे. बिघाड होण्यापूर्वी काही वेळ आधी केलेले कॉन्फिगरेशन बदल गायब झाल्यास, टीम ते पुन्हा तयार करू शकते का? जर गेस्ट सेशन्सचे पुन्हा प्रमाणीकरण करावे लागत असेल, तर ते स्वीकार्य आहे का? जर आयडेंटिटी डिरेक्टरी तात्पुरती अनुपलब्ध असेल, तर ॲक्सेस लेयर सुरक्षा कमकुवत न करता आधीपासून माहिती असलेली चांगली पॉलिसी वापरू शकते का?
आक्रमक RTO उद्दिष्टांसाठी सहसा ॲक्टिव्ह-ॲक्टिव्ह किंवा भौगोलिकदृष्ट्या स्वतंत्र क्षमतेची आवश्यकता असते. अधिक उदार RTO वॉर्म स्टँडबाय, दस्तऐवजीकरण केलेले पुनर्संचयित करणे किंवा बॅकअप-आधारित रिकव्हरीला समर्थन देऊ शकते. जेव्हा ठिकाण अजूनही एकाच ISP, एकाच पॉवर फीड किंवा एकाच आयडेंटिटी पाथवर अवलंबून असेल तेव्हा करारातील एंटरप्राइझ सेवा पातळीची कॉपी करू नका. आर्किटेक्चरला ते उद्दिष्ट साध्य करावे लागेल.
तुमच्या मालमत्तेसाठी योग्य फेलओव्हर आर्किटेक्चर निवडणे
चार पॅटर्न बहुतेक वास्तविक-जगातील ठिकाणांच्या उपयोजनांचा (venue deployments) समावेश करतात. यापैकी कोणताही स्वयंचलितपणे योग्य नाही. योग्य पर्याय हा डाउनटाइम सहनशीलता, मालमत्तेचा आकार, ऑपरेशनल कौशल्य, बिघाड स्वातंत्र्य आणि बजेटवर अवलंबून असतो.
ऍक्टिव्ह-ऍक्टिव्ह पद्धत एकाच वेळी ट्रॅफिक हाताळण्यासाठी दोन किंवा अधिक सक्षम घटक सुरू ठेवते. ड्युअल कंट्रोलर्स किंवा ऍक्सेस क्लस्टर्स मागणी वाटून घेऊ शकतात आणि एक घटक निकामी झाल्यास दुसरा बाजूचा घटक काम सुरू ठेवू शकतो. हे बिघाडाच्या वेळी मजबूत क्षमता प्रदान करते, परंतु यामुळे अधिक स्टेट सिंक्रोनाइझेशन, पॉलिसी सुसंगतता आणि स्प्लिट-ब्रेनचा धोका निर्माण होतो. जेव्हा डाउनटाइम खूप महाग असतो आणि टीम दोन्ही बाजूंचे योग्यरित्या मॉनिटरिंग करू शकते तेव्हा याचा वापर करा.
Active-passive मध्ये एक स्टँडबाय घटक कार्यभार स्वीकारण्यासाठी तयार ठेवला जातो. ॲक्टिव्ह - ॲक्टिव्ह पेक्षा याबद्दल विचार करणे सोपे आहे, परंतु प्रमोशन, स्टेट ट्रान्सफर आणि दोष शोधणे यामुळे रिकव्हरीमध्ये अंतर निर्माण होऊ शकते. हॉट स्टँडबाय केवळ तेव्हाच उपयुक्त ठरतो जेव्हा त्यामध्ये चालू कॉन्फिगरेशन, पोहोचण्यायोग्य डिपेंडन्सी आणि चाचणी केलेली प्रमोशन प्रक्रिया असते.
N+1 क्लस्टरसाठी एक अतिरिक्त क्षमता युनिट प्रदान करते. जेव्हा एखादी साइट घटक बदलणे सहन करू शकते परंतु पूर्णपणे डुप्लिकेट केलेल्या वातावरणाचे समर्थन करू शकत नाही, तेव्हा हे एक समजूतदार उत्तर आहे. तरीही N+1 मुळे संपूर्ण व्यवस्था सामायिक बिघाडांच्या धोक्यात राहते, जसे की कॉमन पॉवर फीड, कॉमन अपलिंक किंवा प्रत्येक युनिटमध्ये प्रतिकृती बनवलेली खराब कॉन्फिगरेशन.
भौगोलिक रिडंडन्सी संपूर्ण सेवा क्षमता दुसऱ्या साइटवर किंवा प्रदेशात ठेवते. हे केवळ उपकरणांच्या बिघाडालाच नाही, तर संपूर्ण साइट गमावण्याच्या समस्येलाही संबोधित करते आणि यामध्ये सर्वाधिक भांडवली आणि कार्यात्मक खर्च येतो. हे एकाधिक मालमत्तांना समर्थन देणाऱ्या सामायिक सेवांसाठी किंवा एकाच इमारतीला अपयशी डोमेन (failure domain) म्हणून स्वीकारू न शकणाऱ्या संस्थांसाठी योग्य आहे.
Failover आर्किटेक्चरची तुलना
| आर्किटेक्चर | किंमत | जटिलता | ठराविक RTO | सर्वोत्तम तंदुरुस्त (Best Fit) |
|---|---|---|---|---|
| ॲक्टिव्ह-ॲक्टिव्ह (Active-active) | जास्त | जास्त | योग्यरित्या ऑपरेट केल्यावर अत्यंत कमी | गंभीर सेवा, मोठे इस्टेट्स, सिंक्रोनाइझ केलेल्या सिस्टम व्यवस्थापित करण्यास सक्षम असणारे संघ |
| ॲक्टिव्ह-पॅसिव्ह (Active-passive) | मध्यम ते जास्त | मध्यम | प्रमोशनवर अवलंबून, कमी ते मध्यम | दोन्ही बाजूंनी ट्रॅफिक न पाठवता तयार स्टँडबायची आवश्यकता असणारे साइट्स |
| N+1 | मध्यम | मध्यम | मध्यम, बदली आणि प्रोव्हिजनिंगवर अवलंबून | क्लस्टर्स जेथे एक घटक अयशस्वी पीअरची जागा घेऊ शकतो |
| भौगोलिक रिडंडन्सी (Geographic redundancy) | सर्वात जास्त | सर्वात जास्त | राउटिंग आणि स्थितीवर अवलंबून, कमी ते विस्तारित | मल्टी-साइट ऑपरेटर्स आणि संपूर्ण-साइट बिघाड होण्याचा धोका असलेल्या सेवा |
दोन मालमत्ता असलेला एखादा हॉटेल समूह साइट्स दरम्यान ॲक्टिव्ह - ॲक्टिव्ह सेवांचा वापर करू शकतो जर WAN, आयडेंटिटी, DNS, पॉवर आणि ऑपरेशनल मालकी खरोखरच स्वतंत्र असेल. एका रिटेल स्टोअरला चालवता न येणाऱ्या दुसऱ्या डेटा सेंटर डिझाइनपेक्षा रेझिलियंट फायरवॉल, सेगमेंट केलेले ट्रॅफिक आणि LTE किंवा 5G बॅकअपमधून सहसा अधिक मूल्य मिळते.
थेट निर्णय शॉर्टकट वापरा. जर कर्मचारी संसाधने मर्यादित असतील आणि व्यवसाय मोजक्या रिकव्हरीचा भार सहन करू शकत असेल, तर active-passive किंवा N+1 निवडा. जर गंभीर व्यवहारांना सातत्याची गरज असेल आणि टीम सिंक्रोनाइझेशन व्यवस्थापित करू शकत असेल, तर active-active निवडा. जर संपूर्ण साईट हे मुख्य संकट असेल, तर भौगोलिक रिडंडन्सी हा त्यावर उपाय आहे. जर बजेट कमी असेल, तर सर्वात जास्त दिसणाऱ्या उपकरणाची डुप्लिकेट प्रत खरेदी करण्याऐवजी व्यवसायाच्या प्रभावाच्या क्रमाने सिंगल-पाथ अवलंबित्वे काढून टाका.
लवचिक नेटवर्क, प्रमाणीकरण आणि ओळख स्तरांचे डिझाइन करणे
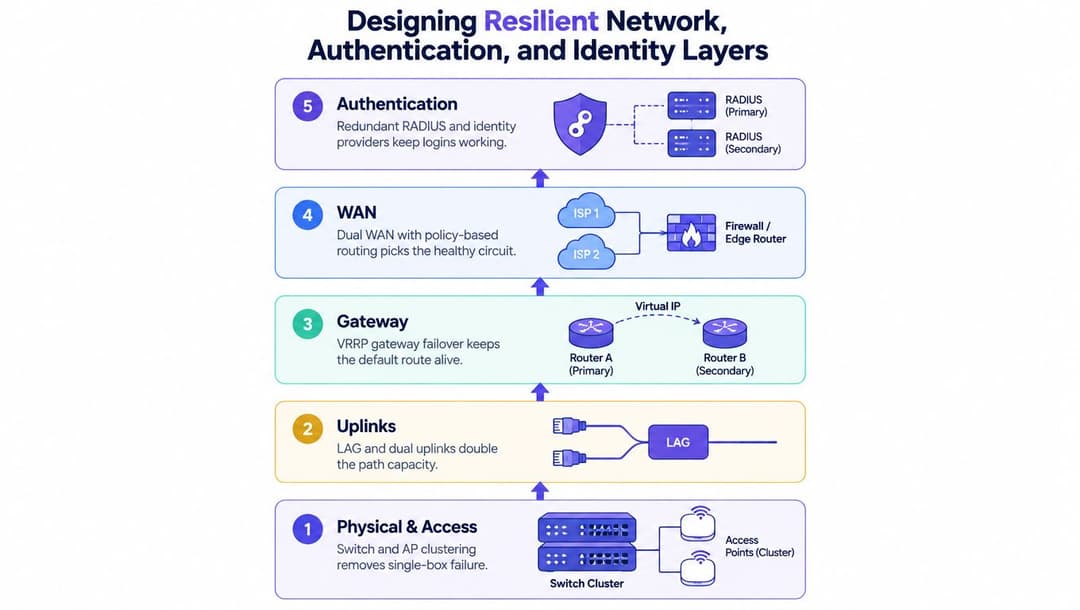
लवचिकता सर्वात कमकुवत अवलंबित्व असलेल्या ठिकाणी निकामी ठरते. भौतिक स्तरापासून सुरुवात करून वरच्या दिशेने स्टॅक तयार करा आणि प्रत्येक स्तराला एक स्वतंत्र failure domain नियुक्त करा.
ॲक्सेस आणि अपलिंक्सने सुरुवात करा
जिथे परिसराची आवश्यकता असेल तिथे स्विच आणि ॲक्सेस पॉइंट क्लस्टरिंगचा वापर करा, परंतु क्लस्टर सदस्यांचे एकच अपयशी डोमेन (failure domain) नसेल याची पडताळणी करा. एकाच रॅकमधील दोन स्विचेस तरीही एकाच पॉवर फीडवर अवलंबून असू शकतात. दोन अपलिंक्स अजूनही एकाच केबल ट्रेचे अनुसरण करू शकतात. लिंक एग्रीगेशन क्षमता आणि पाथ लवचिकता प्रदान करू शकते, तर ड्युअल अपलिंक्स एकाच पोर्ट, मॉड्युल किंवा केबलवरील अवलंबित्व कमी करतात.
गेटवेवर, VRRP किंवा तत्सम व्हर्च्युअल गेटवे मेकॅनिझम वापरा जेणेकरून डीफॉल्ट रूट डिव्हाइसेस दरम्यान फिरू शकेल. फ्लोटिंग गेटवे ॲक्टिव्ह सेशन्स जतन करतो असे गृहीत धरण्याऐवजी स्टेटफुल फायरवॉल फेलओव्हरची चाचणी घ्या. काही सेवा सुरळीतपणे पुन्हा कनेक्ट होतात. इतरांना स्पष्ट सेशन हाताळणीची आवश्यकता असते.
WAN लवचिकतेने केवळ लिंक स्थितीवर नव्हे तर आरोग्याची दखल घेणाऱ्या पॉलिसी-आधारित राउटिंगसह स्वतंत्र सर्किट्स एकत्र केले पाहिजेत. महत्त्वाच्या ॲप्लिकेशन्सचा मार्ग गमावूनही सर्किट इलेक्ट्रिकली चालू राहू शकते. LTE किंवा 5G व्यवस्थापनासाठी उपयुक्त आऊट-ऑफ-बँड प्रवेश आणि फॉलबॅक पाथ प्रदान करते, परंतु त्यासाठी स्वतःचे कव्हरेज, पॉवर, डेटा पॉलिसी आणि सुरक्षा नियंत्रणे असणे आवश्यक आहे.
DNS आणि पॉवरला प्रोडक्शन डिपेंडन्सी म्हणून विचारात घ्या
DNS हा वापरकर्त्याच्या प्रवासाचा एक भाग आहे. काळजीपूर्वक TTL व्यवस्थापन, दुय्यम रिझोल्यूशन क्षमता आणि स्प्लिट-होरायझन डिझाइन वापरा जिथे अंतर्गत आणि बाह्य उत्तरे भिन्न असणे आवश्यक आहे. केवळ रिझोल्व्हर प्रक्रिया प्रतिसाद देत आहे की नाही हे पाहण्याऐवजी रिझोल्यूशनची वेळ आणि बिघाड यावर लक्ष ठेवा.
पॉवरला देखील स्तरांची आवश्यकता असते. UPS संरक्षणासह वास्तववादी PoE बजेट, इमारत जेथे सपोर्ट करते तेथे स्वतंत्र फीड आणि नेटवर्क अवलंबित्व असलेल्या खोल्यांसाठी जनरेटर कव्हरेज एकत्र करा. निकामी बॅटरी असलेला UPS म्हणजे लवचिकता नव्हे. तसेच ॲक्सेस लेयरपर्यंत न पोहोचणारा जनरेटर देखील उपयुक्त नाही.
कनेक्टिव्हिटीइतक्याच काळजीपूर्वक ऑथेंटिकेशनचे रक्षण करा
RADIUS कडे स्वतंत्र सर्व्हिस इन्स्टन्स आणि चाचणी केलेली फेलओव्हर ऑर्डर असणे आवश्यक आहे. Captive Portal च्या वर्तनासाठी एक निश्चित डिग्रॅडेड मोड आवश्यक आहे. आधीच ऑथेंटिकेट झालेला युझर पुढे सुरू ठेवू शकतो का, नवीन युझर ही प्रक्रिया पूर्ण करू शकतो का, आणि आयडेंटिटी प्रोव्हायडरशी संपर्क न झाल्यास काय होते, हे तपासा.
कर्मचाऱ्यांच्या ॲक्सेससाठी, क्लाउड-मॅनेज्ड RADIUS सेवा एकाच ऑन-प्रिमाइसेस सर्व्हरवरील अवलंबित्व कमी करू शकते, परंतु तरीही यासाठी मल्टी-रीजन उपलब्धता, मॉनिटर केलेले एंडपॉइंट्स, चालू सर्टिफिकेट्स आणि स्पष्ट रिकव्हरी ओनरशिप आवश्यक आहे. ऑथेंटिकेशन लेयरला रेझिलियन्सच्या चर्चेत ठेवत नेटवर्क ॲक्सेसला डिरेक्टरी-आधारित ओळखीसह जोडण्यासाठी Purple ची Microsoft Entra ID RADIUS सेवा हा एक पर्याय आहे.
प्रत्येक लेयर स्वतंत्रपणे निकामी झाला पाहिजे. जर दोन्ही RADIUS नोड्स एकाच व्हर्च्युअल होस्टचा वापर करत असतील, दोन्ही DNS मार्ग एकाच रिझॉल्व्हरचा वापर करत असतील आणि दोन्ही WAN सर्किट्स एकाच डक्टमधून प्रवेश करत असतील, तर आकृती रिडंडंट दिसते परंतु तुमची व्यवस्था रिडंडंट नसते.
खरोखरच आउटेज शोधणाऱ्या चाचण्या, मॉनिटरिंग आणि रनबुक्स
कागदावरील आर्किटेक्चर म्हणजे प्रत्यक्षात उत्पादनातील आर्किटेक्चर नसते. फेलओव्हर मार्गाचे प्रमाणीकरण करण्याचा एकमेव विश्वासार्ह मार्ग म्हणजे नियंत्रित परिस्थितीमध्ये त्याची चाचणी घेणे, वापरकर्त्याच्या अनुभवाचे निरीक्षण करणे आणि जे बिघडले आहे ते दुरुस्त करणे.
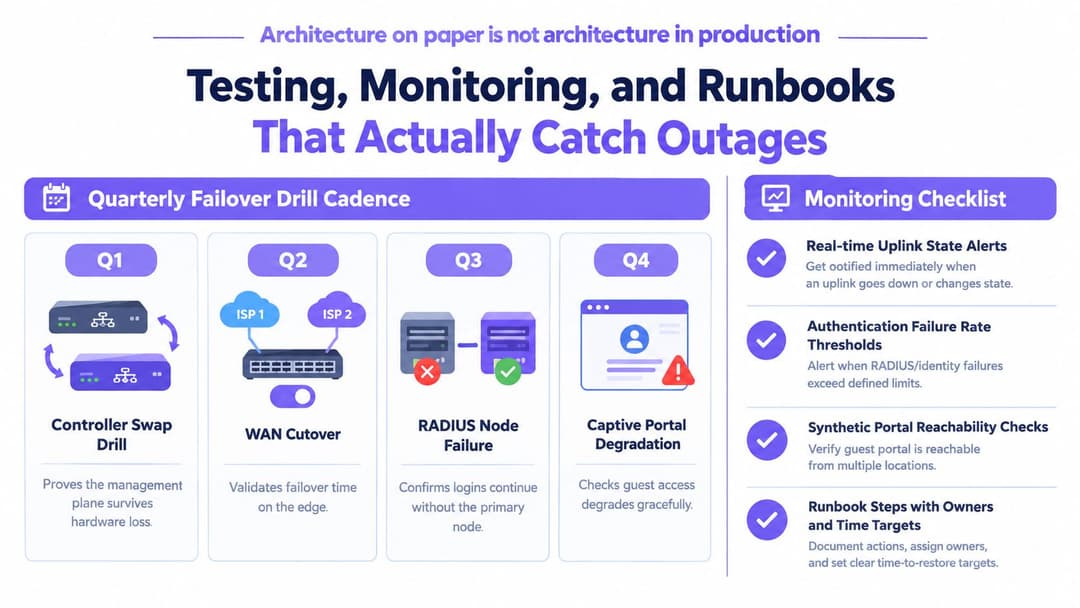
प्रत्येक सायकलमध्ये वेगवेगळ्या बिघाड केंद्रांवर लक्ष केंद्रित करून त्रैमासिक सराव कार्यक्रम चालवा:
- कंट्रोलर स्वॅप: प्रायमरी कंट्रोलर काढून टाकल्यानंतरही मॅनेजमेंट आणि वायरलेस सेवा सुरू राहते हे सिद्ध करा.
- WAN कटओव्हर: सर्किट डिटेक्शन, पॉलिसी राउटिंग, फायरवॉल स्टेट आणि ॲप्लिकेशन पोहोचण्याची क्षमता यांचे प्रमाणीकरण करा.
- RADIUS नोड निकामी होणे: नवीन लॉगिन आणि पुन्हा होणारे ऑथेंटिकेशन हे दुय्यम सेवा वापरतात याची खात्री करा.
- Captive Portal डिग्रेडेशन: गेस्ट ॲक्सेस सुरक्षितपणे बंद होतो आणि सध्याच्या युजर्सना अपेक्षित अनुभव मिळतो की नाही हे तपासा.
नियंत्रित गोंधळ हा केवळ कागदावर सराव करण्यापेक्षा नेहमीच सरस ठरतो. कमी-जोखमीच्या रात्री, मान्यताप्राप्त बदल नोंदीसह एक स्विच स्टॅक डिस्कनेक्ट करा, WAN पाथ बंद करा किंवा RADIUS नोड वेगळा करा. चाचणी मर्यादित ठेवा, रोलबॅक निश्चित करा आणि केवळ मॉनिटरिंग डॅशबोर्ड पाहण्याऐवजी सर्व्हिस ओनरला व्यावसायिक परिणामाचे निरीक्षण करू द्या.
डिव्हाइसच्या बाह्य स्वरूपावर नव्हे, तर लक्षणांवर लक्ष ठेवा
उपयुक्त संकेतांमध्ये खालील गोष्टींचा समावेश होतो:
- कंट्रोलर रीचेबिलिटी आणि क्लस्टर स्टेट.
- RADIUS रिस्पॉन्स लॅटन्सी आणि ऑथेंटिकेशन फेल्युअर रेट.
- DNS रिझोल्यूशन वेळ आणि अयशस्वी लुकअप्स.
- ॲक्सेस पॉईंट जॉइन स्टेट आणि क्लायंट रिॲसोसिएशन.
- अपलिंक युटिलायझेशन, एरर्स आणि पाथ बदल.
- सिंथेटिक कॅप्टिव्ह पोर्टल (captive portal) रीचेबिलिटी.
- केवळ इंटरफेस स्टेटसवर नव्हे, तर ॲप्लिकेशन प्रोब्जवर आधारित WAN हेल्थ.
ग्राहकांवर होणाऱ्या परिणामांभोवती अलर्ट थ्रेशोल्ड सेट करा. प्रमाणीकरण अपयशात झालेली किरकोळ वाढ, युजर्सनी हेल्प डेस्कला कॉल करण्यापूर्वीच आयडेंटिटी आउटेज दर्शवू शकते. सातत्याने पूर्ण क्षमतेने चालणारी अपलिंक ही बिघडलेल्या failover ची पूर्वगामी असू शकते. प्रत्येक तात्पुरत्या घटनेसाठी इंजिनिअर्सना पेज करू नका. जेव्हा अनेक सिग्नल्स एकत्र येऊन सेवेच्या समस्येचे लक्षण बनतात, तेव्हा त्यांना नक्की पेज करा.
रनबुकमध्ये निर्णय वृक्ष (decision tree), नियुक्त एस्केलेशन मालक, विक्रेता संपर्क क्रम, प्रवेश आवश्यकता, रोलबॅक पायऱ्या आणि सेवा RTO शी जोडलेले वेळेचे उद्दिष्ट असले पाहिजेत. योग्य ठिकाणी स्क्रीनशॉट किंवा अचूक कन्सोल स्थाने समाविष्ट करा, परंतु केवळ मौखिक माहितीवर अवलंबून राहू नका. प्रत्येक सराव तालीम नंतर, शोध वेळ, निर्णय वेळ, रिकव्हरी वेळ, वापरकर्त्यावरील प्रभाव आणि आवश्यक बदल नोंदवा.
Purple WiFi लेटन्सी आणि जिटर चाचणी नेटवर्क गुणवत्तेच्या व्यावहारिक पडताळणीला सपोर्ट करू शकते, परंतु कोणतीही चाचणी प्रत्यक्ष फेलओव्हर सरावाची जागा घेऊ शकत नाही. जर तुम्ही जाणीवपूर्वक एखाद्या अवलंबित्वाची चाचणी घेतली नसेल, तर तुम्ही त्याची पडताळणी केलेली नाही.
हॉस्पिटॅलिटी, रिटेल, हेल्थकेअर आणि मल्टी-टॅनंट WiFi साठी क्षेत्र-विशिष्ट विचार
समान लवचिकता आराखड्याला वेगवेगळ्या वातावरणात वेगवेगळ्या प्राधान्यांची आवश्यकता असते. सेवांची क्रमवारी लावून सुरुवात करा, नंतर सर्वाधिक मूल्याच्या वापरकर्त्याच्या प्रवासाचे रक्षण करणारे ओळख आणि नेटवर्क नियंत्रणे निवडा.
| क्षेत्र | टियर-1 सेवा | शिफारस केलेले फेलओव्हर धोरण | महत्त्वाचा ओळख आणि नेटवर्क धोका |
|---|---|---|---|
| हॉस्पिटॅलिटी | अतिथी प्रमाणीकरण, पेमेंट ॲक्सेस, मालमत्ता प्रणाली, कर्मचारी कनेक्टिव्हिटी | दुहेरी WAN, लवचिक RADIUS, चाचणी केलेली Captive Portal पुनर्प्राप्ती, सुरक्षित वीज पुरवठा | सामायिक अतिथी लॉगिन किंवा पोर्टल अवलंबित्व चेक-इन आणि सेवा वितरणात व्यत्यय आणू शकते |
| रिटेल | POS ट्रॅफिक, पेमेंट सेवा, स्टोअर ऑपरेशन्स, कर्मचारी ॲक्सेस | विभक्त VLANs, लवचिक एज, LTE किंवा 5G बॅकअप, चाचणी केलेले सर्किट कटओव्हर | पेमेंट आणि ऑपरेशनल ट्रॅफिक कठोर विभाजनाशिवाय अतिथी ॲक्सेसशी स्पर्धा करू शकते |
| आरोग्य सेवा | क्लिनिकल WiFi, इलेक्ट्रॉनिक रेकॉर्ड, टेलिमेट्री, मंजूर BYOD | बॅटरी-बॅकअप असलेले नेटवर्क लेयर्स, लवचिक ओळख, नियंत्रित एन्क्रिप्शन पुनर्प्राप्ती, ऑडिट-रेडी बदल | प्रमाणीकरण किंवा वीज पुरवठा खंडित झाल्यास क्लिनिकल वर्कफ्लोमध्ये अडथळा येऊ शकतो आणि सुरक्षा जोखीम निर्माण होऊ शकते |
| मल्टी-टेनंट ठिकाणे | भाडेकरू ॲक्सेस, सामायिक क्षेत्रातील WiFi, इमारत ऑपरेशन्स, कर्मचारी सेवा | विभक्त SSIDs, भाडेकरू-अनुकूल पॉलिसी, स्वतंत्र प्रमाणीकरण डोमेन, विविध मार्ग | एका ऑपरेटरची ओळख, DNS, किंवा पॉलिसी अपयश इतर भाडेकरूंवर परिणाम करू शकते |
हॉस्पिटॅलिटी ऑपरेटर्सनी गेस्ट WiFi कडे केवळ सौजन्य सेवा म्हणून न पाहता एक ऑपरेशनल आणि व्यावसायिक चॅनेल म्हणून पाहिले पाहिजे. रिटेल टीम्सनी पेमेंट पाथ्स गेस्ट ट्रॅफिकपासून वेगळे ठेवले पाहिजेत आणि बॅकअप सर्किट प्रत्यक्ष व्यवहार प्रवासाला सपोर्ट करते की नाही हे तपासले पाहिजे. हेल्थकेअर ॲडमिनिस्ट्रेटर्सना ऑडिटमध्ये टिकून राहतील अशा चेंज रेकॉर्ड्सची आवश्यकता असते, तसेच बॅटरी-बॅकअप असलेले उपकरण क्लिनिशियन्स वापरत असलेल्या ॲक्सेस पाथला कव्हर करते की नाही हे तपासणे आवश्यक असते.
स्टेडियम, निवासी इमारती, कोवर्किंग जागा आणि इतर बहु-भाडेकरू ठिकाणांसाठी (multi-tenant venues), विभागणी प्रमाणीकरण (authentication) आणि DNS मध्ये देखील असणे आवश्यक आहे. जर पॉलिसी, ओळख शोध (identity lookups) किंवा व्यवस्थापन मार्ग सामायिक राहिले, तर केवळ वेगळे SSIDs भाडेकरूंच्या अलगावची (tenant isolation) हमी देत नाहीत.
एक समजूतदार पहिले पाऊल म्हणजे ३०-दिवसांची पायलट इन्व्हेंटरी (30-day pilot inventory). एका प्रातिनिधिक मालमत्तेवर किंवा ठिकाणावर ॲक्सेस पॉइंट्स, स्विचेस, कंट्रोलर्स, WAN सर्किट्स, आयडेंटिटी सर्व्हिसेस, DNS, पॉवर आणि मालक यांची कॅटलॉग सूची तयार करा. त्यानंतर क्षेत्रासाठी एक स्तरित SLA मॅप तयार करा, एक नियंत्रित फेलओव्हर चालवा आणि पुढील जोखीम कमी करण्यासाठी निधी मिळवण्यासाठी या निकालांचा वापर करा. सध्याच्या वर्कफोर्स प्लॅनिंगच्या दबावामुळे मनुष्यबळ-जोखमीचा दृष्टिकोन देखील महत्त्वाचा बनतो. CIPD लेबर मार्केट आउटलुक फॉर समर २०२६ ने नोंदवले की २१% UK नियोक्त्यांनी सप्टेंबर २०२६ पर्यंतच्या तीन महिन्यांत कर्मचारी कपात करण्याची योजना आखली होती. कमी लोकांचा अर्थ दस्तऐवजीकरण नसलेल्या रिकव्हरी कामासाठी कमी सहनशीलता असा आहे, म्हणून पुढील कर्मचारी बदलापूर्वी रनबुक्स आणि मालकी डिझाइन करा.
UK च्या सामूहिक कर्मचारी कपातीची कर्तव्ये देखील विखुरलेल्या मालमत्तांना वेळेची आणि डेटाची समस्या बनवतात. कर्मचारी कपात सल्लामसलतीवरील सरकारी मार्गदर्शन सांगते की २० किंवा त्याहून अधिक जणांची मर्यादा ९० दिवसांच्या आत एका आस्थापनेवर लागू होते, ज्यामध्ये अधिसूचनेची वेळ प्रस्तावित बडतर्फीच्या श्रेणीशी जोडलेली असते. नेटवर्क लीडर्ससाठी, यासारखा धडा म्हणजे साइट्स आणि अवलंबित्व अचूकपणे मॅप करणे हा आहे. एक मल्टी-साइट मालमत्ता सुरक्षितपणे असे गृहीत धरू शकत नाही की स्वतंत्र इमारती, सर्किट्स किंवा टीम्स ट्रॅफिक, आयडेंटिटी आणि ऑपरेशन्स कसे कनेक्ट होतात हे सिद्ध केल्याशिवाय स्वतंत्र फेल्युअर डोमेन तयार करतात.
Purple क्लाउड-व्यवस्थापित WiFi ऑथेंटिकेशन आणि आयडेंटिटी-आधारित ॲक्सेस प्रदान करते, ज्यामध्ये रिडंडंट सर्व्हिस पाथसह डिझाइन केलेली RADIUS क्षमता समाविष्ट आहे, जेणेकरून ते गेस्ट लॉगिनला एक लपलेले सिंगल पॉईंट ऑफ फेल्युअर म्हणून सोडण्याऐवजी लवचिकता आराखड्याचा (resilience blueprint) भाग बनू शकते. Purple तुमच्या नेटवर्क, आयडेंटिटी आणि फेलओव्हर आवश्यकतांशी कसे जुळते याचे पुनरावलोकन करा, त्यानंतर प्रॉपर्टी-पातळीवरील इन्व्हेंटरी आणि नियंत्रित ऑथेंटिकेशन सरावासह सुरुवात करा.