Un hotel pierde el acceso a Internet durante el registro de entrada. Los huéspedes no pueden autenticarse en el WiFi, las terminales de tarjetas comienzan a agotar el tiempo de espera, el personal pierde el acceso a los sistemas en la nube y la recepción comienza a entregar una contraseña compartida que nadie puede revocar. El circuito de respaldo existe, pero la política del firewall nunca se probó. El segundo servidor RADIUS está configurado, pero nadie sabe si los puntos de acceso lo alcanzarán. El UPS informa un estado saludable porque nadie ha probado la batería bajo carga.
Eso no es un problema de hardware. Es una falla en la planificación de redundancia.
La resiliencia de la red significa mantener disponibles la autenticación, la conectividad y los servicios esenciales cuando falla un componente, un enlace, un sitio, una alimentación eléctrica o una dependencia de identidad. Un switch de repuesto en un armario no genera resiliencia. Una ruta probada que mantiene funcionando una VLAN de pago, una aplicación médica, el inicio de sesión del personal o una sesión de WiFi para invitados, sí lo hace.
Lo que la planificación de redundancia realmente significa para las redes modernas
La planificación de la redundancia de red es una disciplina de continuidad de negocio, no un ejercicio de compra de equipos. La pregunta no es si usted posee dos switches. Es si los usuarios aún pueden conectarse, autenticarse, resolver servicios y acceder a las aplicaciones que mantienen la operación en funcionamiento después de una falla definida.
Eso requiere una visión clara de los dominios de falla. Un dominio de falla es un componente o dependencia que puede fallar de forma independiente y afectar el servicio. Los dominios típicos incluyen:
- Infraestructura de acceso, incluidos switches, puntos de acceso, presupuestos PoE, uplinks y controladores inalámbricos.
- Servicios de identidad, incluidos RADIUS, integraciones de directorios, certificados, Captive Portals y proveedores de identidad.
- Servicios principales, incluidos DHCP, DNS, funciones de gateway y políticas de red.
- Rutas externas, incluidos circuitos WAN, equipos ISP, plataformas en la nube y servicios de autenticación de terceros.
- Instalaciones, incluida la distribución de energía, baterías UPS, cobertura de generadores y cuartos de racks de distribución intermedia.
Un diseño puede tener enrutadores centrales resilientes y aún así fallar en el extremo. Si la resolución de DNS se detiene, los usuarios pueden estar conectados a WiFi pero sin poder acceder a los servicios que necesitan. Si RADIUS deja de responder, una red inalámbrica en buen estado puede rechazar cada inicio de sesión de empleados o invitados. Si el Captive Portal depende de una ruta de nube inalcanzable, el sitio puede tener cobertura de radio sin un acceso de invitados utilizable.
Separe la continuidad del servicio de la redundancia de componentes
Comience con los servicios, no con los dispositivos. Escriba los servicios que la empresa debe preservar y luego rastree cada dependencia debajo de cada uno. La autenticación de WiFi para invitados, por ejemplo, puede depender de los puntos de acceso, el switching, el PoE, el plano de control inalámbrico, el DHCP, el DNS, el acceso WAN, el RADIUS, el proveedor de identidad y el portal mismo.
Una referencia útil de planificación de WiFi para equipos de TI debería llevar a la misma conclusión: el acceso inalámbrico es un sistema operativo, no una capa de radio acoplada a la LAN.
Los empleadores del Reino Unido utilizan un significado legal diferente para la planificación de despidos colectivos. Cuando un empleador propone despedir a 20 o más empleados en un establecimiento dentro de un período continuo de 90 días, se aplica la consulta colectiva, comenzando la consulta al menos 30 días antes del primer despido para 20 a 99 despidos o 45 días antes del primer despido para 100 o más. La guía de consulta del gobierno del Reino Unido explica que la consulta debe abordar los motivos de los despidos propuestos, las formas de evitarlos y las formas de reducir el número de despidos. Ese es un marco de planificación de recursos humanos. La disciplina de red descrita aquí se refiere a fallas del servicio, mapeo de dependencias y arquitectura de recuperación.
Regla práctica: No cuente los dispositivos de respaldo. Cuente las rutas independientes desde el usuario hasta el servicio.
El resto de esta guía utiliza esa perspectiva práctica. Identifique los riesgos de falla, establezca objetivos de recuperación que reflejen el impacto comercial, seleccione una arquitectura que su equipo pueda operar, proteja cada capa desde la energía hasta la identidad y pruebe el resultado bajo condiciones controladas. Si un componente nunca ha fallado en un simulacro, considere su redundancia como una suposición, no como una capacidad.
Mapeo de riesgos de falla antes de diseñar la solución
La mayoría de los equipos de red no necesitan una plataforma de gobernanza para encontrar sus puntos únicos de falla más peligrosos. Necesitan un registro breve que nombre el riesgo, lo clasifique de manera consistente, asigne un propietario y registre si alguien lo ha mitigado.
Utilice tres ejes:
- Probabilidad, que significa con qué frecuencia ocurre la falla en entornos comparables o ha ocurrido en su propio entorno.
- Radio de impacto, que significa cuántos usuarios, sitios, servicios o actividades generadoras de ingresos dejan de estar disponibles.
- Dificultad de recuperación, que significa qué tan difícil es la restauración con las habilidades, el acceso, los repuestos, el soporte del proveedor y la documentación que tiene hoy.
Califique cada eje en una escala local, luego multiplique los tres valores o aplique una fórmula ponderada. Las matemáticas importan menos que la consistencia. Un solo circuito WAN debe clasificarse por encima de una pantalla de marketing aislada porque su falla puede afectar a todos los servicios dependientes a la vez.
Construya el registro en torno a dependencias reales
Incluya los activos que los equipos suelen pasar por alto. Un primer análisis útil debería contener:
- Un solo ISP WAN o circuito que atiende a todo el recinto.
- Un solo servicio RADIUS o una sola integración de proveedor de identidad.
- Una sola ruta de resolución DNS.
- Un solo controlador inalámbrico o dependencia de gestión en la nube.
- Una sala de distribución intermedia sin cobertura de generador.
- Baterías de UPS que informan su estado pero que nunca se han probado bajo una carga significativa.
- Un Captive Portal sin un modo degradado documentado.
- Un switch stack cuyos enlaces ascendentes comparten una sola ruta física.
- Un servicio DHCP sin un procedimiento de recuperación probado.
El registro también debe incluir al propietario del servicio, el propietario técnico, la fecha de la última falla, la mitigación actual, la fecha de la prueba y la siguiente acción. "Equipo de red" no es un propietario. Nombre a la persona o equipo responsable de programar el cambio y demostrar que funciona.
Puntuación de muestra para el registro de riesgos de red
La siguiente es una plantilla de trabajo, no una afirmación sobre ninguna infraestructura en particular. Utilice una escala local consistente para cada eje y calcule la puntuación final de la misma manera para cada registro.
| Escenario de falla | Probabilidad (1-5) | Radio de impacto (1-5) | Dificultad de recuperación (1-5) | Puntaje de riesgo |
|---|---|---|---|---|
| Circuito WAN único | Evaluar localmente | Evaluar localmente | Evaluar localmente | Probabilidad × radio de impacto × dificultad de recuperación |
| Servicio RADIUS único | Evaluar localmente | Evaluar localmente | Evaluar localmente | Probabilidad × radio de impacto × dificultad de recuperación |
| Ruta única del solucionador DNS | Evaluar localmente | Evaluar localmente | Evaluar localmente | Probabilidad × radio de impacto × dificultad de recuperación |
| Controlador inalámbrico único | Evaluar localmente | Evaluar localmente | Evaluar localmente | Probabilidad × radio de impacto × dificultad de recuperación |
| Cuarto de IDF sin generador | Evaluar localmente | Evaluar localmente | Evaluar localmente | Probabilidad × radio de impacto × dificultad de recuperación |
| Baterías de UPS sin monitorear | Evaluar localmente | Evaluar localmente | Evaluar localmente | Probabilidad × radio de impacto × dificultad de recuperación |
No espere a tener un registro perfecto. Una lista de una página con propietarios creíbles es más útil que un sistema de riesgos sofisticado que nadie actualiza. El objetivo inmediato es la priorización. Clasifique las fallas que pueden deshabilitar servicios críticos y luego use esos resultados para establecer objetivos de recuperación y elegir la arquitectura.
La información oficial de gestión del Reino Unido muestra por qué es importante la planeación avanzada y estructurada en un contexto laboral diferente pero relacionado. Los empleadores presentaron 368 formularios HR1 que cubrían 29,496 posibles despidos en enero de 2020, y 326 formularios que cubrían 27,804 posibles despidos en febrero de 2020, de acuerdo con los datos de notificación de despidos del gobierno. La lección para los líderes de red es directa: la planeación formal existe porque los grandes cambios operativos son difíciles de improvisar. Lo mismo se aplica cuando una red de múltiples sitios pierde una dependencia compartida.
Definición de objetivos de RTO y RPO que coincidan con el impacto real del negocio
El RTO y el RPO solo son útiles cuando los líderes del negocio pueden comprenderlos.
El objetivo de tiempo de recuperación, o RTO, es el tiempo máximo aceptable que un servicio puede permanecer no disponible. El objetivo de punto de recuperación, o RPO, es la pérdida máxima aceptable de datos, configuración o estado de la sesión desde el último punto recuperable. Para una red, el RPO puede referirse a la configuración, la política, el estado del dispositivo, los registros de eventos o el contexto de autenticación activa, en lugar de una transacción de base de datos tradicional.
Traduzca ambas medidas en consecuencias operativas. Pregunte qué es lo primero que se detiene cuando el servicio falla. ¿La recepción acumula filas de invitados? ¿Las cajas registradoras dejan de aceptar pagos? ¿Los médicos pierden el acceso a los expedientes electrónicos? ¿El administrador de una propiedad pierde el control de acceso de los inquilinos? El propietario del servicio debe indicar la consecuencia comercial, no solo repetir un objetivo de TI.
Utilice niveles de servicio en lugar de una única promesa para todo el entorno
Un mapa de servicios práctico separa el acceso crítico de los servicios que pueden esperar.
| Nivel de Servicio | Ejemplo de Servicios | RTO Objetivo | RPO Objetivo | Implicación de Arquitectura |
|---|---|---|---|---|
| Nivel 1 | Autenticación de WiFi de invitados, VLAN de pago, acceso a aplicaciones clínicas | Minutos, según la tolerancia del negocio | Pérdida mínima de políticas y estado de autenticación | Rutas independientes, failover rápido, identidad resiliente, energía probada |
| Nivel 2 | WiFi para el personal, sistemas de back-office, sincronización de analíticas | Alrededor de una hora, cuando la operación lo permita | Configuración reciente y estado del servicio | Standby cálido, rutas dobles donde se justifique, recuperación documentada |
| Nivel 3 | Entretenimiento para invitados, páginas de inicio de marketing, reportes no críticos | Varias horas pueden ser aceptables | La recuperación basada en copias de seguridad puede ser suficiente | Standby de menor costo o restauración manual |
Estos son ejemplos de planificación, no niveles de servicio universales. Finanzas debe validar el objetivo utilizando un modelo de pérdida simple: contribución de ingresos por hora estimada, interrupción operativa, exposición de reputación e impacto de cumplimiento, dividido por el tiempo de inactividad que la empresa puede aceptar. Evite la precisión falsa. Un servicio de pago puede no tener una "hora promedio" significativa porque una interrupción breve durante una ventana comercial de gran actividad puede perjudicar más que una interrupción más larga durante la noche.
El RTO también debe incluir el tiempo de detección y decisión. Un failover que se completa rápidamente después de que un ingeniero nota la falla aún puede no cumplir con el objetivo comercial si el monitoreo tarda demasiado en emitir una alerta. Incluya el comportamiento de propagación de DNS, la autenticación de sesión, la reconexión de dispositivos, la convergencia del firewall y el escalamiento humano en la estimación de recuperación.
El RPO merece la misma disciplina. Si un cambio de configuración realizado poco antes de la falla desaparece, ¿puede el equipo volver a crearlo? Si las sesiones de invitados deben volver a autenticarse, ¿es eso aceptable? Si un directorio de identidad no está disponible temporalmente, ¿puede la capa de acceso utilizar una política de estado correcto conocido sin debilitar la seguridad?
Los objetivos de RTO agresivos generalmente requieren una capacidad activo-activo o geográficamente independiente. Un RTO más flexible puede admitir un estado de espera pasiva, una restauración documentada o una recuperación basada en respaldos. No copie un nivel de servicio empresarial de un contrato cuando el sitio todavía dependa de un solo ISP, una sola alimentación eléctrica o una sola ruta de identidad. La arquitectura tiene que ganarse el objetivo.
Cómo elegir la arquitectura de failover adecuada para su infraestructura
Cuatro patrones cubren la mayoría de las implementaciones en recintos del mundo real. Ninguno es correcto por defecto. La elección adecuada depende de la tolerancia al tiempo de inactividad, el tamaño de la infraestructura, la capacidad operativa, la independencia de fallas y el presupuesto.
Activo-activo mantiene dos o más componentes con capacidad atendiendo tráfico al mismo tiempo. Los controladores duales o los clústeres de acceso pueden compartir la demanda, y un lado puede continuar cuando el otro falla. Esto brinda una gran capacidad durante una falla, pero genera una mayor sincronización de estados, consistencia en las políticas y riesgo de cerebro dividido. Utilícelo cuando el tiempo de inactividad sea costoso y el equipo pueda monitorear ambos lados de manera adecuada.
Activo-pasivo mantiene un componente de respaldo listo para asumir el control. Es más fácil de entender que el activo-activo, pero la promoción, la transferencia de estado y la detección pueden generar una brecha de recuperación. Un respaldo en caliente es valioso solo si cuenta con la configuración actual, dependencias alcanzables y un proceso de promoción probado.
N+1 proporciona una unidad de capacidad de repuesto para un clúster. Es una respuesta sensata cuando un sitio puede tolerar el reemplazo de un componente pero no puede justificar un entorno completamente duplicado. N+1 todavía deja a la infraestructura expuesta a fallas compartidas, como una alimentación eléctrica común, un enlace ascendente común o una mala configuración replicada en cada unidad.
La redundancia geográfica ubica una capacidad de servicio completa en otro sitio o región. Resuelve la pérdida del sitio, no solo la falla del equipo, y conlleva la mayor carga operativa y de capital. Es adecuada para servicios compartidos que respaldan múltiples propiedades o para organizaciones que no pueden aceptar un solo edificio como dominio de falla.
Comparación de arquitecturas de failover
| Arquitectura | Costo | Complejidad | RTO Típico | Mejor Opción |
|---|---|---|---|---|
| Activo-activo | Alto | Alto | Muy corto cuando se opera correctamente | Servicios críticos, propiedades más grandes, equipos capaces de gestionar sistemas sincronizados |
| Activo-pasivo | Medio a alto | Medio | Corto a moderado, según la promoción | Sitios que necesitan un standby listo sin servir tráfico en ambos lados |
| N+1 | Medio | Medio | Moderado, según el reemplazo y aprovisionamiento | Clústeres donde un componente puede cubrir a un par con fallas |
| Redundancia geográfica | El más alto | La más alta | Corto a extendido, según el enrutamiento y el estado | Operadores multi-sitio y servicios expuestos a fallas completas del sitio |
Un grupo hotelero con dos propiedades puede utilizar servicios activo-activo entre sitios si la WAN, la identidad, el DNS, la energía y la propiedad operativa son genuinamente independientes. Una sola tienda minorista suele obtener más valor de un firewall resiliente, tráfico segmentado y respaldo LTE o 5G que de un diseño de segundo centro de datos que no puede operar.
Use un acceso directo de decisión. Si los recursos de personal son limitados y la empresa puede tolerar una recuperación moderada, elija activo-pasivo o N+1. Si las transacciones críticas necesitan continuidad y el equipo puede gestionar la sincronización, elija activo-activo. Si todo un sitio es el riesgo dominante, la redundancia geográfica es la respuesta. Si el presupuesto es ajustado, elimine las dependencias de una sola ruta en orden de impacto comercial en lugar de comprar un duplicado del dispositivo más visible.
Diseño de capas de red, autenticación e identidad resilientes
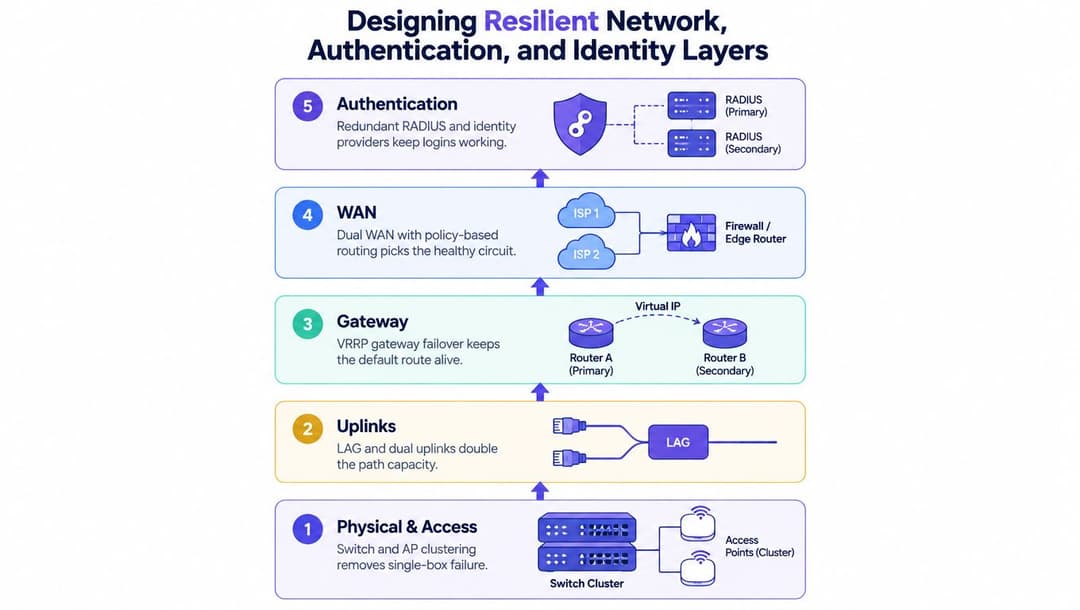
La resiliencia falla en la dependencia más débil. Diseñe el ecosistema desde la capa física hacia arriba y asigne a cada capa un dominio de falla independiente.
Comience con el acceso y los enlaces ascendentes
Utilice la agrupación de switches y puntos de acceso donde el sitio lo requiera, pero verifique que los miembros del clúster no compartan un único dominio de falla. Dos switches en el mismo rack aún pueden depender de una sola alimentación eléctrica. Dos enlaces de subida aún pueden seguir una misma bandeja de cables. La agregación de enlaces puede proporcionar capacidad y resiliencia de ruta, mientras que los enlaces de subida duales reducen la dependencia de un solo puerto, módulo o cable.
En el gateway, utilice VRRP o un mecanismo de gateway virtual equivalente para que la ruta predeterminada pueda moverse entre dispositivos. Pruebe el failover de firewall con estado en lugar de asumir que un gateway flotante preserva las sesiones activas. Algunos servicios se reconectan sin problemas. Otros requieren un manejo de sesión explícito.
La resiliencia de WAN debe combinar circuitos separados con un enrutamiento basado en políticas que reconozca el estado de salud, no simplemente el estado del enlace. Un circuito puede permanecer eléctricamente activo mientras pierde la ruta hacia las aplicaciones importantes. LTE o 5G proporciona un acceso fuera de banda útil para la gestión y una ruta de respaldo, pero necesita su propia cobertura, energía, política de datos y controles de seguridad.
Trate el DNS y la energía como dependencias de producción
El DNS es parte de la experiencia del usuario. Utilice una gestión de TTL deliberada, capacidad de resolución secundaria y un diseño de horizonte dividido (split-horizon) cuando las respuestas internas y externas deban diferir. Supervise el tiempo de resolución y las fallas, no solo si el proceso del sistema de resolución responde.
La energía también necesita capas. Combine la protección de UPS con un presupuesto de PoE realista, fuentes de alimentación independientes donde el edificio las soporte y cobertura de generador para las salas que alojan dependencias de red. Un UPS con una batería dañada no es resiliencia. Tampoco lo es un generador que no llega a la capa de acceso.
Proteja la autenticación con el mismo cuidado que la conectividad
RADIUS debe tener instancias de servicio independientes y un orden de failover probado. El comportamiento del Captive Portal necesita un modo degradado definido. Pregunte si un usuario que ya se ha autenticado puede continuar, si un nuevo usuario puede completar el proceso de conexión y qué sucede cuando el proveedor de identidad no está disponible.
Para el acceso del personal, un servicio RADIUS gestionado en la nube puede reducir la dependencia de un solo servidor local, pero aún requiere disponibilidad en múltiples regiones, puntos finales monitoreados, certificados vigentes y una propiedad clara de la recuperación. El servicio RADIUS Entra ID de Purple es una opción para conectar el acceso a la red con la identidad basada en el directorio, manteniendo la capa de autenticación dentro de la conversación sobre resiliencia.
Cada capa debe fallar de manera independiente. Si ambos nodos RADIUS utilizan el mismo host virtual, ambas rutas de DNS utilizan el mismo resolutor y ambos circuitos WAN ingresan por el mismo conducto, el diagrama es redundante pero la infraestructura no lo es.
Pruebas, monitoreo y manuales de procedimientos que realmente detectan interrupciones
La arquitectura en papel no es la arquitectura en producción. La única forma confiable de validar una ruta de failover es ponerla a prueba bajo condiciones controladas, observar la experiencia del usuario y corregir lo que falle.
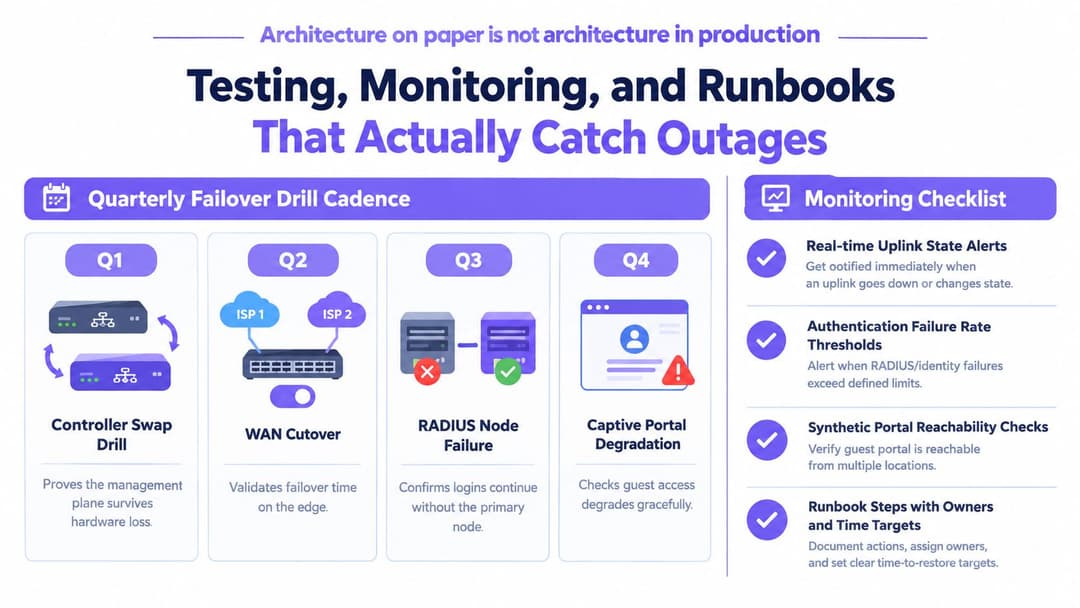
Ejecute un programa de simulacros trimestrales con un enfoque de falla diferente en cada ciclo:
- Intercambio de controlador: Demuestre que la gestión y el servicio inalámbrico continúan después de retirar el controlador principal.
- Conmutación de WAN: Valide la detección de circuitos, el enrutamiento de políticas, el estado del firewall y la accesibilidad de las aplicaciones.
- Falla de nodo RADIUS: Confirme que los nuevos inicios de sesión y la reautenticación utilicen el servicio secundario.
- Degradación del Captive Portal: Verifique que el acceso de invitados falle de manera segura y que los usuarios existentes reciban la experiencia prevista.
El caos controlado supera a un ejercicio de simulacro. En una noche de bajo riesgo, desconecte un apilamiento de switches, deshabilite una ruta WAN o aísle un nodo RADIUS con un registro de cambios aprobado. Mantenga la prueba acotada, defina un plan de reversión y haga que el propietario del servicio observe el resultado comercial en lugar de solo el tablero de monitoreo.
Monitoree los síntomas, no la vanidad de los dispositivos
Las señales útiles incluyen:
- Accesibilidad del controlador y estado del clúster.
- Latencia de respuesta de RADIUS y tasa de fallas de autenticación.
- Tiempo de resolución de DNS y búsquedas fallidas.
- Estado de unión del punto de acceso y reasociación del cliente.
- Utilización del enlace ascendente, errores y cambios de ruta.
- Accesibilidad sintética del Captive Portal.
- Salud de la WAN basada en sondeos de aplicaciones, no solo en el estado de la interfaz.
Establezca umbrales de alerta en función del impacto en el cliente. Un pequeño aumento en las fallas de autenticación puede indicar una interrupción de la identidad antes de que los usuarios llamen a la mesa de ayuda. Un enlace ascendente con capacidad sostenida puede ser el precursor de un failover degradado. No envíe alertas a los ingenieros por cada evento transitorio. Hágalo cuando varias señales se combinen en un síntoma del servicio.
Un manual de procedimientos debe contener un árbol de decisiones, propietarios de escalación asignados, orden de contacto de proveedores, requisitos de acceso, pasos de reversión y objetivos de tiempo vinculados al RTO del servicio. Incluya capturas de pantalla o ubicaciones exactas de la consola donde sea apropiado, pero no dependa del conocimiento informal. Después de cada simulacro, registre el tiempo de detección, el tiempo de decisión, el tiempo de recuperación, el impacto en el usuario y el cambio requerido.
La prueba de latencia y jitter de Purple WiFi puede respaldar la validación práctica de la calidad de la red, pero ninguna prueba reemplaza un ejercicio de failover real. Si no ha provocado la falla de una dependencia a propósito, no la ha validado.
Consideraciones específicas del sector para hotelería, comercio minorista, salud y WiFi multi-inquilino
El mismo plan de resiliencia necesita diferentes prioridades en diferentes entornos. Comience por clasificar los servicios, luego elija los controles de identidad y red que protejan el recorrido de usuario de mayor valor.
| Sector | Servicios de nivel 1 | Postura recomendada de failover | Riesgo clave de identidad y red |
|---|---|---|---|
| Hospitalidad | Autenticación de invitados, acceso a pagos, sistemas de la propiedad, conectividad del personal | WAN dual, RADIUS resiliente, recuperación de Captive Portal probada, energía protegida | La dependencia de un inicio de sesión de invitado compartido o del portal puede interrumpir el registro y la entrega del servicio |
| Retail | Tráfico de POS, servicios de pago, operaciones de tienda, acceso del personal | VLANs aisladas, extremo resiliente, respaldo LTE o 5G, conmutación de circuito probada | El tráfico de pagos y operaciones puede competir con el acceso de invitados si no hay una segmentación estricta |
| Sector salud | WiFi clínico, registros electrónicos, telemetría, BYOD aprobado | Capas de red respaldadas por baterías, identidad resiliente, recuperación de cifrado controlada, cambios listos para auditorías | Una falla de autenticación o de energía puede interrumpir los flujos de trabajo clínicos y crear un riesgo de seguridad |
| Espacios multiinquilino | Acceso de inquilinos, WiFi de áreas comunes, operaciones de edificios, servicios del personal | SSIDs segmentados, políticas conscientes del inquilino, dominios de autenticación independientes, rutas diversas | Una falla de identidad, DNS o política de un operador puede propagarse en cascada a todos los inquilinos |
Los operadores de hotelería deben tratar el WiFi para invitados como un canal operativo y comercial, no como un servicio de cortesía. Los equipos de retail deben mantener las rutas de pago aisladas del tráfico de invitados y verificar que el circuito de respaldo admita el flujo de transacciones real. Los administradores de atención médica necesitan registros de cambios que resistan las auditorías, al mismo tiempo que verifican que el equipo respaldado por batería cubra la ruta de acceso que utilizan los médicos.
Para estadios, edificios residenciales, espacios de coworking y otros recintos con múltiples inquilinos, la segmentación debe extenderse a la autenticación y al DNS. Los SSIDs separados por sí solos no garantizan el aislamiento de los inquilinos si las políticas, las búsquedas de identidad o las rutas de administración siguen compartiéndose.
Un primer paso sensato es realizar un inventario piloto de 30 días. Catalogue puntos de acceso, switches, controladores, circuitos WAN, servicios de identidad, DNS, energía y responsables en una propiedad o recinto representativo. Luego, cree un mapa de SLA estructurado por niveles para el sector, ejecute una prueba de failover controlada y utilice los resultados para financiar la siguiente reducción de riesgos. La presión actual en la planeación de la fuerza laboral también hace que el aspecto del riesgo humano sea importante. El CIPD Labour Market Outlook para el verano de 2026 informó que el 21% de los empleadores del Reino Unido planeaban despidos en los tres meses anteriores a septiembre de 2026. Menos personas significa una menor tolerancia para el trabajo de recuperación no documentado, por lo que debe diseñar manuales de procedimientos y definir responsabilidades antes del próximo cambio de personal.
Las obligaciones de despidos colectivos del Reino Unido también hacen que los entornos fragmentados sean un problema de tiempos y datos. La guía del gobierno sobre consultas de despidos establece que el umbral de 20 o más personas se aplica a un establecimiento dentro de un periodo de 90 días, con tiempos de notificación vinculados al rango de despidos propuesto. Para los líderes de red, la lección análoga es mapear los sitios y las dependencias con precisión. Un entorno de múltiples sitios no puede asumir con seguridad que los edificios, circuitos o equipos separados crean dominios de falla independientes sin demostrar primero cómo se conectan el tráfico, la identidad y las operaciones.
Purple proporciona autenticación de WiFi administrada en la nube y acceso basado en identidad, incluida la capacidad RADIUS diseñada con rutas de servicio redundantes, por lo que puede formar parte de un plan de resiliencia en lugar de dejar el inicio de sesión de invitados como un punto único de falla oculto. Revise cómo Purple se adapta a sus requisitos de red, identidad y conmutación por error, luego comience con un inventario a nivel de propiedad y un simulacro de autenticación controlado.