चेक-इन के दौरान एक होटल का इंटरनेट एक्सेस बंद हो जाता है। गेस्ट WiFi पर ऑथेंटिकेट नहीं कर पाते हैं, कार्ड टर्मिनल टाइम आउट होने लगते हैं, स्टाफ क्लाउड सिस्टम तक पहुंच खो देता है, और रिसेप्शन एक ऐसा साझा पासवर्ड बांटना शुरू कर देता है जिसे कोई भी रिवोक नहीं कर सकता। बैकअप सर्किट मौजूद है, लेकिन फ़ायरवॉल पॉलिसी का कभी परीक्षण नहीं किया गया था। दूसरा RADIUS सर्वर कॉन्फ़िगर किया गया है, लेकिन कोई नहीं जानता कि एक्सेस पॉइंट्स उस तक पहुंच पाएंगे या नहीं। UPS स्वस्थ रिपोर्ट कर रहा है क्योंकि किसी ने लोड के तहत बैटरी की जांच नहीं की है।
यह कोई हार्डवेयर की समस्या नहीं है। यह एक रिडंडेंसी योजना की विफलता (redundancy planning failure) है।
नेटवर्क लचीलेपन का अर्थ है कि जब कोई घटक, लिंक, साइट, पावर फीड, या पहचान निर्भरता विफल हो जाती है, तब भी प्रमाणीकरण, कनेक्टिविटी और आवश्यक सेवाओं को उपलब्ध रखना। अलमारी में रखा एक अतिरिक्त स्विच लचीलापन नहीं बनाता है। एक परीक्षित मार्ग जो भुगतान VLAN, क्लिनिकल एप्लिकेशन, स्टाफ लॉगिन, या अतिथि WiFi सेशन को चालू रखता है, वह लचीलापन बनाता है।
आधुनिक नेटवर्क के लिए वास्तव में रिडंडेंसी योजना का क्या अर्थ है
नेटवर्क रिडंडेंसी की योजना बनाना एक व्यावसायिक निरंतरता (बिजनेस कंटिन्यूटी) का विषय है, न कि केवल उपकरण खरीदने का अभ्यास। सवाल यह नहीं है कि आपके पास दो स्विच हैं या नहीं। सवाल यह है कि क्या उपयोगकर्ता एक परिभाषित विफलता के बाद भी कनेक्ट हो सकते हैं, प्रमाणित कर सकते हैं, सेवाओं को हल कर सकते हैं, और उन अनुप्रयोगों तक पहुँच सकते हैं जो संचालन को चालू रखते हैं।
इसके लिए विफलता डोमेन (failure domains) के स्पष्ट दृष्टिकोण की आवश्यकता होती है। विफलता डोमेन एक ऐसा घटक या निर्भरता है जो स्वतंत्र रूप से विफल हो सकता है और अपने साथ किसी सेवा को भी बंद कर सकता है। विशिष्ट डोमेन में शामिल हैं:
- एक्सेस इंफ्रास्ट्रक्चर, जिसमें स्विचेस, एक्सेस पॉइंट्स, PoE बजट, अपलिंक्स और वायरलेस कंट्रोलर्स शामिल हैं।
- पहचान सेवाएं, जिनमें RADIUS, निर्देशिका एकीकरण, प्रमाणपत्र, Captive Portal और पहचान प्रदाता शामिल हैं।
- मुख्य सेवाएं, जिनमें DHCP, DNS, गेटवे फ़ंक्शन और नेटवर्क नीति शामिल हैं।
- बाहरी पथ, जिनमें WAN सर्किट्स, ISP उपकरण, क्लाउड प्लेटफ़ॉर्म और तृतीय-पक्ष प्रमाणीकरण सेवाएं शामिल हैं।
- सुविधाएं, जिनमें बिजली वितरण, UPS बैटरी, जनरेटर कवरेज और इंटरमीडिएट डिस्ट्रीब्यूशन फ़्रेम रूम शामिल हैं।
एक डिज़ाइन में लचीले कोर राउटर हो सकते हैं और फिर भी वह किनारे (एज) पर विफल हो सकता है। यदि DNS रिज़ॉल्यूशन बंद हो जाता है, तो उपयोगकर्ता WiFi से कनेक्ट हो सकते हैं लेकिन अपनी आवश्यक सेवाओं तक पहुँचने में असमर्थ हो सकते हैं। यदि RADIUS प्रतिक्रिया देना बंद कर देता है, तो एक स्वस्थ वायरलेस नेटवर्क प्रत्येक कर्मचारी या अतिथि लॉगिन को अस्वीकार कर सकता है। यदि Captive Portal एक दुर्गम क्लाउड पाथ पर निर्भर करता है, तो स्थल में रेडियो कवरेज हो सकता है लेकिन उपयोग करने योग्य अतिथि पहुँच नहीं होगी।
सेवा निरंतरता को कंपोनेंट रिडंडेंसी से अलग रखें
सेवाओं से शुरुआत करें, डिवाइस से नहीं। उन सेवाओं को लिख लें जिन्हें व्यवसाय को सुरक्षित रखना आवश्यक है, फिर उनमें से प्रत्येक के अंतर्गत आने वाली हर निर्भरता का पता लगाएं। उदाहरण के लिए, गेस्ट WiFi ऑथेंटिकेशन, एक्सेस पॉइंट, स्विचिंग, PoE, वायरलेस कंट्रोल प्लेन, DHCP, DNS, WAN एक्सेस, RADIUS, पहचान प्रदाता और स्वयं पोर्टल पर निर्भर हो सकता है।
एक उपयोगी नेटवर्क टीम WiFi योजना संदर्भ को इसी निष्कर्ष पर ले जाना चाहिए: वायरलेस एक्सेस एक परिचालन प्रणाली है, न कि LAN पर लगाया गया कोई रेडियो लेयर।
UK नियोक्ता सामूहिक छंटनी योजना के एक अलग वैधानिक अर्थ का उपयोग करते हैं। जहाँ एक नियोक्ता 90 दिनों की रोलिंग अवधि के भीतर एक प्रतिष्ठान में 20 या अधिक कर्मचारियों को बर्खास्त करने का प्रस्ताव करता है, वहाँ सामूहिक परामर्श लागू होता है, जिसमें परामर्श 20 से 99 छंटनी के लिए पहली बर्खास्तगी से कम से कम 30 दिन पहले या 100 या अधिक के लिए पहली बर्खास्तगी से 45 दिन पहले शुरू होता है। UK सरकार का परामर्श मार्गदर्शन बताता है कि परामर्श में प्रस्तावित छंटनी के कारणों, उनसे बचने के तरीकों और बर्खास्तगी की संख्या को कम करने के तरीकों को संबोधित किया जाना चाहिए। वह एक HR योजना ढांचा है। यहाँ वर्णित नेटवर्क अनुशासन सेवा विफलता, निर्भरता मैपिंग और रिकवरी आर्किटेक्चर से संबंधित है।
व्यवहारिक नियम: बैकअप उपकरणों की गिनती न करें। उपयोगकर्ता से सेवा तक स्वतंत्र पथों की गिनती करें।
यह मार्गदर्शिका आगे इसी व्यावहारिक दृष्टिकोण का उपयोग करती है। विफलता के जोखिमों की पहचान करें, ऐसे रिकवरी लक्ष्य निर्धारित करें जो व्यावसायिक समस्याओं को दर्शाते हों, एक ऐसा आर्किटेक्चर चुनें जिसे आपकी टीम संचालित कर सके, पावर से लेकर पहचान तक हर परत की रक्षा करें, और नियंत्रित परिस्थितियों में परिणाम का परीक्षण करें। यदि कोई घटक किसी ड्रिल में कभी विफल नहीं हुआ है, तो उसकी अतिरेकता (रिडंडेंसी) को एक धारणा मानें, क्षमता नहीं।
समाधान डिज़ाइन करने से पहले विफलता के जोखिमों का मानचित्रण करना
अधिकांश नेटवर्क टीमों को अपनी सबसे खतरनाक विफलता के एकल बिंदुओं को खोजने के लिए किसी गवर्नेंस प्लेटफॉर्म की आवश्यकता नहीं होती है। उन्हें एक छोटे रजिस्टर की आवश्यकता होती है जो जोखिम का नाम रखे, उसका लगातार मूल्यांकन करे, एक मालिक को सौंपे, और यह रिकॉर्ड करे कि क्या किसी ने इसे कम किया है।
तीन अक्षों का उपयोग करें:
- संभावना, जिसका अर्थ है कि तुलनीय परिसंपत्तियों में या आपके स्वयं के परिवेश में विफलता कितनी बार होती है।
- ब्लास्ट रेडियस, जिसका अर्थ है कि कितने उपयोगकर्ता, साइट, सेवाएं, या राजस्व-उत्पादक गतिविधियां अनुपलब्ध हो जाती हैं।
- रिकवरी की कठिनाई, जिसका अर्थ है कि आपके पास मौजूद कौशल, एक्सेस, स्पेयर पार्ट्स, विक्रेता सहायता और दस्तावेज़ीकरण के साथ पुनर्स्थापन कितना कठिन है।
प्रत्येक अक्ष को स्थानीय पैमाने पर स्कोर करें, फिर तीनों मानों को गुणा करें या भारित (weighted) फॉर्मूला लागू करें। गणित की तुलना में निरंतरता अधिक मायने रखती है। एक अकेला WAN सर्किट एक अलग-थलग पड़े मार्केटिंग डिस्प्ले से ऊपर होना चाहिए क्योंकि इसकी विफलता एक ही बार में हर निर्भर सेवा को प्रभावित कर सकती है।
रजिस्टर को वास्तविक डिपेंडेंसी के आसपास तैयार करें
उन संपत्तियों को शामिल करें जिन्हें टीमें अक्सर अनदेखा कर देती हैं। एक उपयोगी पहले प्रयास में शामिल होना चाहिए:
- पूरे वेन्यू को सर्विस देने वाला एक सिंगल WAN ISP या सर्किट।
- एक RADIUS सर्विस या एक पहचान-प्रदाता इंटीग्रेशन।
- एक DNS रिज़ॉल्वर पाथ।
- एक सिंगल वायरलेस कंट्रोलर या क्लाउड मैनेजमेंट निर्भरता।
- बिना जनरेटर कवरेज वाला एक इंटरमीडिएट डिस्ट्रीब्यूशन फ्रेम रूम।
- UPS बैटरियां जो स्थिति की रिपोर्ट तो करती हैं लेकिन सार्थक लोड के तहत कभी उनकी जांच नहीं की गई है।
- बिना किसी दस्तावेजीकृत डिग्रेडेड मोड का Captive Portal।
- एक स्विच स्टैक जिसके अपलिंक्स एक फिजिकल रूट साझा करते हैं।
- बिना किसी परीक्षित रिकवरी प्रक्रिया के एक DHCP सर्विस।
रजिस्टर में सर्विस ओनर, तकनीकी ओनर, अंतिम विफलता की तारीख, वर्तमान न्यूनीकरण, परीक्षण की तारीख और अगली कार्रवाई भी दर्ज होनी चाहिए। "नेटवर्क टीम" कोई ओनर नहीं है। उस व्यक्ति या टीम का नाम दें जो बदलाव की व्यवस्था करने और यह साबित करने के लिए जिम्मेदार है कि यह काम करता है।
सैंपल नेटवर्क रिस्क रजिस्टर स्कोरिंग
निम्नलिखित एक व्यावहारिक टेम्पलेट है, न कि किसी विशेष संपत्ति के बारे में कोई दावा। प्रत्येक अक्ष के लिए एक सुसंगत स्थानीय पैमाने का उपयोग करें और प्रत्येक प्रविष्टि के लिए अंतिम स्कोर की गणना उसी तरीके से करें।
| विफलता परिदृश्य | संभावना (1-5) | प्रभाव का दायरा (1-5) | रिकवरी की कठिनाई (1-5) | जोखिम स्कोर |
|---|---|---|---|---|
| एकल WAN सर्किट | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | संभावना × प्रभाव का दायरा × रिकवरी की कठिनाई |
| एकल RADIUS सेवा | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | संभावना × प्रभाव का दायरा × रिकवरी की कठिनाई |
| एकल DNS रिज़ॉल्वर पाथ | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | संभावना × प्रभाव का दायरा × रिकवरी की कठिनाई |
| एकल वायरलेस कंट्रोलर | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | संभावना × प्रभाव का दायरा × रिकवरी की कठिनाई |
| बिना जनरेटर वाला IDF कमरा | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | संभावना × प्रभाव का दायरा × रिकवरी की कठिनाई |
| बिना निगरानी वाली UPS बैटरी | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | स्थानीय रूप से रेट करें | संभावना × प्रभाव का दायरा × रिकवरी की कठिनाई |
एकदम सटीक रजिस्टर का इंतज़ार न करें। विश्वसनीय मालिकों वाली एक सिंगल-पेज की सूची एक ऐसे चमचमाते जोखिम सिस्टम से अधिक उपयोगी है जिसे कोई अपडेट नहीं करता। तत्काल उद्देश्य प्राथमिकता तय करना है। उन विफलताओं को रैंक करें जो महत्वपूर्ण सेवाओं को अक्षम कर सकती हैं, फिर रिकवरी लक्ष्यों को सेट करने और आर्किटेक्चर चुनने के लिए उन परिणामों का उपयोग करें।
आधिकारिक UK प्रबंधन जानकारी दिखाती है कि एक अलग लेकिन संबंधित कार्यबल संदर्भ में संरचित अग्रिम योजना क्यों मायने रखती है। सरकार के छंटनी अधिसूचना डेटा के अनुसार, नियोक्ताओं ने जनवरी 2020 में 29,496 संभावित छंटनियों को कवर करने वाले 368 HR1 फॉर्म और फरवरी 2020 में 27,804 संभावित छंटनियों को कवर करने वाले 326 फॉर्म जमा किए। नेटवर्क लीडर्स के लिए सबक सीधा है: औपचारिक योजना इसलिए मौजूद है क्योंकि बड़े परिचालन परिवर्तनों में तत्काल सुधार करना कठिन होता है। यही बात तब भी लागू होती है जब एक मल्टी-साइट नेटवर्क एक साझा निर्भरता खो देता है।
वास्तविक व्यावसायिक कठिनाई से मेल खाने वाले RTO और RPO लक्ष्य निर्धारित करना
RTO और RPO तभी उपयोगी होते हैं जब व्यावसायिक मालिक उन्हें समझ सकें।
रिकवरी टाइम ऑब्जेक्टिव, या RTO, वह अधिकतम स्वीकार्य समय है जिसके दौरान कोई सेवा अनुपलब्ध रह सकती है। रिकवरी पॉइंट ऑब्जेक्टिव, या RPO, अंतिम रिकवरी योग्य बिंदु के बाद से डेटा, कॉन्फ़िगरेशन या सेशन स्थिति का अधिकतम स्वीकार्य नुकसान है। किसी नेटवर्क के लिए, RPO का संबंध पारंपरिक डेटाबेस लेनदेन के बजाय कॉन्फ़िगरेशन, पॉलिसी, डिवाइस स्थिति, इवेंट रिकॉर्ड या सक्रिय ऑथेंटिकेशन संदर्भ से हो सकता है।
दोनों पैमानों को परिचालन संबंधी परिणामों में बदलें। पूछें कि सेवा विफल होने पर सबसे पहले क्या रुकता है। क्या रिसेप्शन पर मेहमानों की कतार लग जाती है? क्या काउंटर भुगतान स्वीकार करना बंद कर देते हैं? क्या चिकित्सकों की इलेक्ट्रॉनिक रिकॉर्ड तक पहुँच समाप्त हो जाती है? क्या प्रॉपर्टी मैनेजर का किरायेदार एक्सेस कंट्रोल बंद हो जाता है? सेवा के मालिक को केवल एक IT लक्ष्य को दोहराने के बजाय व्यावसायिक परिणाम बताना चाहिए।
पूरे एस्टेट-व्यापी वादे के बजाय सेवा स्तरों (टीयर्स) का उपयोग करें
एक व्यावहारिक सेवा मानचित्र महत्वपूर्ण पहुंच को उन सेवाओं से अलग करता है जो प्रतीक्षा कर सकती हैं।
| सेवा श्रेणी | उदाहरण सेवाएँ | लक्ष्य RTO | लक्ष्य RPO | आर्किटेक्चर निहितार्थ |
|---|---|---|---|---|
| श्रेणी 1 | अतिथि WiFi प्रमाणीकरण, भुगतान VLAN, नैदानिक एप्लिकेशन एक्सेस | मिनट, व्यावसायिक सहनशीलता के आधार पर | पॉलिसी और प्रमाणीकरण स्थिति का न्यूनतम नुकसान | स्वतंत्र मार्ग, तीव्र फ़ेलओवर, लचीली पहचान, परीक्षण की गई पावर |
| श्रेणी 2 | कर्मचारी WiFi, बैक-ऑफिस सिस्टम, एनालिटिक्स सिंक्रोनाइज़ेशन | लगभग एक घंटा, जहाँ संचालन इसकी अनुमति देता है | हालिया कॉन्फ़िगरेशन और सेवा स्थिति | वार्म स्टैंडबाय, जहाँ उचित हो दोहरे मार्ग, प्रलेखित पुनर्प्राप्ति |
| श्रेणी 3 | अतिथि मनोरंजन, मार्केटिंग स्प्लैश पेज, गैर - महत्वपूर्ण रिपोर्टिंग | कई घंटे स्वीकार्य हो सकते हैं | बैकअप - आधारित पुनर्प्राप्ति पर्याप्त हो सकती है | कम लागत वाला स्टैंडबाय या मैन्युअल बहाली |
ये प्लानिंग के उदाहरण हैं, न कि यूनिवर्सल सर्विस लेवल्स। फाइनेंस को एक साधारण लॉस मॉडल का उपयोग करके टारगेट को मान्य करना चाहिए: अनुमानित प्रति घंटा रेवेन्यू योगदान, परिचालन व्यवधान, प्रतिष्ठित जोखिम और अनुपालन प्रभाव, जिसे डाउनटाइम से विभाजित किया गया हो जिसे व्यवसाय स्वीकार कर सकता है। गलत सटीकता से बचें। एक पेमेंट सर्विस के पास कोई सार्थक "औसत घंटा" नहीं हो सकता है क्योंकि व्यस्त ट्रेडिंग विंडो के दौरान एक छोटा सा आउटेज रात भर के लंबे आउटेज की तुलना में अधिक नुकसान पहुंचा सकता है।
RTO में पहचान और निर्णय का समय भी शामिल होना चाहिए। यदि मॉनिटरिंग को अलर्ट जारी करने में बहुत अधिक समय लगता है, तो इंजीनियर द्वारा खराबी का पता लगाने के तुरंत बाद पूरा होने वाला फेलओवर भी व्यावसायिक लक्ष्य को प्राप्त करने में विफल हो सकता है। रिकवरी अनुमान में DNS प्रोपेगेशन व्यवहार, सेशन पुनःप्रमाणीकरण, डिवाइस रिकनेक्शन, फ़ायरवॉल कन्वर्जेंस और मानवीय एस्केलेशन को शामिल करें।
RPO को भी इसी तरह के अनुशासन की आवश्यकता है। यदि विफलता से ठीक पहले किया गया कॉन्फ़िगरेशन परिवर्तन गायब हो जाता है, तो क्या टीम इसे फिर से बना सकती है? यदि अतिथि सेशन को पुनः प्रमाणित करना पड़े, तो क्या यह स्वीकार्य है? यदि कोई पहचान निर्देशिका अस्थायी रूप से अनुपलब्ध है, तो क्या एक्सेस लेयर सुरक्षा को कमजोर किए बिना एक ज्ञात-अच्छी नीति का उपयोग कर सकती है?
आक्रामक RTO लक्ष्यों के लिए आमतौर पर एक्टिव - एक्टिव या भौगोलिक रूप से स्वतंत्र क्षमता की आवश्यकता होती है। एक अधिक उदार RTO वार्म स्टैंडबाय, प्रलेखित बहाली, या बैकअप - आधारित रिकवरी का समर्थन कर सकता है। किसी अनुबंध से उद्यम सेवा स्तर की नकल न करें जब स्थल अभी भी एक ISP, एक पावर फीड, या एक पहचान पाथ पर निर्भर हो। आर्किटेक्चर को उस लक्ष्य को हासिल करने के लायक होना चाहिए।
अपनी संपत्ति के लिए सही फ़ेलओवर आर्किटेक्चर चुनना
चार पैटर्न अधिकांश वास्तविक दुनिया के स्थानों की तैनाती को कवर करते हैं। कोई भी स्वचालित रूप से सही नहीं है। सही चुनाव डाउनटाइम सहिष्णुता, संपत्ति के आकार, परिचालन कौशल, विफलता की स्वतंत्रता और बजट पर निर्भर करता है।
एक्टिव-एक्टिव दो या दो से अधिक सक्षम घटकों को एक ही समय में ट्रैफ़िक की सेवा प्रदान करने के लिए चालू रखता है। डुअल कंट्रोलर या एक्सेस क्लस्टर मांग को साझा कर सकते हैं, और एक साइड फेल होने पर दूसरा साइड काम जारी रख सकता है। यह विफलता के दौरान मजबूत क्षमता देता है, लेकिन यह अधिक स्टेट सिंक्रोनाइजेशन, पॉलिसी निरंतरता और स्प्लिट-ब्रेन जोखिम पैदा करता है। इसका उपयोग तब करें जब डाउनटाइम महंगा हो और टीम दोनों पक्षों की ठीक से निगरानी कर सके।
सक्रिय-निष्क्रिय (Active-passive) एक स्टैंडबाय घटक को कार्यभार संभालने के लिए तैयार रखता है। सक्रिय-सक्रिय की तुलना में इसे समझना आसान है, लेकिन प्रोमोशन, स्थिति का स्थानांतरण और पहचान एक रिकवरी अंतर पैदा कर सकते हैं। एक हॉट स्टैंडबाय केवल तभी मूल्यवान है जब उसके पास वर्तमान कॉन्फ़िगरेशन, सुलभ निर्भरताएं और एक परीक्षित प्रोमोशन प्रक्रिया हो।
N+1 क्लस्टर के लिए एक अतिरिक्त क्षमता इकाई प्रदान करता है। यह तब एक व्यावहारिक समाधान है जब कोई साइट किसी घटक के प्रतिस्थापन को सहन कर सकती है लेकिन पूरी तरह से डुप्लिकेट वातावरण का औचित्य साबित नहीं कर सकती। N+1 फिर भी एस्टेट को साझा विफलताओं के प्रति संवेदनशील छोड़ देता है, जैसे कि एक सामान्य पावर फीड, सामान्य अपलिंक, या हर इकाई में कॉपी किया गया खराब कॉन्फ़िगरेशन।
भौगोलिक अतिरेकता (जियोग्राफिक रिडंडेंसी) एक संपूर्ण सेवा क्षमता को दूसरी साइट या क्षेत्र में रखती है। यह केवल उपकरण की विफलता को नहीं, बल्कि पूरी साइट के नुकसान को संबोधित करती है, और इसमें सबसे अधिक पूंजीगत और परिचालन लागत आती है। यह कई संपत्तियों का समर्थन करने वाली साझा सेवाओं के लिए या उन संगठनों के लिए उपयुक्त है जो एक ही इमारत को विफलता डोमेन के रूप में स्वीकार नहीं कर सकते।
फ़ेलओवर आर्किटेक्चर तुलना
| आर्किटेक्चर | लागत | जटिलता | विशिष्ट RTO | सर्वोत्तम अनुकूल |
|---|---|---|---|---|
| एक्टिव-एक्टिव | उच्च | उच्च | सही ढंग से संचालित होने पर बहुत कम | महत्वपूर्ण सेवाएँ, बड़े एस्टेट, सिंक्रोनाइज़्ड सिस्टम को प्रबंधित करने में सक्षम टीमें |
| एक्टिव-पैसेसिव | मध्यम से उच्च | मध्यम | प्रमोशन के आधार पर कम से मध्यम | दोनों पक्षों पर ट्रैफ़िक परोसे बिना तैयार स्टैंडबाय की आवश्यकता वाले स्थान |
| N+1 | मध्यम | मध्यम | प्रतिस्थापन और प्रोविज़निंग के आधार पर मध्यम | क्लस्टर जहाँ एक घटक विफल पीयर को कवर कर सकता है |
| भौगोलिक अतिरेक | उच्चतम | उच्चतम | राउटिंग और स्थिति के आधार पर कम से विस्तारित | मल्टी-साइट ऑपरेटर और पूर्ण-साइट विफलता के संपर्क में आने वाली सेवाएँ |
दो संपत्तियों वाला एक होटल समूह साइटों के बीच सक्रिय-सक्रिय (active-active) सेवाओं का उपयोग कर सकता है यदि WAN, पहचान, DNS, बिजली और परिचालन स्वामित्व वास्तव में स्वतंत्र हों। एक एकल रिटेल स्टोर आमतौर पर दूसरे डेटा-सेंटर डिज़ाइन की तुलना में एक लचीले फ़ायरवॉल, खंडित ट्रैफ़िक, और LTE या 5G बैकअप से अधिक लाभ प्राप्त करता है जिसे वह संचालित नहीं कर सकता।
सीधे निर्णय शॉर्टकट का उपयोग करें। यदि कर्मचारियों के संसाधन सीमित हैं और व्यवसाय मापी गई रिकवरी को सहन कर सकता है, तो एक्टिव-पैसिव या N+1 चुनें। यदि महत्वपूर्ण लेनदेन के लिए निरंतरता की आवश्यकता है और टीम सिंक्रोनाइजेशन को संभाल सकती है, तो एक्टिव-एक्टिव चुनें। यदि पूरा साइट ही प्रमुख जोखिम है, तो भौगोलिक अतिरेकता (geographic redundancy) इसका समाधान है। यदि बजट कम है, तो सबसे अधिक दिखाई देने वाले डिवाइस की डुप्लिकेट कॉपी खरीदने के बजाय व्यावसायिक प्रभाव के क्रम में सिंगल-पाथ निर्भरता को हटा दें।
लचीले नेटवर्क, प्रमाणीकरण और पहचान परतों को डिज़ाइन करना
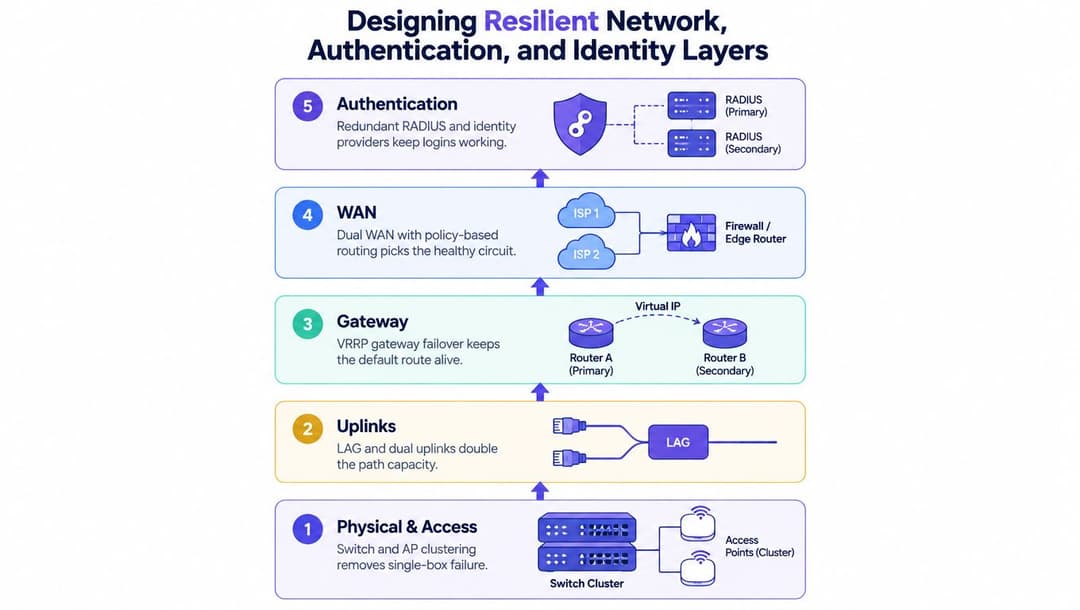
लचीलापन सबसे कमजोर निर्भरता पर विफल हो जाता है। स्टैक को भौतिक परत से ऊपर की ओर बनाएं, और प्रत्येक परत को एक स्वतंत्र विफलता डोमेन असाइन करें।
एक्सेस और अपलिंक्स के साथ शुरुआत करें
जहाँ एस्टेट को इसकी आवश्यकता हो वहाँ स्विच और एक्सेस पॉइंट क्लस्टरिंग का उपयोग करें, लेकिन यह सत्यापित करें कि क्लस्टर के सदस्य एक ही विफलता डोमेन (फेलियर डोमेन) साझा न करें। एक ही रैक में दो स्विच अभी भी एक ही पावर फीड पर निर्भर हो सकते हैं। दो अपलिंक अभी भी एक ही केबल ट्रे का अनुसरण कर सकते हैं। लिंक एग्रीगेशन क्षमता और पाथ लचीलापन प्रदान कर सकता है, जबकि दोहरे अपलिंक एकल पोर्ट, मॉड्यूल या केबल पर निर्भरता को कम करते हैं।
गेटवे पर, VRRP या समकक्ष वर्चुअल गेटवे मैकेनिज्म का उपयोग करें ताकि डिफॉल्ट रूट डिवाइसों के बीच स्थानांतरित हो सके। यह मान लेने के बजाय कि एक फ्लोटिंग गेटवे सक्रिय सत्रों को सुरक्षित रखता है, स्टेटफुल फ़ायरवॉल फ़ेलओवर का परीक्षण करें। कुछ सेवाएं सुचारू रूप से पुनः कनेक्ट हो जाती हैं। अन्य को स्पष्ट सत्र प्रबंधन की आवश्यकता होती है।
WAN लचीलेपन में अलग - अलग सर्किट के साथ नीति - आधारित रूटिंग का संयोजन होना चाहिए जो केवल लिंक की स्थिति को नहीं, बल्कि स्वास्थ्य को भी पहचानता है। एक सर्किट विद्युत रूप से चालू रह सकता है, भले ही वह महत्वपूर्ण अनुप्रयोगों तक पहुँचने का रास्ता खो चुका हो। LTE या 5G प्रबंधन के लिए एक उपयोगी आउट - ऑफ - बैंड पहुँच और एक फॉलबैक पाथ प्रदान करता है, लेकिन इसे अपने स्वयं के कवरेज, पावर, डेटा नीति और सुरक्षा नियंत्रणों की आवश्यकता होती है।
DNS और पावर को प्रोडक्शन डिपेंडेंसी के रूप में मानें
DNS उपयोगकर्ता यात्रा का हिस्सा है। विचारशील TTL प्रबंधन, माध्यमिक रिज़ॉल्यूशन क्षमता और एक स्प्लिट-होराइज़न डिज़ाइन का उपयोग करें जहां आंतरिक और बाहरी प्रतिक्रियाओं को भिन्न होने की आवश्यकता हो। रिज़ॉल्यूशन समय और विफलता की निगरानी करें, न कि केवल यह कि कोई रिज़ॉल्वर प्रक्रिया प्रतिक्रिया दे रही है या नहीं।
पावर को भी परतों (layers) की आवश्यकता होती है। UPS सुरक्षा को एक व्यावहारिक PoE बजट के साथ जोड़ें, जहाँ भी इमारत सपोर्ट करती हो वहाँ फीड्स को अलग रखें, और उन कमरों के लिए जनरेटर कवरेज सुनिश्चित करें जो नेटवर्क निर्भरताओं की मेजबानी करते हैं। खराब बैटरी वाला UPS लचीलापन (resilience) नहीं है। न ही ऐसा जनरेटर जो एक्सेस लेयर तक नहीं पहुँचता।
प्रमाणीकरण (ऑथेंटिकेशन) को कनेक्टिविटी की तरह ही सावधानी से सुरक्षित करें
RADIUS के पास स्वतंत्र सर्विस इंस्टेंस और एक परीक्षित फ़ेलओवर क्रम होना चाहिए। Captive Portal के व्यवहार के लिए एक निश्चित डिग्रैडेड मोड की आवश्यकता होती है। यह जाँचें कि क्या पहले से प्रमाणित उपयोगकर्ता अपनी प्रक्रिया जारी रख सकता है, क्या कोई नया उपयोगकर्ता अपनी यात्रा पूरी कर सकता है, और पहचान प्रदाता (identity provider) के अनुपलब्ध होने पर क्या होता है।
स्टाफ एक्सेस के लिए, क्लाउड-मैनेज्ड RADIUS सर्विस एक सिंगल ऑन-प्रिमाइसेस सर्वर पर निर्भरता को कम कर सकती है, लेकिन इसके लिए अभी भी मल्टी-रीजन उपलब्धता, मॉनिटर किए गए एंडपॉइंट्स, वर्तमान सर्टिफिकेट्स और स्पष्ट रिकवरी ओनरशिप की आवश्यकता होती है। ऑथेंटिकेशन लेयर को रेजिलिएंस बातचीत में बनाए रखते हुए डायरेक्टरी-आधारित पहचान के साथ नेटवर्क एक्सेस को जोड़ने के लिए Purple की Entra ID RADIUS सर्विस एक विकल्प है।
प्रत्येक लेयर को स्वतंत्र रूप से विफल होना चाहिए। यदि दोनों RADIUS नोड्स एक ही वर्चुअल होस्ट का उपयोग करते हैं, दोनों DNS पथ एक ही रिज़ॉल्वर का उपयोग करते हैं, और दोनों WAN सर्किट एक ही डक्ट से प्रवेश करते हैं, तो आरेख में अतिरेक (redundancy) तो है लेकिन वास्तविक एस्टेट में नहीं।
परीक्षण, निगरानी और रनबुक्स जो वास्तव में आउटेज को पकड़ते हैं
कागज पर की गई आर्किटेक्चर, प्रोडक्शन में उपयोग होने वाली आर्किटेक्चर नहीं है। फ़ेलओवर पाथ को मान्य करने का एकमात्र विश्वसनीय तरीका इसे नियंत्रित परिस्थितियों में आज़माना, उपयोगकर्ता अनुभव का निरीक्षण करना और जो टूटता है उसे ठीक करना है।
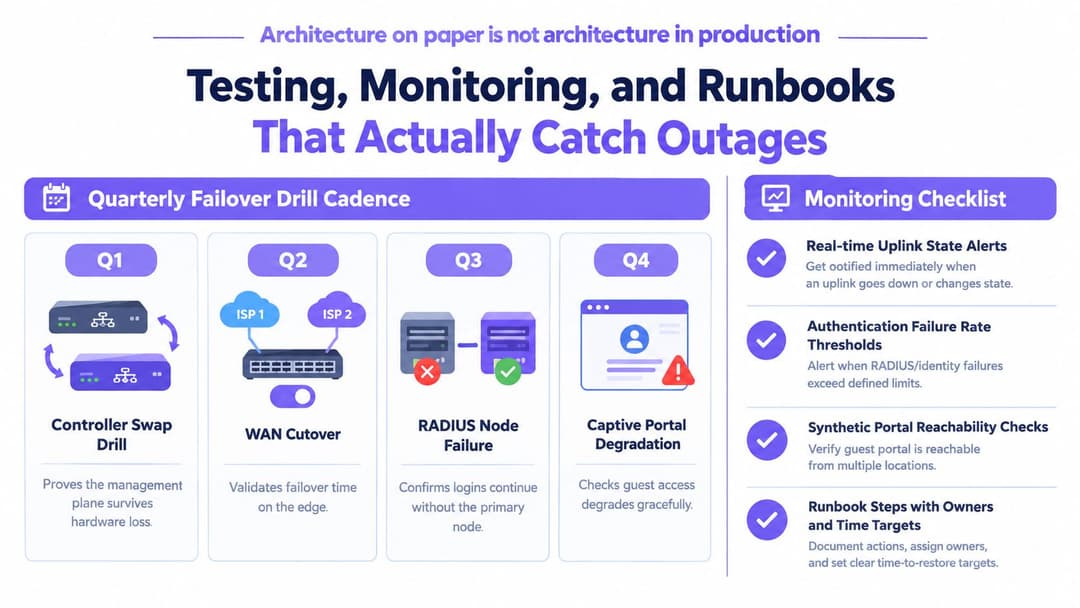
प्रत्येक चक्र में एक अलग विफलता फोकस के साथ एक त्रैमासिक ड्रिल कार्यक्रम चलाएं:
- कंट्रोलर स्वैप: साबित करें कि प्राइमरी कंट्रोलर को हटाने के बाद भी मैनेजमेंट और वायरलेस सर्विस जारी रहती है।
- WAN कटओवर: सर्किट डिटेक्शन, पॉलिसी राउटिंग, फ़ायरवॉल स्थिति और एप्लिकेशन पहुंच की पुष्टि करें।
- RADIUS नोड विफलता: पुष्टि करें कि नए लॉगिन और री-ऑथेंटिकेशन सेकेंडरी सर्विस का उपयोग करते हैं।
- Captive Portal डिग्रेडेशन: जांचें कि गेस्ट एक्सेस सुरक्षित रूप से फेल हो और मौजूदा यूजर्स को वांछित अनुभव मिले।
नियंत्रित अव्यवस्था एक कागजी अभ्यास (tabletop exercise) से कहीं बेहतर होती है। कम जोखिम वाली रात में, एक स्वीकृत बदलाव रिकॉर्ड के साथ एक स्विच स्टैक को डिस्कनेक्ट करें, एक WAN पथ को अक्षम करें, या एक RADIUS नोड को अलग करें। परीक्षण को सीमित रखें, रोलबैक की व्यवस्था तय करें, और सर्विस ओनर को केवल मॉनिटरिंग डैशबोर्ड देखने के बजाय व्यावसायिक प्रभाव पर नज़र रखने के लिए कहें।
लक्षणों की निगरानी करें, डिवाइस वैनिटी की नहीं
उपयोगी संकेतों में शामिल हैं:
- कंट्रोलर पहुंच योग्यता और क्लस्टर स्थिति।
- RADIUS प्रतिक्रिया विलंबता और ऑथेंटिकेशन विफलता दर।
- DNS रिज़ॉल्यूशन समय और विफल लुकअप।
- एक्सेस पॉइंट जॉइन स्थिति और क्लाइंट रीअसोसिएशन।
- अपलिंक उपयोग, त्रुटियां और पाथ परिवर्तन।
- सिंथेटिक Captive Portal पहुंच योग्यता।
- केवल इंटरफ़ेस स्थिति के बजाय एप्लिकेशन प्रोब पर आधारित WAN स्वास्थ्य।
ग्राहक प्रभाव के आधार पर अलर्ट थ्रेशोल्ड निर्धारित करें। प्रमाणीकरण विफलताओं में थोड़ी सी वृद्धि उपयोगकर्ताओं द्वारा हेल्प डेस्क पर कॉल करने से पहले ही पहचान की आउटेज का संकेत दे सकती है। निरंतर क्षमता पर चल रहा एक अपलिंक खराब फेलओवर का अग्रदूत हो सकता है। हर क्षणिक घटना के लिए इंजीनियरों को पेज न करें। उन्हें तब पेज करें जब कई संकेत मिलकर सेवा संबंधी समस्या का रूप ले लें।
एक रनबुक में एक निर्णय वृक्ष (डिसीजन ट्री), नामित एस्केलेशन ओनर, वेंडर संपर्क क्रम, पहुँच आवश्यकताएँ, रोलबैक चरण और सेवा RTO से जुड़े समय के लक्ष्य शामिल होने चाहिए। जहाँ उपयुक्त हो वहाँ स्क्रीनशॉट या सटीक कंसोल स्थान शामिल करें, लेकिन केवल व्यक्तिगत ज्ञान पर निर्भर न रहें। प्रत्येक ड्रिल के बाद, डिटेक्शन का समय, निर्णय का समय, रिकवरी का समय, उपयोगकर्ता प्रभाव और आवश्यक बदलाव को रिकॉर्ड करें।
Purple WiFi latency and jitter test नेटवर्क गुणवत्ता के व्यावहारिक सत्यापन का समर्थन कर सकता है, लेकिन कोई भी परीक्षण वास्तविक फ़ेलओवर अभ्यास का विकल्प नहीं हो सकता। यदि आपने जानबूझकर किसी निर्भरता को विफल नहीं किया है, तो आपने इसका सत्यापन नहीं किया है।
हॉस्पिटैलिटी, रिटेल, हेल्थकेयर और मल्टी-टेनेंट WiFi के लिए क्षेत्र-विशिष्ट विचार
समान लचीलेपन के ब्लूप्रिंट को विभिन्न परिवेशों में अलग-अलग प्राथमिकताओं की आवश्यकता होती है। सेवाओं की रैंकिंग करके शुरुआत करें, फिर उन पहचान और नेटवर्क नियंत्रणों को चुनें जो उच्चतम-मूल्य वाले उपयोगकर्ता सफ़र की रक्षा करते हैं।
| क्षेत्र | टियर-1 सेवाएं | अनुशंसित फ़ेलओवर दृष्टिकोण | प्रमुख पहचान और नेटवर्क जोखिम |
|---|---|---|---|
| आतिथ्य (Hospitality) | अतिथि प्रमाणीकरण, भुगतान पहुंच, संपत्ति प्रणाली, कर्मचारी कनेक्टिविटी | दोहरा WAN, लचीला RADIUS, परीक्षित Captive Portal रिकवरी, सुरक्षित पावर | एक साझा अतिथि लॉगिन या पोर्टल निर्भरता चेक-इन और सेवा वितरण को बाधित कर सकती है |
| रिटेल | POS ट्रैफ़िक, भुगतान सेवाएं, स्टोर संचालन, कर्मचारी पहुंच | पृथक VLANs, लचीला एज, LTE या 5G बैकअप, परीक्षित सर्किट कटओवर | बिना सख्त विभाजन के भुगतान और परिचालन ट्रैफ़िक अतिथि पहुंच के साथ प्रतिस्पर्धा कर सकते हैं |
| स्वास्थ्य सेवा | नैदानिक WiFi, इलेक्ट्रॉनिक रिकॉर्ड, टेलीमेट्री, स्वीकृत BYOD | बैटरी-बैकअप वाले नेटवर्क लेयर्स, लचीली पहचान, नियंत्रित एन्क्रिप्शन रिकवरी, ऑडिट-तैयार बदलाव | प्रमाणीकरण या पावर की विफलता नैदानिक वर्कफ़्लो को बाधित कर सकती है और सुरक्षा जोखिम पैदा कर सकती है |
| बहु-किरायेदार (Multi-tenant) परिसर | किरायेदार पहुंच, सामान्य क्षेत्र WiFi, भवन संचालन, कर्मचारी सेवाएं | विभाजित SSIDs, किरायेदार-जागरूक नीति, स्वतंत्र प्रमाणीकरण डोमेन, विविध पाथ | एक ऑपरेटर की पहचान, DNS, या नीति की विफलता पूरे किरायेदार नेटवर्क में फैल सकती है |
हॉस्पिटैलिटी ऑपरेटरों को गेस्ट WiFi को एक परिचालन और व्यावसायिक चैनल के रूप में मानना चाहिए, न कि केवल एक सौजन्य सेवा के रूप में। रिटेल टीमों को भुगतान पाथ को गेस्ट ट्रैफ़िक से अलग रखना चाहिए और यह सत्यापित करना चाहिए कि बैकअप सर्किट वास्तविक लेनदेन प्रवाह का समर्थन करता है। स्वास्थ्य सेवा प्रशासकों को ऐसे चेंज रिकॉर्ड की आवश्यकता होती है जो ऑडिट में सही साबित हों, साथ ही यह भी जांचना होता है कि बैटरी-समर्थित उपकरण उस एक्सेस पाथ को कवर करते हैं जिसका उपयोग क्लीनिशियन करते हैं।
स्टेडियमों, आवासीय भवनों, कोवर्किंग साइटों और अन्य बहु-किराएदार स्थानों के लिए, प्रमाणीकरण और DNS में भी विभाजन जारी रहना चाहिए। यदि नीतियां, पहचान लुकअप या प्रबंधन पथ साझा रहते हैं, तो केवल अलग SSID किराएदारों के अलगाव की गारंटी नहीं देते हैं।
एक समझदारी भरा पहला कदम 30-दिवसीय पायलट इन्वेंट्री है। एक प्रतिनिधि संपत्ति या स्थल पर एक्सेस पॉइंट्स, स्विचेस, कंट्रोलर्स, WAN सर्किट्स, पहचान सेवाओं, DNS, पावर और मालिकों को सूचीबद्ध करें। फिर क्षेत्र के लिए एक टियर-वार SLA मैप बनाएं, एक नियंत्रित फेलओवर चलाएं, और अगले जोखिम को कम करने के लिए बजट प्राप्त करने हेतु परिणामों का उपयोग करें। मौजूदा कार्यबल नियोजन दबाव भी मानव-जोखिम के पहलू को महत्वपूर्ण बनाता है। गर्मियों 2026 के लिए CIPD लेबर मार्केट आउटलुक ने रिपोर्ट किया कि सितंबर 2026 तक तीन महीनों में 21% UK नियोक्ताओं ने छंटनी की योजना बनाई थी। कम लोगों का अर्थ है बिना दस्तावेजीकरण वाले रिकवरी कार्य के लिए कम सहनशीलता, इसलिए अगले स्टाफिंग बदलाव से पहले रनबुक और स्वामित्व को डिजाइन करें।
UK के सामूहिक छंटनी कर्तव्य भी खंडित संपत्तियों को समय और डेटा की समस्या बना देते हैं। छंटनी परामर्श पर सरकारी मार्गदर्शन में कहा गया है कि 20 या उससे अधिक की सीमा 90 दिनों के भीतर एक प्रतिष्ठान पर लागू होती है, जिसमें अधिसूचना का समय प्रस्तावित बर्खास्तगी सीमा से जुड़ा होता है। नेटवर्क लीडर्स के लिए, समान सबक साइटों और निर्भरताओं का सटीक मानचित्रण करना है। एक मल्टी-साइट संपत्ति सुरक्षित रूप से यह मान नहीं सकती है कि अलग-अलग इमारतें, सर्किट या टीमें अलग-अलग विफलता डोमेन बनाती हैं, जब तक कि यह साबित न हो जाए कि ट्रैफ़िक, पहचान और संचालन कैसे जुड़ते हैं।
Purple क्लाउड-प्रबंधित WiFi ऑथेंटिकेशन और पहचान-आधारित एक्सेस प्रदान करता है, जिसमें redundant सर्विस पाथ के साथ डिज़ाइन की गई RADIUS क्षमता शामिल है, ताकि यह गेस्ट लॉगिन को एक छिपे हुए सिंगल पॉइंट ऑफ फेलियर के रूप में छोड़ने के बजाय एक लचीलेपन के ब्लूप्रिंट का हिस्सा बन सके। समीक्षा करें कि Purple आपके नेटवर्क, पहचान और फेलओवर आवश्यकताओं के अनुकूल कैसे बैठता है, फिर प्रॉपर्टी-स्तरीय इन्वेंट्री और नियंत्रित ऑथेंटिकेशन ड्रिल के साथ शुरुआत करें।