
Alta disponibilidad de servidores RADIUS: Active-Active frente a Active-Passive
Una guía de referencia técnica definitiva para directores de TI y arquitectos de redes que evalúan arquitecturas de alta disponibilidad RADIUS. Compara implementaciones Active-Active y Active-Passive, detalla los requisitos de replicación de bases de datos y explica cómo Cloud RADIUS mitiga la latencia de conmutación por error en recintos empresariales.
Video overview
Escucha esta guía
Ver transcripción del podcast
Parte de nuestra serie principal: Guía de seguridad de WiFi empresarial →
RADIUS high availability architecture and failover calculator
Model failover latency, accounting state integrity, and administrative overhead across Active-Passive, Active-Active on-premises clusters, and Cloud RADIUS architectures.
Active directory and MDM deployments benefit from automated certificate authentication. Active-Active or Cloud RADIUS prevents Monday morning authentication storms when hundreds of devices re-authenticate simultaneously.
Traffic is distributed across operational nodes. If one node fails, the load balancer removes it immediately from the active pool.
Need to eliminate RADIUS single points of failure across enterprise venues?
Purple Cloud RADIUS delivers native Active-Active multi-region resilience, zero-touch certificate lifecycle management, and 99.99% SLA over encrypted RadSec. Speak with our network architecture team.

Resumen ejecutivo
Para las redes empresariales, la autenticación es binaria: funciona a la perfección o las operaciones comerciales se detienen por completo. RADIUS (Remote Authentication Dial-In User Service) actúa como el guardián fundamental para las implementaciones de IEEE 802.1X, WPA3 enterprise y Guest WiFi en los establecimientos modernos. A diferencia de los servicios de aplicación que se degradan de manera gradual bajo carga, una falla de RADIUS bloquea de inmediato el acceso a la red de los usuarios, las terminales de punto de venta y los dispositivos operativos.
Esta guía de referencia técnica evalúa los modelos de arquitectura para implementar una infraestructura RADIUS de alta disponibilidad. Específicamente, contrasta las configuraciones tradicionales Activo-Pasivo con los clústeres modernos Activo-Activo. Para los gerentes de TI, arquitectos de red y directores de operaciones de establecimientos que administran entornos de alta densidad como Retail, Hospitality y estadios, es esencial comprender estas estrategias de failover, la mecánica de balanceo de carga y los requisitos de replicación de bases de datos.
Además, esta guía analiza cómo las plataformas Cloud RADIUS abstraen la complejidad de la alta disponibilidad, proporcionando un failover automático y una escalabilidad elástica sin la carga operativa de mantener una infraestructura redundante en las instalaciones. Al aplicar estas mejores prácticas independientes del proveedor, los equipos de ingeniería pueden diseñar arquitecturas de autenticación que eliminen los puntos únicos de falla y cumplan con los estrictos Acuerdos de Nivel de Servicio (SLA) de tiempo de actividad.
Análisis técnico detallado: Comprendiendo la arquitectura RADIUS
RADIUS opera como un protocolo cliente-servidor a través de UDP, utilizando típicamente el puerto 1812 para la autenticación y el puerto 1813 para la contabilidad, como se define en las normas RFC 2865 y RFC 2866. La naturaleza sin estado de las solicitudes de autenticación UDP representa una ventaja estructural para el diseño de alta disponibilidad. Debido a que cada paquete Access-Request contiene todas las credenciales y parámetros necesarios, cualquier servidor RADIUS dentro de un clúster puede procesar cualquier solicitud de forma independiente, sin necesidad de una sincronización de estado compleja para la fase de autenticación en sí.
Arquitectura Activo - Pasivo
En un despliegue Activo - Pasivo (o primario - reserva), un único servidor RADIUS procesa todo el tráfico entrante de autenticación y contabilidad. Un servidor secundario permanece en línea pero inactivo, recibiendo actualizaciones de replicación de la base de datos pero sin responder activamente a los Dispositivos de Acceso a la Red (NAD) como puntos de acceso, switches o gateways VPN.
Cuando el servidor primario falla, el NAD detecta la pérdida de tiempo de espera y redirige las solicitudes posteriores al servidor secundario. El tiempo de detección de falla depende completamente de los temporizadores de configuración del NAD. Un NAD típico envía una solicitud RADIUS y espera a que se agote el tiempo de espera predeterminado del paquete (a menudo dos segundos). Si no recibe respuesta, lo intenta de nuevo. Con una configuración estándar de tres intentos por servidor, el NAD puede esperar hasta seis segundos antes de declarar inactivo al servidor primario y transferir el servicio al secundario. En entornos con tres servidores configurados, esta ventana de transición por falla puede extenderse hasta dieciocho segundos. Para un lugar de Hospitality concurrido o un entorno de Retail que procesa transacciones, este retraso representa una interrupción notable del servicio.
Arquitectura Activo - Activo
Por el contrario, una arquitectura Activo - Activo distribuye la carga de autenticación entre múltiples servidores RADIUS operativos de forma simultánea. El tráfico se encauza hacia el clúster ya sea mediante una configuración de rotación (round-robin) en los NAD o a través de un balanceador de carga dedicado.
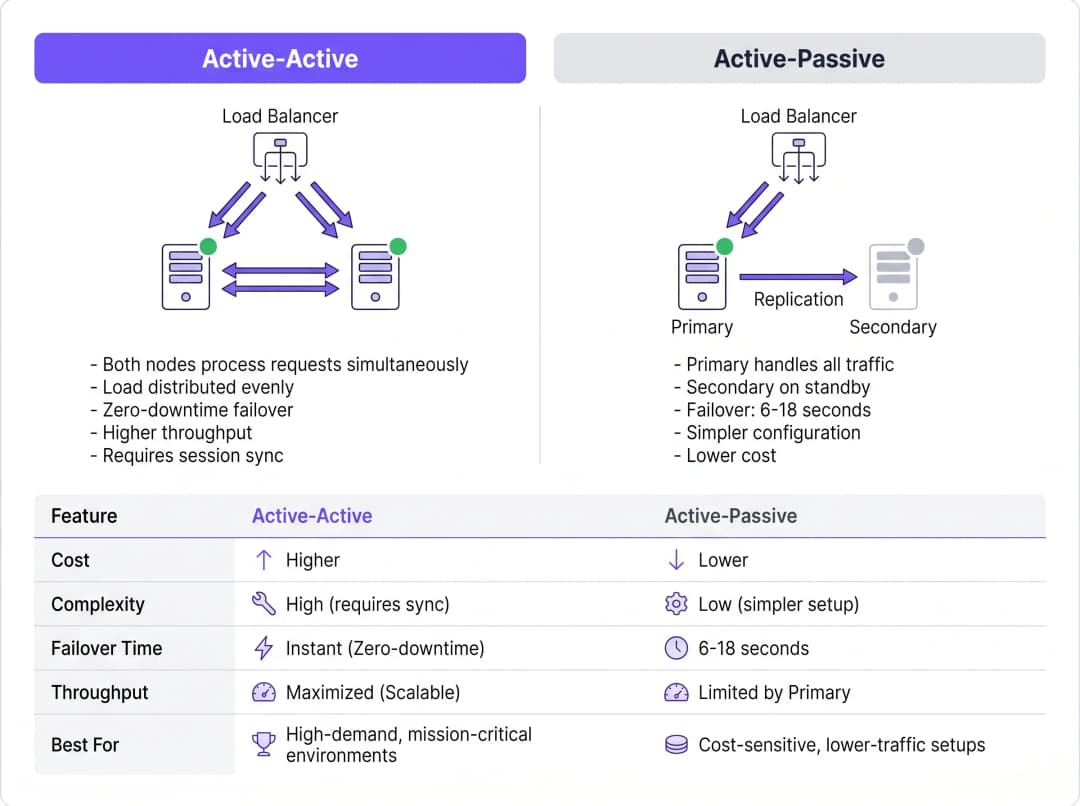
Este modelo elimina el retraso en la detección de fallas inherente a las configuraciones Activo - Pasivo. Si un nodo falla, el balanceador de carga (o los NAD que utilizan round-robin) simplemente deja de dirigir tráfico al servidor que no responde, típicamente en un lapso de uno a dos segundos basado en los intervalos de control de estado. Los nodos activos restantes absorben el tráfico de forma instantánea. Además, los clústeres Activo - Activo se escalan horizontalmente; agregar capacidad para eventos de alta densidad simplemente requiere aprovisionar nodos adicionales al clúster.
El desafío de la replicación de bases de datos
Mientras que la autenticación RADIUS es sin estado (stateless), la contabilidad RADIUS es inherentemente con estado (stateful). Realiza el seguimiento de la iniciación de la sesión (Start), el uso continuo (Interim-Update) y la terminación (Stop). Para los establecimientos que utilizan WiFi Analytics o sistemas de facturación, estos datos de contabilidad deben mantener la consistencia en todos los nodos.
Respaldar un clúster RADIUS con una base de datos replicada (como MySQL o MariaDB integrada con FreeRADIUS) es obligatorio para una alta disponibilidad sólida. Para implementaciones Activo-Activo, se requiere una replicación síncrona multi-maestro - como Galera Cluster o MySQL NDB Cluster. La replicación síncrona garantiza que un registro de contabilidad se confirme en todos los nodos simultáneamente, evitando la pérdida de datos si un nodo falla. La replicación asíncrona tradicional, a menudo utilizada en configuraciones Activo-Pasivo, introduce un retraso de replicación. Si el nodo primario falla antes de que el secundario reciba la actualización, los datos de la sesión activa se pierden permanentemente, lo que puede violar los marcos de cumplimiento normativo como PCI-DSS.
¿Tiene preguntas sobre su configuración específica?
Nuestro equipo trabaja con gestores de espacios, responsables de TI e ingenieros de redes en 80 000 establecimientos. Reserve una llamada de 20 minutos y le mostraremos cómo lo resolvieron otros profesionales como usted.
Guía de implementación: Nube frente a On-Premise
La decisión arquitectónica se extiende más allá de cómo agrupar los servidores en clúster; implica dónde residen esos servidores. Para los operadores con múltiples sitios, el retorno del tráfico de autenticación a un centro de datos on-premise centralizado introduce latencia de WAN y crea un punto único de falla en el enlace de la WAN.
Plataformas Cloud RADIUS
Los servicios Cloud RADIUS resuelven los desafíos de distribución geográfica al alojar la infraestructura de autenticación en múltiples zonas de disponibilidad globales. Cuando un usuario se conecta en una sucursal, la solicitud se enruta al nodo perimetral de la nube más cercano, minimizando la latencia.
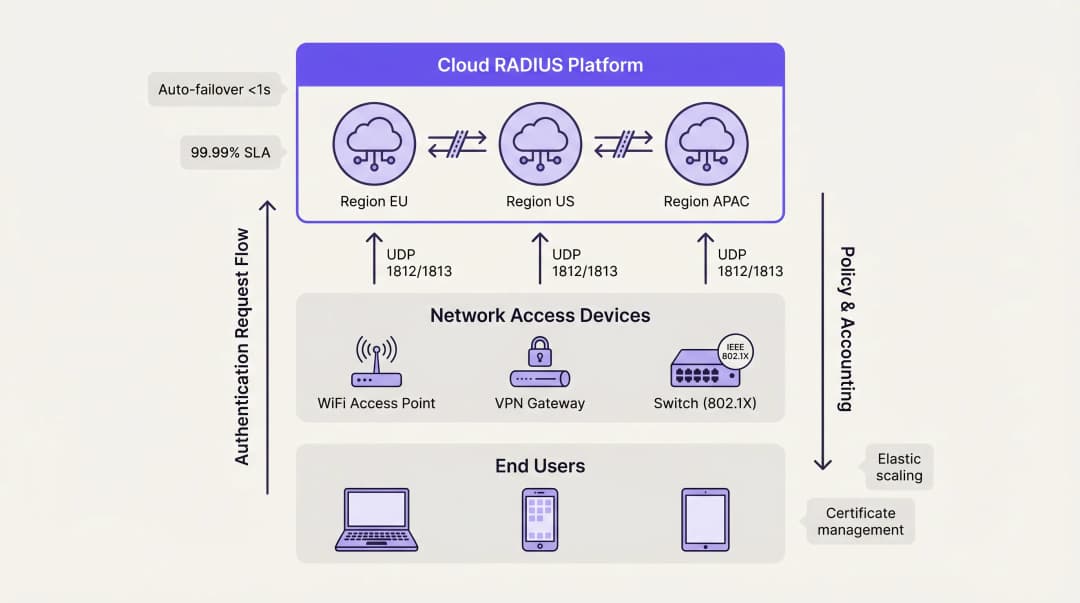
Las plataformas en la nube utilizan inherentemente arquitecturas Activo-Activo. El failover entre las zonas de disponibilidad es manejado automáticamente por el balanceo de carga interno del proveedor, abstrayendo por completo la complejidad para el equipo de ingeniería del cliente. Este modelo generalmente ofrece SLA de tiempo de actividad del 99.99% y elimina la necesidad de la gestión manual de certificados, el parcheo del sistema operativo y el ajuste de la replicación de la base de datos. Para las organizaciones que despliegan Wayfinding o Sensors en campus distribuidos, la autenticación alojada en la nube garantiza una aplicación coherente de las políticas sin dependencias de hardware localizado.
Consideraciones para implementaciones On-Premise
Las organizaciones que operan en sectores altamente regulados - como entornos gubernamentales o de Healthcare específicos - pueden requerir implementaciones on-premise debido a estrictos mandatos de soberanía de datos. En estos escenarios, implementar un clúster FreeRADIUS Activo-Activo con replicación síncrona de Galera proporciona el nivel más alto de resiliencia.
Sin embargo, los equipos de ingeniería deben tener en cuenta la carga operativa. Gestionar certificados TLS en múltiples nodos, garantizar la consistencia de la configuración y monitorear activamente la salud de la replicación de la base de datos requieren recursos administrativos dedicados. Los equilibradores de carga de hardware deben configurarse específicamente para admitir tráfico UDP con las pruebas de salud RADIUS adecuadas, ya que muchos equilibradores de carga estándar están optimizados únicamente para tráfico TCP HTTP/HTTPS.
Mejores prácticas para la alta disponibilidad de RADIUS
- Distribuir en lugar de duplicar: Para implementaciones que superen los 500 usuarios concurrentes, priorice las arquitecturas Activo-Activo sobre las configuraciones Activo-Pasivo para maximizar el rendimiento y minimizar la latencia de conmutación por error.
- Implementar replicación síncrona: Proteja los datos de contabilidad con estado utilizando una replicación de base de datos síncrona multi-maestro (por ejemplo, Galera Cluster) en lugar de modelos asíncronos de réplica primaria.
- Estandarizar la confianza de los certificados: En un clúster Activo-Activo, asegúrese de que todos los nodos presenten el mismo certificado de servidor o certificados de la misma cadena de Autoridad de Certificación (CA). Las discrepancias provocarán que los protocolos de enlace EAP-TLS y PEAP fallen durante la rotación de nodos.
- Ajustar los temporizadores de NAD: Optimice los temporizadores de reintento y tiempo de espera de RADIUS en sus dispositivos de acceso a la red. Un tiempo de espera de dos segundos con dos reintentos proporciona un equilibrio entre la detección rápida de conmutación por error y la prevención de una conmutación por error prematura durante una congestión menor de la red.
- Probar escenarios de falla: Trate los nodos secundarios como sistemas de producción. Simule regularmente fallas de nodos, desincronización de bases de datos y caídas de enlaces WAN para validar que los mecanismos automatizados de conmutación por error funcionen según lo diseñado.
Resolución de problemas y mitigación de riesgos
El modo de falla más frecuente en la alta disponibilidad de RADIUS es la desviación de la configuración. En las configuraciones Activo-Pasivo, los administradores suelen actualizar las políticas o renovar los certificados en el nodo primario pero descuidan el secundario. Cuando ocurre un evento de conmutación por error, el nodo secundario rechaza el tráfico legítimo debido a credenciales caducadas o políticas desactualizadas.
Para mitigar este riesgo, implemente herramientas de gestión de configuración (como Ansible o Terraform) para implementar cambios de manera simétrica en todos los nodos. Para la gestión de certificados, utilice protocolos de renovación automatizados (como ACME) configurados para distribuir el certificado actualizado en todo el clúster de forma simultánea.
Otro riesgo importante es la configuración incorrecta del equilibrador de carga. Si un equilibrador de carga no realiza pruebas de salud a nivel de aplicación (verificando específicamente la capacidad de respuesta del puerto UDP 1812), puede continuar enrutando el tráfico a un nodo donde el sistema operativo está funcionando pero el demonio RADIUS se ha caído. Asegúrese de que las pruebas de salud validen explícitamente la disponibilidad del servicio RADIUS.
ROI e impacto empresarial
El retorno de la inversión de una sólida alta disponibilidad de RADIUS se mide principalmente a través de la mitigación de riesgos y la eficiencia operativa. Las interrupciones de autenticación provocan pérdidas de productividad inmediatas para los empleados y un grave daño a la reputación de los establecimientos orientados al público.
Al realizar la transición de implementaciones manuales de un solo servidor a arquitecturas automatizadas Activo-Activo (particularmente a través de Cloud RADIUS), las organizaciones recuperan una cantidad significativa de horas de ingeniería que antes se dedicaban al mantenimiento de rutina. Esta eficiencia operativa permite a los equipos de red centrarse en iniciativas estratégicas, como la implementación de The Core SD WAN Benefits for Modern Businesses o la optimización de la cobertura de alta densidad, en lugar de apagar incendios por fallas de autenticación. En última instancia, una autenticación confiable es la capa fundamental de la que dependen todos los servicios de red posteriores.
Definiciones clave
Arquitectura Active-Active
Un diseño de alta disponibilidad donde múltiples servidores RADIUS procesan solicitudes de autenticación de forma simultánea, distribuyendo la carga y proporcionando una conmutación por error instantánea sin retrasos de detección.
Esencial para recintos de alta densidad (estadios, grandes tiendas de retail) donde un solo servidor no puede manejar los picos de aumento de autenticación.
Arquitectura Active-Passive
Un modelo de redundancia donde un servidor principal maneja todo el tráfico y un servidor secundario permanece inactivo en espera hasta que el principal falla.
Adecuada para implementaciones más pequeñas y sensibles a los costos, pero introduce un retraso de conmutación por error de 6 a 18 segundos mientras el dispositivo de acceso a la red detecta la falla.
Replicación síncrona
Un método de replicación de bases de datos en el que los datos se escriben en todos los nodos de un clúster simultáneamente antes de que la transacción se considere completa.
Obligatoria para las bases de datos de contabilidad RADIUS Active-Active (como Galera Cluster) para evitar la pérdida de datos y garantizar el cumplimiento.
Replicación asíncrona
Un método de replicación de base de datos donde el nodo primario registra los datos y luego los copia a los nodos secundarios, introduciendo un ligero retraso (lag).
A menudo se utiliza en configuraciones Activo-Pasivo, pero conlleva el riesgo de perder registros de contabilidad (accounting) recientes si el nodo primario falla abruptamente.
Network Access Device (NAD)
El componente de hardware (como un punto de acceso WiFi, switch o gateway VPN) que solicita la autenticación al servidor RADIUS en nombre del usuario.
Los temporizadores internos de reintento y tiempo de espera (timeout) del NAD dictan la rapidez con la que ocurre una conmutación por error (failover) Activo-Pasivo.
Protocolo sin estado (Stateless)
Un protocolo de comunicaciones que trata a cada solicitud como una transacción independiente, no relacionada con ninguna solicitud anterior.
La autenticación RADIUS sobre UDP es sin estado (stateless), lo que permite a los balanceadores de carga dirigir cualquier solicitud a cualquier servidor activo de manera fluida.
Desviación de configuración (Configuration Drift)
El fenómeno en el que los servidores secundarios o de respaldo se desincronizan con el servidor primario a lo largo del tiempo en relación con políticas, actualizaciones o certificados.
La causa principal de fallas en implementaciones RADIUS Activo-Pasivo cuando el nodo secundario se ve obligado a tomar el control.
Cloud RADIUS
Un servicio de autenticación gestionado y alojado en una infraestructura en la nube distribuida globalmente, que proporciona redundancia Activa-Activa integrada y escalabilidad automática.
Reemplaza la necesidad de que los equipos de TI construyan, parchen y monitoreen manualmente servidores RADIUS redundantes de manera local.
Ejemplos resueltos
Un grupo hotelero europeo gestiona 45 propiedades en seis países. Actualmente ejecutan máquinas virtuales FreeRADIUS independientes en cada propiedad. Un certificado TLS que expiró recientemente en una ubicación provocó una interrupción completa del servicio de WiFi para huéspedes durante una conferencia importante. ¿Cómo deberían rediseñar su arquitectura de autenticación para evitar interrupciones localizadas y reducir los gastos de mantenimiento?
El grupo hotelero debe migrar de instancias FreeRADIUS locales de un solo nodo a una plataforma centralizada de Cloud RADIUS que utilice una arquitectura Active-Active. Al aprovechar un proveedor de la nube con nodos perimetrales distribuidos geográficamente, las solicitudes de autenticación de cada propiedad se dirigen al nodo regional más cercano, lo que minimiza la latencia. La gestión centralizada de políticas permite al equipo de TI definir reglas de autenticación una sola vez y aplicarlas a nivel mundial. El proveedor de la nube se encarga automáticamente de la rotación de certificados TLS, el parcheo del sistema operativo y la replicación de la base de datos.
Un estadio deportivo nacional se está preparando para un evento de 60,000 asistentes. Su configuración actual de RADIUS es una configuración Active-Passive. Durante las pruebas de carga, el servidor principal se saturó al procesar 8,000 solicitudes de autenticación por minuto cuando se abrieron las puertas, lo que provocó graves retrasos en la conexión, mientras que el servidor secundario permaneció completamente inactivo. ¿Cómo pueden optimizar esta implementación?
El equipo de ingeniería de red debe convertir la implementación de Active-Passive a Active-Active. Primero, deben reconfigurar los dispositivos de acceso a la red (NAD) del estadio para utilizar el equilibrio de carga por turnos (round-robin) en ambos servidores RADIUS, duplicando instantáneamente su rendimiento de autenticación. Segundo, deben aprovisionar un tercer nodo RADIUS para proporcionar el margen necesario para los picos de demanda. Finalmente, para garantizar que los datos de contabilidad sigan siendo consistentes en los tres nodos activos, deben implementar una solución de replicación de base de datos multisigno síncrona, como Galera Cluster.
Preguntas de práctica
Q1. Su cliente de retail empresarial requiere una solución RADIUS de alta disponibilidad para sus terminales de punto de venta. Tienen requisitos estrictos de cumplimiento PCI-DSS que dictan que no se puede perder absolutamente ningún dato de sesión de contabilidad (accounting) durante una conmutación por error (failover) del servidor. ¿Qué estrategia de replicación de base de datos debe implementar para el backend de RADIUS?
Sugerencia: Considere la diferencia entre escribir datos de manera simultánea versus copiar los datos después de que ocurra el evento.
Ver respuesta modelo
Debe implementar la Replicación Síncrona (como un Galera Cluster o MySQL NDB Cluster). La replicación síncrona garantiza que el registro de contabilidad (accounting) se guarde en todos los nodos simultáneamente antes de confirmar la transacción. Si utilizara la replicación asíncrona, una falla en el nodo podría resultar en la pérdida de transacciones recientes que aún no se habían copiado a la base de datos secundaria, violando el estricto requisito de cumplimiento.
Q2. La red del campus de una universidad utiliza una configuración RADIUS Activo-Pasivo. Los estudiantes se quejan de que cuando el servidor primario entra en mantenimiento, sus laptops tardan casi 20 segundos en conectarse al WiFi. Los puntos de acceso están configurados con un tiempo de espera (timeout) de RADIUS de 3 segundos y 5 reintentos. ¿Cómo puede reducir el retraso de la conmutación por error (failover) sin cambiar la arquitectura del servidor?
Sugerencia: Calcule el tiempo de espera máximo basado en los temporizadores del NAD antes de que intente conectarse al servidor secundario.
Ver respuesta modelo
Debe ajustar los temporizadores en los Network Access Devices (puntos de acceso). Actualmente, el AP espera 3 segundos y realiza 5 reintentos, lo que resulta en un retraso de 18 segundos (3 segundos × 6 intentos totales) antes de conmutar por error al servidor pasivo. Al reducir la configuración a un tiempo de espera (timeout) de 2 segundos y 2 reintentos, el tiempo de detección de la conmutación por error (failover) disminuye a 6 segundos, mejorando significativamente la experiencia del usuario durante las ventanas de mantenimiento.
Q3. Está migrando una red corporativa multisitio desde un servidor RADIUS local Activo-Pasivo a una plataforma Cloud RADIUS Activa-Activa. Durante la fase piloto, los dispositivos se autentican correctamente en el Nodo de Nube A, pero cuando el balanceador de carga los dirige al Nodo de Nube B, los intercambios (handshakes) EAP-TLS fallan. ¿Cuál es el error de configuración más probable?
Sugerencia: Considere lo que el dispositivo cliente verifica al establecer un túnel EAP seguro con un nuevo servidor.
Ver respuesta modelo
El problema más probable es una discrepancia en la confianza del certificado (Certificate Trust). En un clúster Activo-Activo, todos los nodos RADIUS deben presentar exactamente el mismo certificado de servidor (o certificados emitidos por la misma cadena de CA de confianza). Si el Nodo de Nube B presenta un certificado diferente en el que los dispositivos cliente no confían, el intercambio (handshake) EAP-TLS será rechazado por el cliente, lo que provocará que la autenticación falle a pesar de que el servidor funcione correctamente.
Continúe leyendo esta serie
Resolución de problemas de 802.1X en iOS y macOS: una lista de verificación de implementación para Intune, Jamf y Microsoft Entra ID
Use esta lista de verificación para diagnosticar por qué los iPhones, iPads y Macs fallan al conectarse a 802.1X en Intune o Jamf Pro. Cada falla se debe a una de cuatro causas: confianza en el servidor, certificado de identidad, modo de macOS o alcance de grupo de Microsoft Entra ID. Confirmará la causa mediante los registros de eapolclient y RADIUS, aplicará la solución y programará las futuras rotaciones de certificados.
Confianza en servidor de perfil de WiFi de Intune: nombres de servidor de certificado y lista de verificación de CA raíz para Microsoft Entra ID
Podrá configurar la parte de validación de servidor de un perfil de WiFi de Intune para que EAP-TLS y PEAP se conecten en Windows, Apple y Android. Hará coincidir los nombres de servidor de certificado con el certificado RADIUS, implementará la CA raíz correcta, alineará las asignaciones de grupos de Microsoft Entra ID y programará las renovaciones de certificados antes de que interrumpan las conexiones de forma silenciosa.
Resolución de problemas de Android 802.1X y EAP-TLS: una lista de verificación de implementación para Intune y Microsoft Entra ID
Podrá identificar con precisión por qué los teléfonos Android administrados fallan al usar EAP-TLS en su SSID de personal y solucionarlo en Intune. Relacione cada síntoma con las cuatro causas habituales: falta de CA o dominio, certificado de cliente en el perfil incorrecto, un valor de nombres de servidor RADIUS no coincidente o una raíz de confianza no entregada. Luego, aplique una lista de verificación de implementación que evite interrupciones repetidas.
¿Tiene preguntas sobre su configuración específica?
Nuestro equipo trabaja con gestores de espacios, responsables de TI e ingenieros de redes en 80 000 establecimientos. Reserve una llamada de 20 minutos y le mostraremos cómo lo resolvieron otros profesionales como usted.