
Alta disponibilità del server RADIUS: Active-Active vs Active-Passive
Una guida di riferimento tecnica e definitiva per IT manager e architetti di rete che valutano le architetture ad alta disponibilità RADIUS. Mette a confronto le distribuzioni Active-Active e Active-Passive, dettaglia i requisiti di replica del database e spiega come il Cloud RADIUS attenui la latenza di failover per le sedi aziendali.
Video overview
Ascolta questa guida
Visualizza trascrizione del podcast
Parte della nostra serie principale: Enterprise WiFi Security Guide →
RADIUS high availability architecture and failover calculator
Model failover latency, accounting state integrity, and administrative overhead across Active-Passive, Active-Active on-premises clusters, and Cloud RADIUS architectures.
Active directory and MDM deployments benefit from automated certificate authentication. Active-Active or Cloud RADIUS prevents Monday morning authentication storms when hundreds of devices re-authenticate simultaneously.
Traffic is distributed across operational nodes. If one node fails, the load balancer removes it immediately from the active pool.
Need to eliminate RADIUS single points of failure across enterprise venues?
Purple Cloud RADIUS delivers native Active-Active multi-region resilience, zero-touch certificate lifecycle management, and 99.99% SLA over encrypted RadSec. Speak with our network architecture team.

Executive Summary
Per le reti aziendali, l'autenticazione è binaria: o funziona perfettamente, o le attività aziendali si interrompono del tutto. Il RADIUS (Remote Authentication Dial-In User Service) funge da custode critico per le distribuzioni IEEE 802.1X, WPA3 enterprise e Guest WiFi nelle strutture moderne. A differenza dei servizi applicativi che si degradano gradualmente sotto carico, un guasto del RADIUS blocca immediatamente l'accesso alla rete a utenti, terminali punto vendita e dispositivi operativi.
Questa guida di riferimento tecnico valuta i modelli architetturali per la distribuzione di un'infrastruttura RADIUS ad alta disponibilità. Nello specifico, mette a confronto le tradizionali configurazioni Attivo-Passivo con i moderni cluster Attivo-Attivo. Per i responsabili IT, gli architetti di rete e i direttori delle operazioni delle strutture che gestiscono ambienti ad alta densità come Retail, Hospitality e stadi, comprendere queste strategie di failover, i meccanismi di bilanciamento del carico e i requisiti di replica del database è fondamentale.
Inoltre, questa guida esamina come le piattaforme Cloud RADIUS riducano la complessità dell'alta disponibilità, offrendo failover automatico e scalabilità elastica senza l'onere operativo di mantenere un'infrastruttura ridondante in loco. Applicando queste best practice indipendenti dai fornitori, i team di ingegneria possono progettare architetture di autenticazione che eliminano i singoli punti di vulnerabilità e soddisfano rigorosi accordi sul livello del servizio (SLA) per il tempo di attività.
Approfondimento Tecnico: Capire l'Architettura RADIUS
RADIUS opera come un protocollo client-server su UDP, utilizzando tipicamente la porta 1812 per l'autenticazione e la porta 1813 per l'accounting, come definito nelle specifiche RFC 2865 e RFC 2866. La natura stateless delle richieste di autenticazione UDP rappresenta un vantaggio strutturale per la progettazione ad alta disponibilità. Poiché ogni pacchetto Access-Request contiene tutte le credenziali e i parametri necessari, qualsiasi server RADIUS all'interno di un cluster può elaborare qualsiasi richiesta in modo indipendente, senza richiedere una complessa sincronizzazione dello stato per la fase di autenticazione stessa.
Architettura Attiva-Passiva
In una distribuzione Attiva-Passiva (o primary-standby), un singolo server RADIUS elabora tutto il traffico di autenticazione e accounting in entrata. Un server secondario rimane online ma inattivo, ricevendo gli aggiornamenti di replica del database ma senza rispondere attivamente ai Network Access Devices (NAD) come access point, switch o gateway VPN.
Quando il server primario si guasta, il NAD rileva il timeout e reindirizza le richieste successive al server secondario. Il tempo di rilevamento del failover dipende interamente dai timer di configurazione del NAD. Un NAD tipico invia una richiesta RADIUS e attende un timeout predefinito del pacchetto (spesso due secondi). Se non riceve alcuna risposta, riprova. Con una configurazione standard di tre tentativi per server, il NAD potrebbe attendere fino a sei secondi prima di dichiarare non funzionante il server primario ed effettuare il failover su quello secondario. Negli ambienti con tre server configurati, questa finestra di failover può estendersi fino a diciotto secondi. Per una struttura affollata nel settore dell' Hospitality o per un ambiente Retail che elabora transazioni, questo ritardo rappresenta un'interruzione percepibile del servizio.
Architettura Attiva-Attiva
Al contrario, un'architettura Attiva-Attiva distribuisce il carico di autenticazione su più server RADIUS operativi contemporaneamente. Il traffico viene instradato al cluster tramite la configurazione round-robin sui NAD o attraverso un load balancer dedicato.
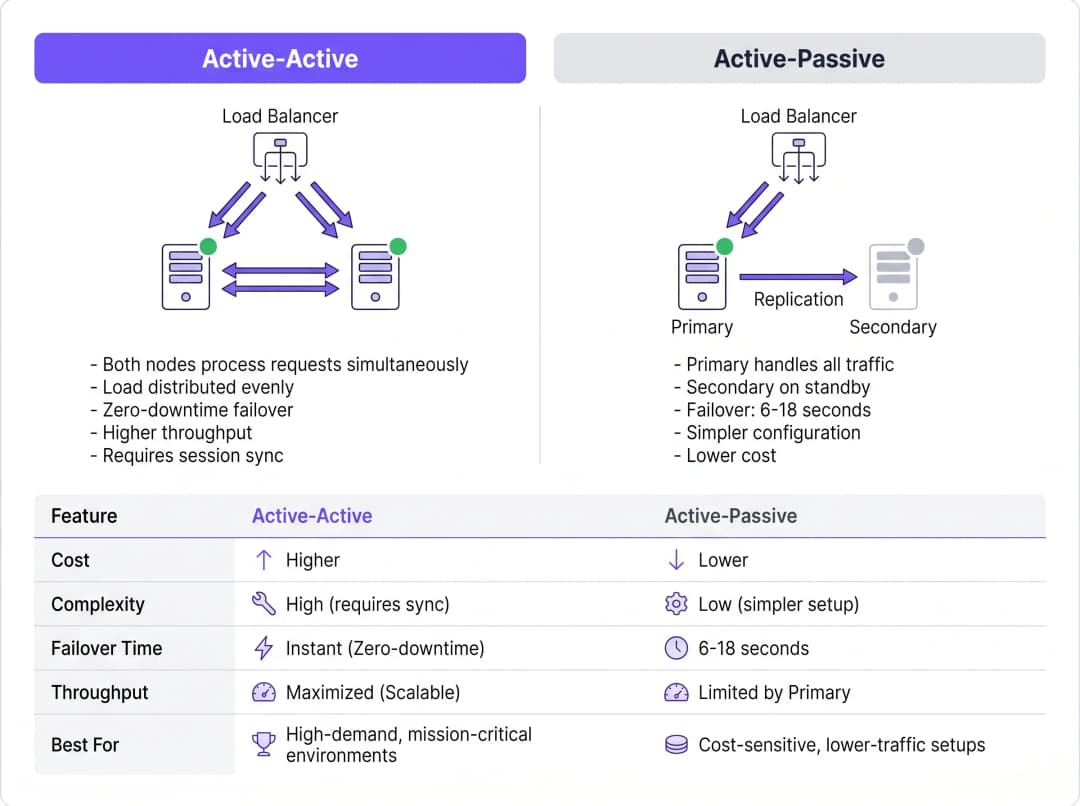
Questo modello elimina il ritardo di rilevamento del failover intrinseco nelle configurazioni Attive-Passive. Se un nodo si guasta, il load balancer (o i NAD che utilizzano il round-robin) smette semplicemente di instradare il traffico verso il server che non risponde, in genere entro uno o due secondi in base agli intervalli di health-check. I restanti nodi attivi assorbono istantaneamente il traffico. Inoltre, i cluster Attivi-Attivi scalano orizzontalmente; l'aggiunta di capacità per eventi ad alta densità richiede semplicemente la fornitura di nodi aggiuntivi al cluster.
La Sfida della Replica del Database
Mentre l'autenticazione RADIUS è stateless, l'accounting RADIUS è intrinsecamente stateful. Monitora l'avvio della sessione (Start), l'uso continuativo (Interim-Update) e il termine (Stop). Per i locali che utilizzano WiFi Analytics o sistemi di fatturazione, questi dati di accounting devono rimanere coerenti su tutti i nodi.
Supportare un cluster RADIUS con un database replicato (come MySQL o MariaDB integrato con FreeRADIUS) è obbligatorio per una solida alta affidabilità. Per i deployment Active-Active, è richiesta la replica sincrona multi-master - come Galera Cluster o MySQL NDB Cluster. La replica sincrona garantisce che un record di accounting sia registrato su tutti i nodi contemporaneamente, prevenendo la perdita di dati in caso di guasto di un nodo. La tradizionale replica asincrona, spesso utilizzata nelle configurazioni Active-Passive, introduce un ritardo di replica. Se il nodo primario si guasta prima che il secondario riceva l'aggiornamento, i dati della sessione attiva vanno persi in modo permanente, il che può violare i framework di conformità come PCI-DSS.
Hai domande sulla tua configurazione specifica?
Il nostro team collabora con gestori di sedi, responsabili IT e ingegneri di rete in 80.000 sedi. Prenota una chiamata di 20 minuti e ti mostreremo come altri professionisti come te hanno risolto il problema.
Guida all'implementazione: Cloud vs On-Premise
La decisione architetturale va oltre le modalità di clustering dei server; riguarda il luogo in cui tali server risiedono. Per gli operatori multi-sito, il backhauling del traffico di autenticazione verso un data center on-premise centralizzato introduce latenza WAN e crea un singolo punto di vulnerabilità sul collegamento WAN.
Piattaforme Cloud RADIUS
I servizi Cloud RADIUS risolvono le sfide della distribuzione geografica ospitando l'infrastruttura di autenticazione in più zone di disponibilità globali. Quando un utente si connette in una sede periferica, la richiesta viene instradata al nodo cloud edge più vicino, riducendo al minimo la latenza.
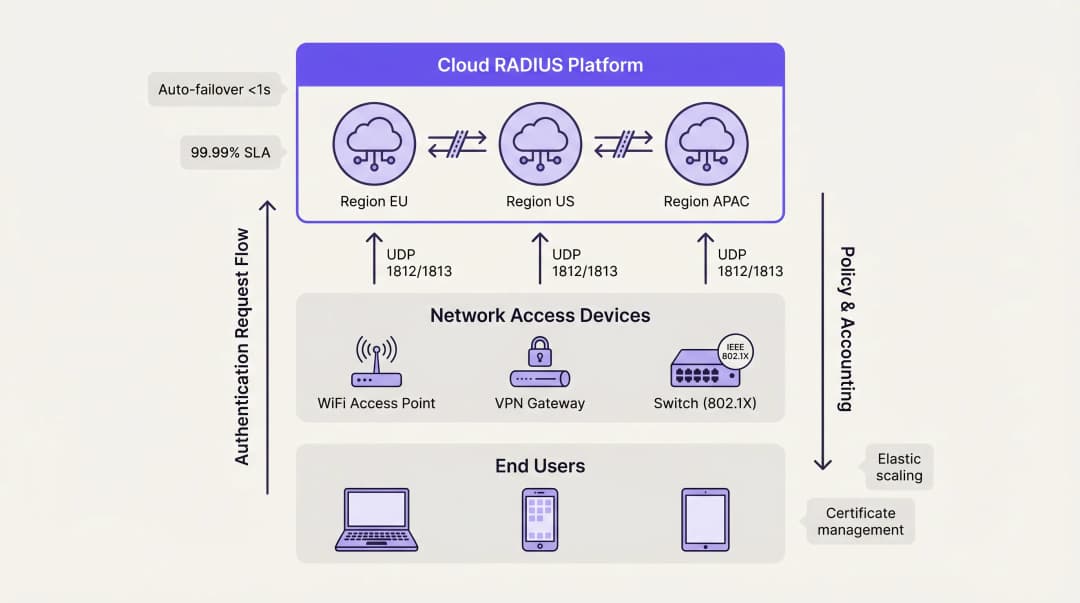
Piattaforme Cloud utilizzano intrinsecamente architetture Active-Active. Il failover tra le zone di disponibilità è gestito automaticamente dal bilanciamento del carico interno del provider, eliminando completamente la complessità per il team di ingegneria del cliente. Questo modello offre in genere SLA di uptime del 99,99% ed elimina la necessità di gestione manuale dei certificati, patch del sistema operativo e ottimizzazione della replica del database. Per le organizzazioni che distribuiscono Wayfinding o Sensors in campus distribuiti, l'autenticazione ospitata nel cloud garantisce l'applicazione coerente delle policy senza dipendenze da hardware localizzato.
Considerazioni sul deployment On-Premise
Le organizzazioni che operano in settori altamente regolamentati - come specifici contesti di Healthcare o governativi - potrebbero richiedere deployment on-premise a causa di rigidi mandati di sovranità dei dati. In questi scenari, il deployment di un cluster FreeRADIUS Active-Active con replica sincrona Galera offre il massimo livello di resilienza. Tuttavia, i team di ingegneria devono tenere conto del sovraccarico operativo. La gestione dei certificati TLS su più nodi, la garanzia di coerenza nella configurazione e il monitoraggio attivo dello stato di replica del database richiedono risorse amministrative dedicate. I bilanciatori di carico hardware devono essere configurati in modo specifico per supportare il traffico UDP con controlli di integrità RADIUS appropriati, poiché molti bilanciatori di carico standard sono ottimizzati esclusivamente per il traffico TCP HTTP/HTTPS.
Best Practice per l'Alta Affidabilità RADIUS
- Distribuire Anziché Duplicare: Per distribuzioni che superano i 500 utenti simultanei, dare priorità alle architetture Active-Active rispetto alle configurazioni Active-Passive per massimizzare il throughput e ridurre al minimo la latenza di failover.
- Implementare la Replica Sincrona: Proteggere i dati di accounting stateful utilizzando la replica sincrona del database multi-master (ad esempio, Galera Cluster) anziché i modelli asincroni primario-replica.
- Standardizzare il Certificato di Attendibilità: In un cluster Active-Active, assicurarsi che tutti i nodi presentino lo stesso certificato server o certificati provenienti dalla stessa identica catena di Certificate Authority (CA). Eventuali discrepanze causeranno il fallimento degli handshake EAP-TLS e PEAP durante la rotazione dei nodi.
- Ottimizzare i Timer NAD: Ottimizzare i timer di timeout e di tentativo RADIUS sui Network Access Devices. Un timeout di due secondi con due tentativi offre un equilibrio ottimale tra il rilevamento rapido del failover e la prevenzione di failover prematuri durante una lieve congestione della rete.
- Testare gli Scenari di Errore: Trattare i nodi secondari come sistemi di produzione. Simulare regolarmente guasti ai nodi, desincronizzazione del database e interruzioni del collegamento WAN per verificare che i meccanismi di failover automatizzati funzionino come previsto.
Risoluzione dei Problemi e Mitigazione dei Rischi
La modalità di guasto più comune nell'alta affidabilità RADIUS è il disallineamento della configurazione (configuration drift). Nelle configurazioni Active-Passive, gli amministratori aggiornano frequentemente i criteri o rinnovano i certificati sul nodo primario ma trascurano il secondario. Quando si verifica un evento di failover, il nodo secondario rifiuta il traffico legittimo a causa di credenziali scadute o criteri obsoleti.
Per mitigare questo rischio, implementare strumenti di gestione della configurazione (come Ansible o Terraform) per distribuire le modifiche in modo simmetrico su tutti i nodi. Per la gestione dei certificati, utilizzare protocolli di rinnovo automatico (come ACME) configurati per distribuire contemporaneamente il certificato aggiornato a livello di intero cluster.
Un altro rischio significativo è la configurazione errata del bilanciatore di carico. Se un bilanciatore di carico non esegue controlli di integrità a livello applicativo (verificando specificamente la reattività della porta UDP 1812), potrebbe continuare a instradare il traffico verso un nodo in cui il sistema operativo è in esecuzione ma il daemon RADIUS si è arrestato in modo anomalo. Assicurarsi che i controlli di integrità verifichino esplicitamente la disponibilità del servizio RADIUS.
ROI e Impatto Aziendale
Il ritorno sull'investimento per una solida alta disponibilità RADIUS si misura principalmente attraverso la mitigazione del rischio e l'efficienza operativa. Le interruzioni dell'autenticazione causano immediate perdite di produttività per i dipendenti e gravi danni d'immagine per le strutture aperte al pubblico.
Passando da distribuzioni manuali a server singolo ad architetture automatiche Attivo-Attivo (in particolare tramite Cloud RADIUS), le organizzazioni recuperano ore preziose di ingegneria precedentemente dedicate alla manutenzione ordinaria. Questa efficienza operativa consente ai team di rete di concentrarsi su iniziative strategiche, come la distribuzione di The Core SD WAN Benefits for Modern Businesses o l'ottimizzazione della copertura ad alta densità, piuttosto che sulla risoluzione d'emergenza dei problemi di autenticazione. In definitiva, un'autenticazione affidabile è il livello fondamentale su cui dipendono tutti i servizi di rete successivi.
Definizioni chiave
Architettura Active-Active
Un design ad alta disponibilità in cui più server RADIUS elaborano simultaneamente le richieste di autenticazione, distribuendo il carico e fornendo un failover istantaneo senza ritardi di rilevamento.
Essenziale per sedi ad alta densità (stadi, grandi spazi commerciali) dove un singolo server non è in grado di gestire i picchi di richieste di autenticazione.
Architettura Active-Passive
Un modello di ridondanza in cui un server primario gestisce tutto il traffico e un server secondario rimane inattivo in standby fino a quando il primario non si guasta.
Adatta per installazioni più piccole e attente ai costi, introduce tuttavia un ritardo di failover di 6 - 18 secondi mentre il dispositivo di accesso alla rete rileva il guasto.
Replica sincrona
Un metodo di replica del database in cui i dati vengono scritti simultaneamente su tutti i nodi di un cluster prima che la transazione sia considerata completata.
Obbligatoria per i database di accounting RADIUS Active-Active (come Galera Cluster) per prevenire la perdita di dati e garantire la conformità.
Replica asincrona
Un metodo di replica del database in cui il nodo primario registra i dati e successivamente li copia sui nodi secondari, introducendo un leggero ritardo (lag).
Spesso utilizzato in configurazioni Attivo-Passivo ma comporta il rischio di perdere i record di accounting recenti se il nodo primario si arresta improvvisamente.
Network Access Device (NAD)
Il componente hardware (come un access point WiFi, uno switch o un gateway VPN) che richiede l'autenticazione al server RADIUS per conto dell'utente.
I timer di timeout e di tentativi interni del NAD determinano la rapidità con cui si verifica un failover Attivo-Passivo.
Stateless Protocol
Un protocollo di comunicazione che tratta ogni richiesta come una transazione indipendente, non correlata a nessuna richiesta precedente.
L'autenticazione RADIUS su UDP è stateless, consentendo ai bilanciatori di carico di instradare qualsiasi richiesta a qualsiasi server attivo in modo trasparente.
Configuration Drift
Il fenomeno per cui i server secondari o di backup perdono la sincronizzazione con il server primario nel tempo riguardo a policy, aggiornamenti o certificati.
La causa principale di errore nelle implementazioni RADIUS Attivo-Passivo quando il nodo secondario è costretto a subentrare.
Cloud RADIUS
Un servizio di autenticazione gestito ospitato su un'infrastruttura cloud distribuita a livello globale, che offre ridondanza Attivo-Attivo integrata e scalabilità automatica.
Sostituisce la necessità per i team IT di creare, aggiornare e monitorare manualmente i server RADIUS on-premise ridondanti.
Esempi pratici
Un gruppo alberghiero europeo gestisce 45 proprietà in sei paesi. Attualmente esegue macchine virtuali FreeRADIUS indipendenti in ciascuna struttura. La recente scadenza di un certificato TLS in una delle sedi ha causato un'interruzione totale della rete WiFi per gli ospiti durante un'importante conferenza. Come dovrebbero riprogettare la loro architettura di autenticazione per prevenire interruzioni localizzate e ridurre i costi di manutenzione?
Il gruppo alberghiero dovrebbe migrare dalle istanze FreeRADIUS locali a nodo singolo a una piattaforma Cloud RADIUS centralizzata che utilizzi un'architettura Active-Active. Sfruttando un provider cloud con nodi edge distribuiti geograficamente, le richieste di autenticazione di ciascuna proprietà vengono instradate al nodo regionale più vicino, riducendo al minimo la latenza. La gestione centralizzata delle policy consente al team IT di definire le regole di autenticazione una sola volta e applicarle a livello globale. Il provider cloud gestisce automaticamente la rotazione dei certificati TLS, le patch del sistema operativo e la replica del database.
Uno stadio sportivo nazionale si sta preparando per un evento da 60.000 partecipanti. L'attuale configurazione RADIUS è di tipo Active-Passive. Durante i test di carico, il server primario si è saturato elaborando 8.000 richieste di autenticazione al minuto all'apertura dei cancelli, causando gravi ritardi di connessione, mentre il server secondario è rimasto completamente inattivo. Come possono ottimizzare questa installazione?
Il team di ingegneria di rete deve convertire la configurazione da Active-Passive ad Active-Active. In primo luogo, deve riconfigurare i Network Access Devices (NAD) dello stadio per utilizzare il bilanciamento del carico round-robin su entrambi i server RADIUS, raddoppiando istantaneamente la capacità di elaborazione delle autenticazioni. In secondo luogo, deve predisporre un terzo nodo RADIUS per fornire il margine necessario per i picchi di traffico. Infine, per garantire la coerenza dei dati di accounting su tutti e tre i nodi attivi, è necessario implementare una soluzione di replica sincrona del database multi-master, come Galera Cluster.
Domande di esercitazione
Q1. Il tuo cliente aziendale nel settore retail richiede una soluzione RADIUS ad alta disponibilità per i suoi terminali POS. Hanno requisiti rigorosi di conformità PCI-DSS che impongono che nessun dato di sessione di accounting possa essere perso durante il failover di un server. Quale strategia di replica del database devi implementare per il backend RADIUS?
Suggerimento: Considera la differenza tra i dati scritti contemporaneamente e i dati copiati successivamente.
Visualizza risposta modello
È necessario implementare la replica sincrona (come un Galera Cluster o MySQL NDB Cluster). La replica sincrona garantisce che il record di accounting venga registrato su tutti i nodi contemporaneamente prima di confermare la transazione. Se utilizzassi la replica asincrona, il guasto di un nodo potrebbe causare la perdita delle transazioni recenti non ancora copiate nel database secondario, violando il rigoroso requisito di conformità.
Q2. La rete di un campus universitario utilizza una configurazione RADIUS Attivo-Passivo. Gli studenti lamentano che, quando il server primario è in manutenzione, i loro laptop impiegano quasi 20 secondi per connettersi al WiFi. Gli access point sono configurati con un timeout RADIUS di 3 secondi e 5 tentativi. Come puoi ridurre il ritardo del failover senza modificare l'architettura del server?
Suggerimento: Calcola il tempo massimo di attesa in base ai timer del NAD prima che questo tenti di connettersi al server secondario.
Visualizza risposta modello
È necessario regolare i timer sui Network Access Devices (access point). Attualmente, l'AP attende 3 secondi e riprova 5 volte, determinando un ritardo di 18 secondi (3 secondi × 6 tentativi totali) prima di passare al server passivo. Riducendo la configurazione a un timeout di 2 secondi e 2 tentativi, il tempo di rilevamento del failover scende a 6 secondi, migliorando notevolmente l'esperienza utente durante le finestre di manutenzione.
Q3. Stai migrando una rete aziendale multi-sede da un server RADIUS on-premise Attivo-Passivo a una piattaforma Cloud RADIUS Attivo-Attivo. Durante la fase pilota, i dispositivi si autenticano con successo sul Nodo Cloud A, ma quando il bilanciatore di carico li instrada al Nodo Cloud B, gli handshake EAP-TLS falliscono. Qual è l'errore di configurazione più probabile?
Suggerimento: Considera cosa verifica il dispositivo client quando stabilisce un tunnel EAP sicuro con un nuovo server.
Visualizza risposta modello
Il problema più probabile è una mancata corrispondenza della attendibilità del certificato. In un cluster Attivo-Attivo, tutti i nodi RADIUS devono presentare lo stesso identico certificato server (o certificati emessi dalla stessa identica catena di CA attendibili). Se il Nodo Cloud B presenta un certificato diverso che i dispositivi client non considerano attendibile, l'handshake EAP-TLS verrà rifiutato dal client, causando il fallimento dell'autenticazione nonostante il corretto funzionamento del server.
Continua a leggere questa serie
Risoluzione dei problemi 802.1X su iOS e macOS: una checklist di distribuzione per Intune, Jamf e Microsoft Entra ID
Utilizza questa checklist per diagnosticare i motivi per cui iPhone, iPad e Mac non riescono a completare l'autenticazione 802.1X su Intune o Jamf Pro. Ogni errore è riconducibile a una di quattro cause: attendibilità del server, certificato di identità, modalità macOS o ambito del gruppo Microsoft Entra ID. Confermerai la causa dai log di eapolclient e RADIUS, applicherai la correzione e pianificherai le future rotazioni dei certificati.
Attendibilità server per profilo WiFi Intune: elenco di controllo dei nomi dei server certificati e della CA radice per Entra ID
Sarai in grado di configurare la convalida lato server di un profilo WiFi Intune in modo che EAP-TLS e PEAP si connettano su Windows, Apple e Android. Associerai i nomi dei server dei certificati al certificato RADIUS, distribuirai la CA radice corretta, allineerai le assegnazioni dei gruppi Entra ID e pianificherai i rinnovi dei certificati prima che interrompano silenziosamente le connessioni.
Risoluzione dei problemi Android 802.1X ed EAP-TLS: una checklist di implementazione per Intune e Microsoft Entra ID
Sarà possibile individuare esattamente perché i telefoni Android gestiti non riescono a eseguire EAP-TLS sul vostro SSID del personale e risolvere il problema in Intune. Abbinate ogni sintomo alle quattro cause principali - CA o dominio mancanti, certificato client nel profilo errato, un valore dei nomi dei server RADIUS non corrispondente o una root attendibile non consegnata. Applicate poi una checklist di roll-out che previene il ripetersi di interruzioni.
Hai domande sulla tua configurazione specifica?
Il nostro team collabora con gestori di sedi, responsabili IT e ingegneri di rete in 80.000 sedi. Prenota una chiamata di 20 minuti e ti mostreremo come altri professionisti come te hanno risolto il problema.