
¿Por qué nuestro WiFi de invitados es tan lento? Diagnóstico de la congestión de red
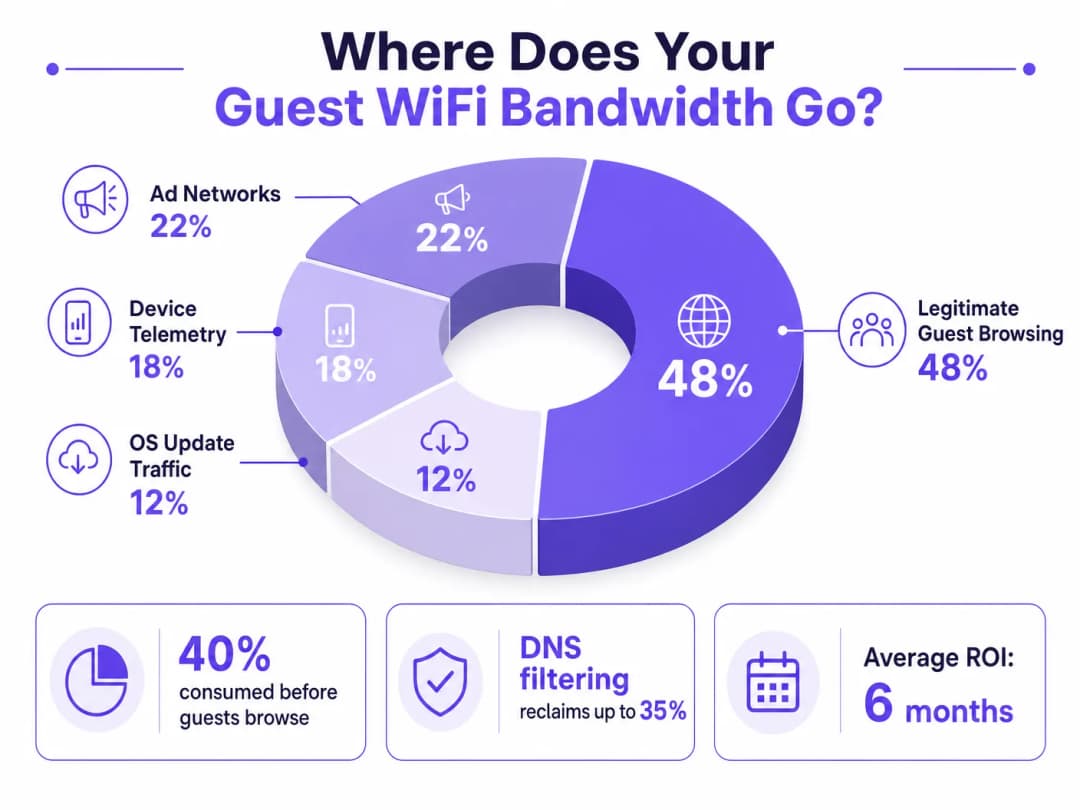
Esta guía diagnostica los factores ocultos de la congestión del WiFi de invitados - telemetría en segundo plano, redes de anuncios programáticos y actualizaciones automáticas del sistema operativo - que colectivamente consumen hasta el 40% del ancho de banda del WiFi público antes incluso de que un invitado abra un navegador. Proporciona un marco de implementación por fases y neutral respecto al proveedor para el filtrado DNS y las políticas de QoS que recuperan ese ancho de banda, mejoran la experiencia del invitado y ofrecen un ROI cuantificable. Dirigido a Directores de TI y Directores de Operaciones en los sectores de hostelería, retail, eventos y entornos del sector público.
Video overview
Escuchar esta guía
Ver transcripción del podcast
Parte de nuestra serie principal: Guía de WiFi de invitados →
Resumen ejecutivo
Para los directores de TI y responsables de operaciones que gestionan espacios de alta densidad, garantizar una experiencia de WiFi de invitados fiable es una batalla constante contra la congestión de la red. Mientras que los enfoques tradicionales se centran en aumentar el ancho de banda general o desplegar puntos de acceso adicionales, la causa principal de la lentitud en la transferencia de datos a menudo no radica en el tráfico legítimo de los usuarios, sino en la capa oculta de datos en segundo plano. En los entornos modernos (desde complejos hoteleros del sector de Hospitality hasta espacios de Retail con gran afluencia de público), hasta el 40 % del ancho de banda de la red WiFi pública es consumido por la telemetría de los dispositivos, las redes publicitarias programáticas y las actualizaciones automáticas del sistema operativo antes incluso de que un invitado abra un navegador.
Esta guía técnica de referencia proporciona una metodología definitiva para diagnosticar esta congestión e implementar una mitigación estratégica. Al desplegar el filtrado DNS a nivel de red y las Zonas de Política de Respuesta (RPZ), los arquitectos de redes empresariales pueden recuperar una cantidad significativa de ancho de banda, reducir la latencia y mejorar drásticamente la experiencia del usuario final sin incurrir en los gastos de capital que conllevan las actualizaciones de infraestructura. Exploraremos la arquitectura técnica de estas soluciones, casos prácticos de implementación en el mundo real y el ROI cuantificable de recuperar el control de su red.
Technical Deep-Dive
Anatomía de la congestión en segundo plano
Cuando un dispositivo de invitado se autentica en una red pública, inicia de inmediato una avalancha de conexiones en segundo plano. Estas conexiones se deben principalmente a tres categorías de tráfico que, en conjunto, constituyen lo que los ingenieros de red denominan carga fantasma: el ancho de banda consumido por la red antes de que se produzca cualquier actividad deliberada por parte del invitado.
1. Telemetría y analítica de dispositivos
Los sistemas operativos modernos (iOS, Android, Windows) y las aplicaciones instaladas transmiten constantemente datos de uso, métricas de ubicación, informes de fallos y análisis de comportamiento a servidores remotos. En un entorno denso, como un centro de Transport o un palacio de congresos, miles de dispositivos que transmiten simultáneamente paquetes de telemetría pequeños pero frecuentes pueden agotar el tiempo de transmisión inalámbrica disponible y saturar las tablas NAT. Un único dispositivo iOS puede generar más de 200 consultas DNS distintas en segundo plano durante los primeros 60 segundos tras conectarse a una red no medida.
2. Redes de publicidad programática
Muchas aplicaciones gratuitas dependen de ecosistemas de publicidad programática. En el momento en que un dispositivo detecta una conexión WiFi no medida, estas aplicaciones comienzan a descargar de forma anticipada anuncios de vídeo, banners de alta resolución y scripts de seguimiento desde plataformas de intercambio de publicidad. Este tráfico consume un gran ancho de banda y es muy sensible a la latencia, por lo que competirá agresivamente por el tiempo de transmisión con la navegación legítima de los invitados. El análisis de las redes de espacios públicos demuestra de forma constante que el tráfico de publicidad programática representa entre el 15 y el 22% de la utilización total de la WAN durante las horas punta.
3. Actualizaciones automáticas de aplicaciones y sistemas operativos
Sin una regulación adecuada del tráfico, los dispositivos intentarán descargar parches pesados del sistema operativo y actualizaciones de aplicaciones tan pronto como detecten una conexión WiFi no medida. Una sola actualización importante de iOS puede tener un tamaño de entre 3 y 5 GB. En un entorno de 500 dispositivos, un activador de actualización simultánea - común cuando se lanza una nueva versión del sistema operativo - puede saturar incluso un enlace WAN de 1 Gbps en cuestión de minutos.
Por qué las soluciones tradicionales se quedan cortas
La respuesta convencional a la congestión de la red WiFi de invitados consiste en aumentar el ancho de banda WAN o desplegar puntos de acceso adicionales. Aunque ambas medidas tienen su utilidad, ninguna de ellas soluciona la carga fantasma. Aumentar el ancho de banda simplemente ofrece más capacidad para que la consuma el tráfico en segundo plano. La inspección profunda de paquetes (DPI), la otra herramienta tradicional, resulta cada vez más ineficaz: la adopción generalizada de TLS 1.3 y del cifrado de extremo a extremo implica que la mayoría de los paquetes de tráfico son opacos para los motores de inspección. No se puede limitar lo que no se puede clasificar.
Para profundizar en cómo interactúan las frecuencias inalámbricas con los despliegues de alta densidad, consulte nuestra guía sobre Wi-Fi Frequencies: A Guide to Wi-Fi Frequencies in 2026.
Filtrado DNS: La contramedida eficiente
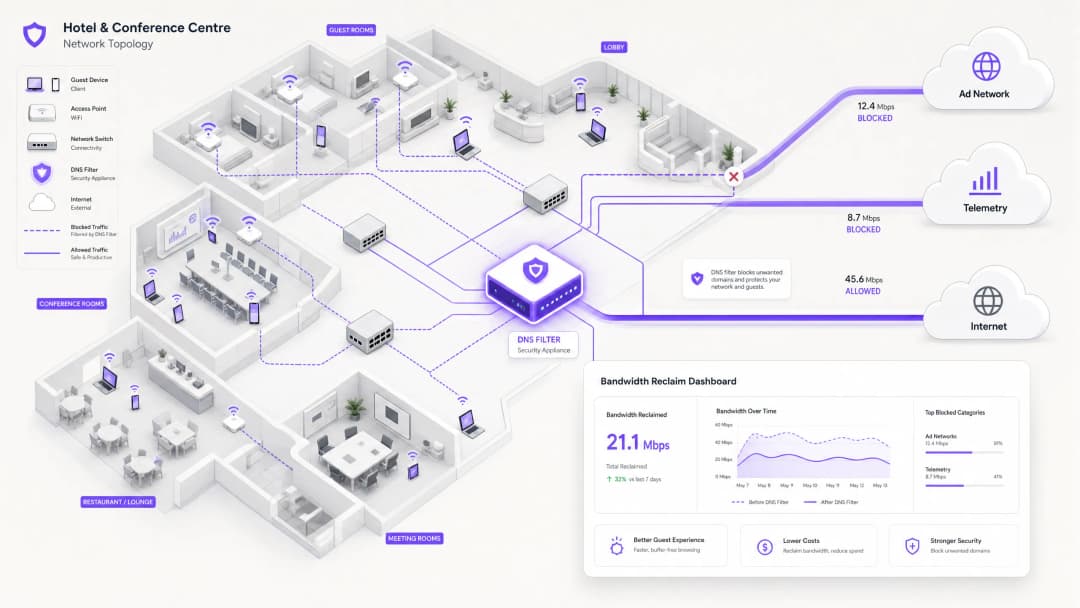
La solución moderna y escalable es el filtrado DNS en el extremo de la red. En lugar de inspeccionar el contenido del tráfico, el filtrado DNS opera en la capa de resolución, evitando que las conexiones se establezcan en primer lugar.
Cuando un dispositivo solicita acceso a una red publicitaria o dominio de telemetría conocidos, el analizador DNS comprueba la solicitud frente a una Zona de Política de Respuesta (RPZ). Si el dominio aparece en la lista de bloqueo, el analizador devuelve una respuesta NXDOMAIN (dominio inexistente) o desvía el tráfico a una dirección IP nula local. La conexión se interrumpe antes de que se produzca el saludo de tres vías TCP, preservando tanto el tiempo de transmisión inalámbrica como el ancho de banda WAN. Este enfoque es computacionalmente económico, escala de forma lineal con la capacidad del analizador y no se ve afectado por el cifrado del contenido.

La dimensión de la seguridad
El filtrado DNS ofrece un beneficio secundario significativo: la seguridad. Al bloquear dominios de Comando y Control (C2) de malware conocidos, infraestructuras de phishing y redes de distribución de kits de explotación en la capa DNS, la red de invitados se vuelve sustancialmente más defendible. Esto es directamente relevante para las obligaciones de cumplimiento bajo marcos como PCI-DSS (que exige la segmentación de red y la monitorización de entornos de datos de titulares de tarjetas) y el GDPR (que obliga a aplicar medidas técnicas adecuadas para proteger los datos personales). Para un análisis detallado de los requisitos de registro de auditoría en este contexto, consulte Explain what is audit trail for IT Security in 2026.
Para las organizaciones que gestionan entornos educativos donde el bloqueo de anuncios también cumple una función de protección, los principios descritos en Minimising Student Distractions with Network-Level Ad Blocking son directamente aplicables.
¿Tiene preguntas sobre su configuración específica?
Nuestro equipo trabaja con operadores de recintos, responsables de TI e ingenieros de redes en 80 000 espacios. Reserve una llamada de 20 minutos y le mostraremos cómo lo han solucionado otros profesionales como usted.
Guía de implementación
La implantación de una arquitectura de filtrado DNS sólida requiere una planificación minuciosa para evitar la interrupción de los servicios legítimos de los invitados. La implementación debe seguir un enfoque por fases.
Fase 1: Evaluación de referencia y visibilidad
Antes de aplicar cualquier bloqueo, establezca una línea de base de los patrones de tráfico actuales. Utilice la analítica de WiFi para identificar los dominios y categorías que más ancho de banda consumen durante un periodo representativo de 7 a 14 días. Esta fase de auditoría es fundamental para comprender el perfil de tráfico específico de su establecimiento y para justificar la inversión. Las métricas clave que deben registrarse incluyen:
| Métrica | Línea de base objetivo | Notas |
|---|---|---|
| Los 20 dominios DNS principales por volumen de consultas | Lista completa | Identificar dominios de telemetría y publicidad |
| Utilización de WAN por categoría | % de distribución | Cuantificar la carga fantasma |
| Recuento máximo de dispositivos concurrentes | Número | Dimensionar la infraestructura del analizador |
| Tasa de fallos en consultas DNS | < 0.1% | Establecer punto de referencia previo al despliegue |
Fase 2: Despliegue escalonado de RPZ
Comience desplegando la RPZ en modo de solo registro. Esto le permite verificar la precisión de sus listas de bloqueo sin afectar la experiencia del usuario. Concéntrese primero en las categorías de alta confianza:
- Dominios conocidos de malware y C2: Beneficio de seguridad inmediato con un riesgo casi nulo de falsos positivos. Utilice feeds de inteligencia de amenazas de proveedores de reputación.
- Redes de anuncios programáticos de gran ancho de banda: Diríjase a las principales plataformas de intercambio de anuncios de vídeo. Están bien documentadas y es poco probable que alberguen contenido legítimo.
- Endpoints de telemetría agresivos: Bloquee los dominios de seguimiento no esenciales. Mantenga una lista de permitidos cuidadosa para los dominios requeridos para los flujos de autenticación de Captive Portal.
Una vez que el modo de solo registro confirme tasas de falsos positivos aceptables (objetivo < 0.5% de las consultas), pase al modo de aplicación de políticas.
Fase 3: Modelado de tráfico e integración de QoS
Para el tráfico que no se puede bloquear por completo (por ejemplo, actualizaciones de SO de Apple, Microsoft y Google), implemente políticas de Quality of Service (QoS). Limite la velocidad de los servidores de actualización a un límite definido (normalmente entre el 10% y el 15% de la capacidad total de la WAN), garantizando que el tráfico interactivo de los invitados (navegación web, VoIP, videoconferencias) reciba cola de prioridad. Esto es especialmente importante para entornos de Sanidad donde el personal clínico puede compartir un segmento de red con los invitados.
Para obtener orientación sobre la optimización de entornos de red más amplios, incluidos los despliegues de oficinas y de uso mixto, consulte WiFi para oficinas: optimice la red WiFi de su oficina moderna.
Buenas prácticas
Mantenga listas de permitidos explícitas para servicios críticos. Asegúrese de que los dominios esenciales para la autenticación de Captive Portal, las pasarelas de pago (cumplimiento de PCI-DSS) y las operaciones principales del establecimiento estén explícitamente permitidos. Una lista de bloqueo mal configurada que interrumpa el flujo de inicio de sesión generará una carga de soporte inmediata y significativa.
Comunique la política de forma transparente. Sus Términos de servicio deben indicar que el tráfico de red se gestiona para garantizar una experiencia de alta calidad para todos los usuarios. Esto es tanto una buena práctica legal según el GDPR como una medida razonable para establecer las expectativas de los invitados.
Automatice las actualizaciones de las listas de bloqueo. El panorama de las redes de anuncios y los dominios de telemetría cambia constantemente. Los feeds de inteligencia de amenazas y las listas de RPZ deben actualizarse dinámicamente (idealmente en un ciclo de menos de 24 horas) para seguir siendo eficaces.
Aborde la evasión de DNS de forma proactiva. Implemente reglas de firewall para interceptar y redirigir todo el tráfico saliente del puerto 53 (UDP y TCP) al resolver local. Esto evita que los clientes eludan el filtrado configurando servidores DNS externos de forma fija.
Planifique para DNS sobre HTTPS (DoH). A medida que aumenta la adopción de DoH, los clientes pueden dirigir las consultas DNS a través de HTTPS para eludir por completo los resolvers locales. Evalúe si debe bloquear los proveedores de DoH conocidos (por ejemplo, dns.google, cloudflare-dns.com) o desplegar un proxy DoH transparente que aplique la política local.
Alineación con IEEE 802.1X y WPA3. Asegúrese de que su arquitectura de filtrado DNS sea compatible con su marco de autenticación. En entornos que utilizan IEEE 802.1X con autenticación basada en RADIUS, las políticas de filtrado DNS se pueden aplicar por VLAN o por grupo de usuarios, lo que permite un control granular.
Resolución de problemas y mitigación de riesgos
Modos de fallo comunes
| Modo de fallo | Síntoma | Mitigación |
|---|---|---|
| Bloqueo excesivo (colisión de CDN) | Páginas web rotas, imágenes ausentes | Listas de bloqueo granulares; proceso rápido de inclusión en la lista de permitidos |
| Evasión de DNS (resolutores codificados) | Filtrado eludido por aplicaciones específicas | Reglas de redirección de cortafuegos para el puerto 53 |
| Elusión de DoH | Filtrado eludido por navegadores modernos | Bloquear proveedores de DoH conocidos o desplegar un proxy DoH |
| Cuello de botella en el rendimiento del resolutor | Mayor latencia de DNS en todos los clientes | Escalar la infraestructura del resolutor; implementar anycast |
| Fallo de Captive Portal | Los invitados no pueden autenticarse | Lista de permitidos explícita para dominios del portal y endpoints de detección de SO |
| Listas de bloqueo obsoletas | Nuevos dominios de anuncios no bloqueados | Automatizar las actualizaciones de feeds; supervisar los registros de consultas para detectar nuevos dominios de gran volumen |
Respuesta a incidentes de seguridad
Si se detecta que un dispositivo de invitado se está comunicando con un dominio C2 de malware conocido (visible en los registros de consultas DNS), la RPZ bloqueará automáticamente cualquier otra comunicación. Asegúrese de que su proceso de respuesta a incidentes incluya un flujo de trabajo para revisar estos eventos, ya que pueden indicar un dispositivo comprometido que requiere aislamiento de la VLAN de invitados.
ROI e impacto empresarial
La implementación del filtrado DNS a nivel de red ofrece resultados empresariales medibles y cuantificables en múltiples dimensiones.
Recuperación de ancho de banda y aplazamiento de CapEx. Los recintos suelen recuperar entre el 20 y el 40 % de su ancho de banda WAN total. Esto se traduce directamente en un ahorro de costes al aplazar la necesidad de costosas actualizaciones de circuitos. Para un recinto que actualmente paga por una línea alquilada de 500 Mbps, recuperar el 30 % de la capacidad equivale a ganar 150 Mbps de rendimiento efectivo con un coste adicional de cero.
Mejora de la satisfacción de los invitados y del NPS. Al eliminar la congestión de fondo, la velocidad percibida y la fiabilidad de la red WiFi de invitados mejoran drásticamente. La reducción de la latencia y un rendimiento constante se traducen en puntuaciones netas de promotores más altas y menos escaladas de soporte operativo.
Mejora de la seguridad y el cumplimiento normativo. El bloqueo de dominios de malware y phishing en la capa DNS reduce significativamente el riesgo de que se produzca una brecha de seguridad originada en la red de invitados. Esto respalda directamente el cumplimiento de los requisitos de segmentación de red de PCI-DSS y la obligación de GDPR de implementar las medidas de seguridad técnicas adecuadas.
Eficiencia operativa. El filtrado DNS automatizado reduce la carga de trabajo manual de los equipos de operaciones de red. En lugar de responder de forma reactiva a los eventos de congestión, la red gestiona proactivamente su propio perfil de tráfico.
| Resultado | Rango típico | Método de medición |
|---|---|---|
| Ancho de banda recuperado | 20–40 % de la capacidad WAN | Supervisión de la utilización de la WAN antes y después |
| Tasa de bloqueo de consultas DNS | 15–35 % de todas las consultas | Registros de consultas del sistema de resolución |
| Mejora de la satisfacción de los invitados | +8–15 puntos NPS | Encuestas posteriores a la estancia o visita |
| Aplazamiento de CapEx | 1–3 años en la actualización del circuito | Modelado de costes |
| Reducción de incidentes de seguridad | 40–60 % menos de detecciones C2 | Correlación SIEM |
Al tratar la red no solo como un canal, sino como una puerta de enlace inteligente y filtrada, los líderes de TI pueden ofrecer una experiencia de conectividad superior, segura y rentable, que se escala con el crecimiento del establecimiento sin una inversión proporcional en infraestructura.
Definiciones clave
Zona de política de respuesta (RPZ)
Mecanismo en los servidores DNS que permite modificar las respuestas DNS en función de una política definida. Cuando un dominio consultado coincide con una entrada en la RPZ, el resolutor puede devolver una respuesta sintética (por ejemplo, NXDOMAIN o una IP de sumidero) en lugar de la respuesta real.
El principal mecanismo técnico para implementar el filtrado de DNS en toda la red. Los equipos de TI configuran las RPZ en sus resolutores internos para bloquear redes de anuncios, dominios de malware y endpoints de telemetría sin necesidad de software en el lado del cliente.
Inspección profunda de paquetes (DPI)
Forma de filtrado de paquetes de red que examina el contenido de datos de un paquete a medida que pasa por un punto de inspección, buscando el incumplimiento de protocolos, contenido específico o criterios definidos.
Utilizado tradicionalmente para la clasificación y el modelado de tráfico. Cada vez más limitado por la adopción generalizada del cifrado de extremo a extremo TLS 1.3, que vuelve opacos los datos útiles. El filtrado de DNS es la alternativa preferida para entornos de tráfico cifrado.
NXDOMAIN
Código de respuesta DNS (RCODE 3) que indica que el nombre de dominio consultado no existe en el espacio de nombres DNS.
Devuelto por un resolutor de filtrado DNS para bloquear intencionadamente una conexión a un dominio no deseado. La aplicación del cliente recibe esta respuesta y abandona el intento de conexión, evitando que se consuma ancho de banda.
DNS sobre HTTPS (DoH)
Protocolo para realizar la resolución DNS a través del protocolo HTTPS (RFC 8484), cifrando las consultas y respuestas DNS entre el cliente y un resolutor compatible con DoH.
Puede eludir el filtrado de DNS de la red local si los clientes están configurados para utilizar proveedores de DoH externos. Los administradores de red deben implementar reglas de firewall o redirigir el tráfico DoH mediante proxy para aplicar las políticas de RPZ locales.
Calidad de Servicio (QoS)
Conjunto de mecanismos de red que controlan la priorización del tráfico, la limitación de velocidad y la gestión de colas para garantizar el rendimiento de las aplicaciones críticas.
Se utiliza junto con el filtrado de DNS para gestionar el tráfico legítimo pero de gran ancho de banda (por ejemplo, actualizaciones del sistema operativo) que no se puede bloquear. QoS garantiza que el tráfico interactivo de los invitados tenga prioridad sobre las transferencias masivas en segundo plano.
Telemetría
Recopilación y transmisión automatizada de datos operativos desde los dispositivos a servidores remotos para su monitorización, análisis y diagnóstico.
En el contexto de WiFi para invitados, la telemetría de dispositivos de los sistemas operativos y aplicaciones móviles puede consumir silenciosamente entre el 15 y el 20 % del ancho de banda disponible. Es un objetivo primordial para el filtrado de DNS en despliegues de redes públicas.
Sumidero DNS (DNS Sinkholing)
Técnica en la que un servidor DNS está configurado para devolver una dirección IP falsa (normalmente una dirección nula local) para dominios específicos, redirigiendo el tráfico fuera de su destino previsto.
Se utiliza para neutralizar el tráfico C2 de malware y bloquear de forma agresiva las redes de anuncios que consumen mucho ancho de banda. Es más definitivo que las respuestas NXDOMAIN, ya que permite al servidor del sumidero registrar los intentos de conexión para el análisis de seguridad.
Equidad de tiempo de aire (Airtime Fairness)
Función de red inalámbrica que asigna un acceso equitativo al medio inalámbrico a todos los clientes conectados, independientemente de sus velocidades de datos individuales.
Crítico en entornos de alta densidad. Sin equidad de tiempo de aire, un único dispositivo lento (por ejemplo, un cliente antiguo 802.11g) puede consumir de forma desproporcionada el tiempo de aire, degradando el rendimiento para todos los demás clientes. El tráfico de telemetría de fondo de muchos dispositivos agrava este efecto.
Carga fantasma (Phantom Load)
Ancho de banda consumido por procesos en segundo plano automatizados en dispositivos conectados antes de que ocurra cualquier actividad deliberada del usuario.
Término colectivo para la telemetría, la precarga de redes de anuncios y el tráfico de actualizaciones de sistemas operativos. Comprender y cuantificar la carga fantasma es el primer paso en cualquier diagnóstico de congestión de WiFi para invitados.
Ejemplos prácticos
Un hotel resort de 400 habitaciones experimenta una grave congestión de red todas las noches entre las 19:00 y las 22:00 horas. El enlace WAN de 1 Gbps está saturado y los huéspedes se quejan de una transmisión lenta y de llamadas VoIP caídas. El Director de TI debe identificar la causa raíz e implementar una solución sin actualizar el circuito.
Paso 1 - Análisis de tráfico: Implemente un analizador de flujo de red (NetFlow/IPFIX) en el router principal y ejecútelo durante 5 días en periodos de hora punta y de menor actividad. Correlacione los resultados con los registros de consultas DNS del sistema de resolución existente. El análisis revela que el 35% del tráfico nocturno se dirige a redes conocidas de anuncios de vídeo programáticos (DoubleClick, AppNexus) y a servidores de actualización automática de aplicaciones (Apple Software Update, Google Play). El uso legítimo del navegador por parte de los huéspedes representa solo el 52% del tráfico total.
Paso 2 - Despliegue de filtrado DNS: Configure el firewall principal para redirigir todas las consultas DNS de la VLAN de invitados (puerto UDP/TCP 53) a un sistema de resolución local compatible con RPZ. Importe una lista de bloqueo seleccionada que cubra las redes de anuncios y los dominios de telemetría identificados. Ejecute en modo de solo registro durante 48 horas para validar las tasas de falsos positivos.
Paso 3 - Aplicación de políticas: Tras validar una tasa de falsos positivos inferior al 0,3%, cambie al modo de aplicación. Simultáneamente, implemente una política de QoS que limite la velocidad de los servidores de actualización de Apple y Google a un máximo combinado de 80 Mbps durante la franja horaria de 18:00 a 23:00.
Paso 4 - Validación: Supervise la utilización de la WAN durante los siguientes 7 días. La utilización máxima cae del 98% al 61%, resolviendo las quejas de los huéspedes. El hotel aplaza una actualización planificada del circuito durante un tiempo estimado de 18 meses.
Un gran centro de conferencias acoge una cumbre tecnológica con 5.000 asistentes. Durante la ponencia principal, la red WiFi queda completamente inutilizable. El análisis posterior al incidente muestra que miles de dispositivos intentaron descargar simultáneamente una actualización importante de iOS que se había lanzado esa misma mañana.
Mitigación inmediata (día del evento): El equipo de operaciones de red identifica el pico mediante la monitorización de consultas DNS en tiempo real. Inmediatamente desvían a un agujero negro (sinkhole) los dominios específicos de actualización de software de Apple (mesu.apple.com, appldnld.apple.com, updates.cdn-apple.com) en la capa de DNS. En 4 minutos, la utilización de la WAN cae del 99% al 68% y la red se estabiliza.
Solución a corto plazo (mismo evento): Se aplica una política de QoS para limitar la velocidad de todo el tráfico de actualización restante a 50 Mbps durante la duración del evento.
Estrategia a largo plazo (post-evento): El equipo de red implementa una política dinámica de QoS que se activa automáticamente cuando la utilización total de la WAN supera el 75%, limitando los servidores de actualización conocidos al 10% de la capacidad total. Se crea una lista de comprobación previa al evento que incluye desvíos temporales a agujeros negros de los principales dominios de actualización durante las 2 horas anteriores y posteriores a las sesiones de gran afluencia. El equipo también se suscribe a los canales de notificación de lanzamientos de actualizaciones de Apple y Microsoft para anticiparse a futuros picos de demanda.
Preguntas de práctica
Q1. Usted es el director de TI de una cadena minorista nacional. Después de implementar una solución de filtrado DNS en 50 tiendas, varios gerentes de tienda informan que la página de inicio de sesión del Captive Portal no se carga para los invitados. El equipo de soporte está recibiendo un gran volumen de llamadas. ¿Cuál es la causa más probable y cuál es el paso de remediación inmediato?
Sugerencia: Considere la cadena de dependencia completa de un flujo de autenticación de Captive Portal moderno, incluidos los mecanismos de detección de Captive Portal a nivel de SO.
Ver respuesta modelo
La causa más probable es un bloqueo excesivo. El filtro DNS está bloqueando un dominio necesario para que funcione el Captive Portal. Los sistemas operativos móviles modernos utilizan dominios específicos para detectar los Captive Portals (por ejemplo, captive.apple.com para iOS, connectivitycheck.gstatic.com para Android). Si estos están bloqueados, el SO no activará el navegador del Captive Portal y el invitado no verá ninguna pantalla de inicio de sesión. Además, el propio portal puede depender de una CDN o de un proveedor de autenticación de terceros (por ejemplo, inicio de sesión social a través de Facebook o Google) cuyos dominios están bloqueados inadvertidamente.
Remediación inmediata: Revise los registros de consultas DNS para detectar respuestas NXDOMAIN que se originen en la subred de invitados durante la fase de autenticación. Identifique todos los dominios bloqueados que se consultan antes de un inicio de sesión correcto. Agregue estos dominios a la lista de permitidos global. Implemente una plantilla de lista de permitidos estándar para implementaciones de Captive Portal que incluya todos los endpoints principales de detección de SO y los dominios de proveedores de autenticación comunes.
Q2. El arquitecto de red de un estadio nota que, a pesar de implementar un filtrado DNS estricto, la utilización de la WAN sigue siendo críticamente alta durante los partidos. Una investigación más profunda revela un volumen alto y sostenido de tráfico UDP por el puerto 443 que no se correlaciona con ningún dominio bloqueado en los registros de DNS. ¿Qué está sucediendo y cómo se debe abordar?
Sugerencia: Considere los protocolos de transporte modernos y cómo interactúan con los controles a nivel de DNS.
Ver respuesta modelo
El alto volumen de tráfico UDP 443 indica el uso de QUIC (HTTP/3). QUIC es un protocolo de transporte basado en UDP utilizado por las principales plataformas (Google, Meta, YouTube) que elude los proxies tradicionales basados en TCP y los motores DPI. Lo que es más crítico, los clientes que usan QUIC también pueden estar utilizando DNS sobre HTTPS (DoH) para resolver dominios, eludiendo por completo el solucionador RPZ local y haciendo que el filtrado DNS sea ineficaz para esos clientes.
Para abordar esto: Primero, implemente reglas de firewall para bloquear el tráfico DoH saliente hacia proveedores públicos de DoH conocidos (Google, Cloudflare, NextDNS) en el puerto TCP/UDP 443 por IP de destino, lo que obligará a los clientes a recurrir al solucionador local. Segundo, evalúe bloquear por completo el puerto UDP 443 saliente (o limitar su velocidad de forma estricta) para obligar a los clientes QUIC a recurrir a HTTP/2 basado en TCP, que está sujeto a las políticas de gestión de tráfico existentes. Tercero, analice si se puede implementar un proxy DoH transparente para interceptar e inspeccionar las consultas DoH mientras se aplican las políticas de RPZ locales.
Q3. Usted está diseñando una política de QoS para la red WiFi de invitados de un gran hospital público. La red se comparte entre dispositivos de entretenimiento de pacientes, dispositivos personales de visitantes y un pequeño número de personal clínico que utiliza softphones VoIP en sus móviles personales. Priorice los siguientes tipos de tráfico: VoIP (SIP/RTP), navegación web de invitados (HTTP/HTTPS), actualizaciones de Windows/iOS y transmisión de vídeo (Netflix/YouTube).
Sugerencia: Considere tanto la sensibilidad a la latencia como el impacto comercial y clínico de cada tipo de tráfico. Considere también el contexto regulatorio de un entorno sanitario.
Ver respuesta modelo
Prioridad 1 - VoIP (SIP/RTP): Cola de prioridad estricta (Expedited Forwarding, DSCP EF). VoIP es altamente sensible a la latencia (objetivo < 150 ms de ida) y al jitter (objetivo < 30 ms). Una pérdida de paquetes superior al 1 % causa una degradación audible. En un contexto clínico, una llamada caída podría tener implicaciones para la seguridad del paciente.
Prioridad 2 - Navegación web de invitados (HTTP/HTTPS): Assured Forwarding (AF31). Este es el principal caso de uso previsto tanto para pacientes como para visitantes. Requiere una capacidad de respuesta razonable, pero tolera una latencia moderada.
Prioridad 3 - Streaming de vídeo (Netflix/YouTube): Tasa limitada por cliente (por ejemplo, límite de 3 a 5 Mbps) con Assured Forwarding (AF21). Aunque es importante para la experiencia del paciente durante estancias largas, el streaming sin límites saturará el enlace. Un límite por cliente garantiza un acceso equitativo. Considere políticas según la hora del día para flexibilizar los límites durante las horas valle.
Prioridad 4 - Actualizaciones de SO/aplicaciones (Clase Scavenger, DSCP CS1): La prioridad más baja, cola de mejor esfuerzo (best-effort), con un límite de tasa agregado (por ejemplo, 50 Mbps en total para todo el tráfico de actualización). Se trata de tareas en segundo plano sin sensibilidad a la latencia. Solo deben consumir la capacidad sobrante. En un entorno sanitario, considere también si la red WiFi de invitados está completamente aislada de los sistemas clínicos; de lo contrario, la gestión del tráfico de actualizaciones se convierte en un problema de seguridad además de uno de ancho de banda.
Continúe leyendo esta serie
Guía paso a paso para diagnosticar problemas de roaming de WiFi
Esta guía completa proporciona a los líderes de TI de nivel empresarial y arquitectos de red una metodología autorizada y paso a paso para diagnosticar y resolver problemas de roaming de WiFi. Al combinar análisis técnicos profundos de los estándares IEEE 802.11k/v/r con casos de estudio reales y análisis a nivel de paquetes, esta referencia capacita a los equipos para eliminar el problema del "sticky client" y ofrecer una conectividad móvil fluida. Cubre todo el flujo de trabajo de diagnóstico, desde estudios de cobertura de RF y auditorías de configuración de controladoras hasta análisis de captura de paquetes por el aire (OTA) y validación posterior a la resolución.
Por qué el WiFi de su estadio se ralentiza (y cómo solucionarlo)
Esta guía técnica autorizada analiza la causa raíz de la congestión del WiFi en los estadios - el tráfico en segundo plano simultáneo de 50.000 dispositivos que cargan anuncios programáticos y telemetría - y proporciona un diseño arquitectónico detallado para implementar el filtrado DNS perimetral como principal estrategia de mitigación. Diseñado para directores de TI, CTO y arquitectos de redes, ofrece pautas de implementación prácticas, casos de estudio reales y marcos de ROI medibles para ayudar a los operadores de recintos a recuperar ancho de banda y ofrecer conectividad de alto rendimiento a escala.
Resolución del error "Conectado pero sin Internet" en redes WiFi de invitados
Esta guía de referencia técnica autorizada explica cómo los tiempos de espera de DNS causados por redes congestionadas provocan el error "Conectado, sin Internet" en la WiFi de invitados. Proporciona a arquitectos de redes y responsables de TI pasos de implementación prácticos para desplegar filtros DNS corporativos con el fin de resolver estos cuellos de botella y mejorar la incorporación de invitados.
¿Tiene preguntas sobre su configuración específica?
Nuestro equipo trabaja con operadores de recintos, responsables de TI e ingenieros de redes en 80 000 espacios. Reserve una llamada de 20 minutos y le mostraremos cómo lo han solucionado otros profesionales como usted.