Se une a un SSID de invitados, el portátil indica que está conectado, el teléfono no abre nada, Windows informa de conectividad limitada y se culpa al servicio de soporte técnico de un "portal roto". La mayoría de las veces, la página del portal no es el primer problema. El problema es la detección del Captive Portal.
Esa distinción importa más ahora que hace unos años. En las infraestructuras mixtas del Reino Unido, el flujo de trabajo de detección afecta a la experiencia del usuario, al comportamiento de seguridad del endpoint, al registro de datos y a si las herramientas de confianza cero se mantienen estables durante la incorporación. Si solo lo trata como "lo que hace saltar la página de bienvenida", no detectará los fallos que dejan a los usuarios sin conexión.
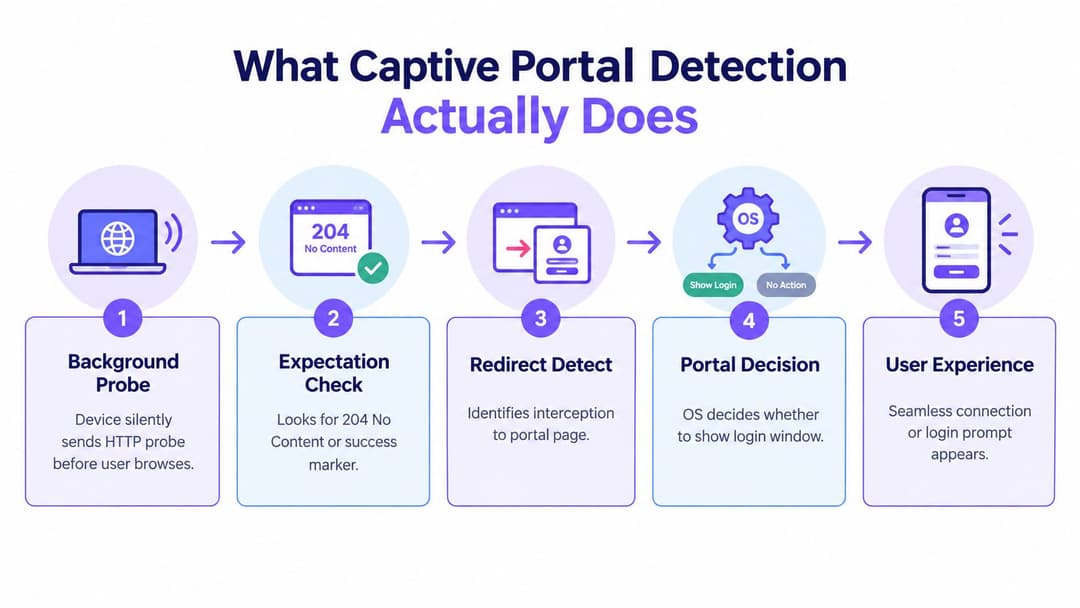
Qué hace realmente la detección de Captive Portal
Un Captive Portal no comienza con la página del portal. Comienza cuando el cliente decide si la red tiene acceso sin restricciones a Internet.
Cuando un dispositivo se une a la WiFi, el sistema operativo suele enviar una solicitud HTTP en segundo plano a un endpoint controlado por el fabricante. Si la respuesta coincide con lo que el cliente espera, el dispositivo asume que tiene acceso libre a Internet y no realiza ninguna otra acción. Si la respuesta se redirecciona, se modifica o se bloquea, el sistema operativo decide que probablemente existe un portal y abre un flujo de inicio de sesión.
La detección es la puerta de acceso, no el inicio de sesión
Esta es la parte que muchos equipos suelen confundir:
- La detección decide si el usuario debe ver un portal o no.
- La autenticación decide si se permite el paso a ese usuario.
- La autorización decide a qué puede acceder ese usuario después.
Si la detección falla, el portal puede estar perfectamente operativo y nadie llegará a verlo. Si la detección tiene éxito pero la autenticación falla, los usuarios verán la página y seguirán sin tener acceso. Se trata de fallos diferentes con soluciones distintas.
Un modelo mental útil es tratar la detección del Captive Portal como un veredicto de conectividad dirigido por el sistema operativo. El navegador no lidera el proceso. El sistema operativo lo hace.
Por qué es importante en redes reales
Esto no es un caso aislado. Un estudio sobre puntos de acceso reveló que 484 redes llegaron a la primera prueba de detección de Captive Portal, y 390 redes distintas utilizaban algún tipo de Captive Portal, lo que demuestra que la detección de portales ya estaba activa a escala de despliegue real y no solo en entornos de laboratorio (resumen del estudio).
Esa escala importa porque cada una de esas redes dependía de que los clientes interpretaran correctamente las respuestas de sondeo. En la práctica, esto significa que la experiencia de usuario depende de un intercambio muy pequeño: un código de estado, un cuerpo de respuesta o un redireccionamiento.
Regla práctica: Si los usuarios dicen "el portal no apareció", inspeccione la ruta de sondeo antes de inspeccionar la página del portal.
Por qué ha cambiado el problema
La resolución de problemas en puntos de acceso antiguos se centraba en conseguir que se cargara la página de bienvenida. Eso sigue siendo parte del trabajo, pero los entornos modernos tienen otra capa. Los agentes de seguridad, los clientes VPN y las herramientas de incorporación también reaccionan cuando detectan la presencia de un Captive Portal. Mozilla documenta que Firefox comprueba extremos dedicados del portal antes de abrir una página de inicio de sesión, mientras que Cloudflare señala que su cliente puede enviar múltiples solicitudes de portal específicas del sistema operativo y puede abrir completamente el cortafuegos del sistema hasta que se complete la incorporación, lo que convierte la detección en un problema de fiabilidad y seguridad del extremo, no solo en un problema de inicio de sesión (Mozilla captive portal support article).
Por eso, los equipos maduros ahora se hacen dos preguntas en lugar de una. Primero, ¿puede la red activar el portal de forma constante? Segundo, ¿debería esta infraestructura seguir dependiendo de ese flujo de trabajo como método de acceso principal?
Sondeos principales y heurística tras una detección fiable
Un cliente se conecta a la WiFi, obtiene DHCP, muestra una buena señal y, aun así, informa de "Sin Internet" o nunca abre la ventana de inicio de sesión. En casi todos los casos, el problema reside en la ruta de sondeo, no en la página del portal.
Qué comprueban realmente los clientes
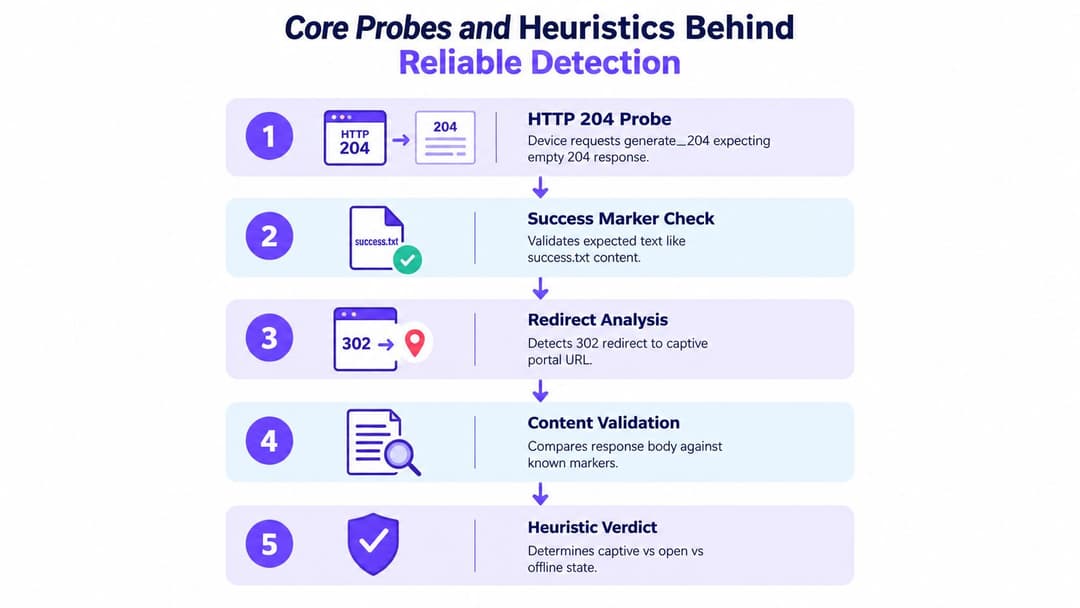
La detección de Captive Portal es un pequeño motor de decisión integrado en el sistema operativo o en el agente de cliente. El dispositivo envía una solicitud conocida a un endpoint conocido, compara la respuesta con el resultado esperado y luego decide si la red está en línea, cautiva o caída. Es posible que el usuario solo vea una ventana emergente del navegador, pero el proceso real ocurrió unos pocos paquetes antes.
Los objetivos de sondeo habituales incluyen captive.apple.com de Apple, connectivitycheck.gstatic.com y clients3.google.com/generate_204 de Google, msftconnecttest.com/connecttest.txt de Microsoft y detectportal.firefox.com de Firefox. El detonante no es solo el nombre de host. Es la combinación del código de estado, las cabeceras, el contenido del cuerpo, el comportamiento de redirección y el tiempo de respuesta, tal y como se indica en la descripción general del portal hotspot de DrayTek.
La lógica suele ser la siguiente:
- El cliente envía un sondeo
- La red lo permite o lo intercepta
- El cliente comprueba la respuesta con su patrón esperado
- El cliente clasifica el estado de la red
- El SO o el agente decide si inicia un flujo cautivo, advierte al usuario o no hace nada
Ese último paso importa más de lo que muchos equipos esperan. Los agentes de seguridad, los clientes VPN y las herramientas de incorporación a menudo se basan en el mismo veredicto. Una respuesta de sondeo incorrecta puede romper el acceso, retrasar las comprobaciones de postura o dejar el endpoint en un extraño estado de semiconexión.
Qué suele romper la detección con más frecuencia
Los modos de fallo más comunes son aburridos, repetibles y fáciles de pasar por alto durante una prueba rápida en el navegador.
- Estado HTTP incorrecto: las comprobaciones de la familia Android a menudo esperan un código
204 No Content. Devolver una página con marca propia200 OKpuede hacer que el cliente clasifique la red como cautiva, estropeada o inestable. - Contenido del cuerpo incorrecto: Windows y otras pilas de protocolos pueden buscar marcadores de texto plano exactos. Los banners de proxy, el HTML reescrito o las funciones de inyección de contenido pueden romper esa coincidencia.
- Errores de redirección: una redirección clara al portal está bien. Las redirecciones en cadena, los bucles o las redirecciones que alternan entre HTTP y HTTPS a menudo causan fallos silenciosos.
- Interferencia de DNS: el secuestro de DNS, el DNS de horizonte dividido o los resolvedores recursivos que responden de manera incoherente pueden enviar sondas a un lugar que el cliente no esperaba.
- Intercepción de TLS: el filtrado HTTPS y la sustitución de certificados provocan con frecuencia quejas de "conectado, sin internet" porque el cliente ya no confía en el resultado de la sonda.
- Problemas de tiempo y accesibilidad: un DNS ascendente lento, los CDN bloqueados para los recursos del portal o la falta de listas de permitidos para los proveedores de identidad pueden hacer que la detección oscile entre estados.
Una comprobación práctica para el despliegue es crear primero la lista de permitidos de preautenticación y probarla por separado. Herramientas como el generador de walled garden para dominios de Captive Portal y dependencias de Purple ayudan a detectar hosts de sondeo, recursos de portal, redirecciones de identidad y destinos de postautenticación que requieren un tratamiento diferente.
Un fallo ambiguo satura la cola de incidencias. Un fallo limpio es más fácil de diagnosticar.
Por qué las heurísticas son frágiles
Estas comprobaciones son frágiles porque se diseñaron para inferir el estado de la red a partir de un intercambio minúsculo, a menudo antes de que el dispositivo tenga acceso completo. Pequeños cambios en el filtrado de contenidos, la inspección SSL, los proxies inversos o la política de firewall pueden cambiar el resultado sin que nadie toque el portal en sí.
Esto lo veo con mayor frecuencia en SSIDs empresariales para invitados y de incorporación, donde múltiples equipos gestionan diferentes partes de la ruta. El equipo de redes inalámbricas ve que la asociación se realiza correctamente. El equipo del cortafuegos ve una política de redirección permitida. El equipo de seguridad ve que la inspección HTTPS funciona según lo previsto. El endpoint solo ve una respuesta de sondeo que ya no coincide con lo que había solicitado.
Por eso, la detección de Captive Portal debe tratarse como un control de fiabilidad y de seguridad del endpoint, no solo como una función de conveniencia que muestra una página de inicio de sesión. Si la detección no es fiable, los usuarios no consiguen incorporarse, los agentes de seguridad pueden interpretar erróneamente la accesibilidad y los equipos de soporte terminan solucionando problemas en la capa incorrecta.
También explica por qué algunas infraestructuras deberían dejar de depender de los flujos de trabajo cautivos como método de acceso principal. Para el acceso de invitados mediante BYOD, los visitantes de corta estancia y la incorporación de sistemas heredados, la detección de portales sigue teniendo su lugar. Para los usuarios gestionados en grandes infraestructuras empresariales del Reino Unido, Passpoint o OpenRoaming suelen ofrecer un mejor resultado porque las decisiones de acceso pasan de las frágiles heurísticas HTTP a un acceso de red autenticado desde el principio.
Cómo es un resultado correcto
Un despliegue sólido presenta unas cuantas características constantes:
- El manejo de sondas es deliberado: cada familia importante de clientes recibe el patrón de respuesta que espera en el estado previo a la autenticación.
- Las rutas de preautenticación están estrictamente delimitadas: solo son accesibles los dominios de sonda requeridos, los componentes del portal, los extremos de identidad y las rutas de actualización.
- Los controles de seguridad conocen el tráfico de sondas: los proxies, los filtros y las políticas de inspección de TLS no reescriben ni interceptan estas comprobaciones por accidente.
- Los cambios de estado son rápidos después de la autenticación: una vez que se permite el acceso al usuario, el cliente puede volver a comprobar la conectividad y borrar el veredicto de cautivo sin tener que apagar y encender el WiFi.
- Los equipos de operaciones pueden realizar pruebas a nivel de paquete: pueden predecir el resultado del cliente a partir de trazas de DNS, HTTP y redirecciones, no a partir de una captura de pantalla del navegador.
Si el equipo puede explicar por qué un dispositivo marcó la red como cautiva, abierta o rota basándose únicamente en el intercambio sin procesar, el diseño de detección suele estar en buena forma.
Cómo gestionan la detección los diferentes sistemas operativos principales
El lunes por la mañana, el SSID de invitados parece correcto. Los clientes se asocian, obtienen DHCP y muestran buena señal. De repente, las incidencias se dividen por tipo de dispositivo. Los iPhones se conectan pero nunca muestran la pantalla de inicio de sesión, los teléfonos Android declaran de inmediato que es necesario iniciar sesión y los portátiles con Windows se quedan en "Sin Internet" el tiempo suficiente para que los usuarios culpen a la WiFi. Es por eso que la detección de portales debe estar en el manual de fiabilidad, no solo en el diseño del acceso de invitados.
Las diferencias son pequeñas sobre el papel y caras en producción. Cada plataforma prueba la conectividad a su manera, y cada una reacciona de forma adversa a modos de fallo ligeramente distintos. En entornos mixtos, esas particularidades también se solapan con controles de endpoint como el filtrado web, la inspección TLS, los agentes VPN y las comprobaciones específicas del navegador. Un portal que solo "funciona en un navegador" no está funcionando correctamente.
Comparativa de las expectativas de los sondeos de SO
| Familia de cliente | Extremo de prueba | Señal de éxito esperada |
|---|---|---|
| Apple | captive.apple.com |
Respuesta HTTP que contiene la página de éxito esperada |
| Pila de Android y Google | connectivitycheck.gstatic.com o clients3.google.com/generate_204 |
204 No Content |
| Windows | msftconnecttest.com/connecttest.txt |
Texto plano esperado de Microsoft Connect Test |
| Firefox | detectportal.firefox.com |
Respuesta de detección de portal esperada utilizada por Firefox |
Apple suele fallar de forma silenciosa
Apple suele ofrecer la experiencia de usuario más limpia cuando la ruta de preautenticación se configura correctamente. Cuando es incorrecta, el fallo puede ser casi silencioso. El dispositivo se une al SSID, obtiene una dirección y se muestra normal en el controlador, pero el asistente cautivo nunca se abre.
En la práctica, esto apunta a dos causas comunes. La primera es una intercepción de sondeo que no coincide con lo que Apple considera cautivo. La segunda es la modificación de contenido por parte de un control de seguridad ascendente. Una página de bloqueo, la inyección de cabeceras o una política de gestión SSL pueden alterar la respuesta lo suficiente como para que el dispositivo ya no confíe en el resultado. Los equipos de soporte acaban entonces analizando la RF o el DHCP cuando el problema real es la integridad HTTP.
Android es más fácil de probar y menos permisivo
El modelo 204 No Content de Android es directo. Esto ayuda durante el diagnóstico porque el comportamiento esperado está claro, pero también significa que los pequeños errores se hacen evidentes rápidamente. Si devuelve una redirección, un cuerpo HTML o una respuesta filtrada donde Android no esperaba nada, el cliente puede marcar la red como captive o limitada.
Esa rigidez es útil. Si Android se muestra inestable en el mismo SSID donde Apple parece funcionar bien, empiece por analizar el comportamiento del proxy, el filtrado de contenido y la lógica de redirección antes de examinar la capa inalámbrica.
Windows expone problemas de sincronización y de directivas
Windows tiende a mostrar la ambigüedad de forma más abierta que Apple. Los usuarios experimentan una conectividad limitada, largos retrasos antes de que aparezca el portal o una conexión que parece establecida pero que falla en el tráfico de las aplicaciones de formas extrañas. En infraestructuras empresariales, esto suele interferir con las herramientas de seguridad. Los clientes VPN siempre activos, los módulos de protección web y los cortafuegos de host pueden influir en las mismas comprobaciones que utiliza Windows para determinar el estado de la conectividad.
Microsoft documenta el comportamiento y los endpoints actuales de NCSI en su propia guía, que es el punto de referencia adecuado para los clientes Windows actuales. La lección operativa es más sencilla: si el NCSI se intercepta, se filtra o se responde con demasiada lentitud, los usuarios lo notarán antes de comprenderlo.
Firefox puede diferir del SO del host
Firefox merece una atención especial en los ordenadores de sobremesa porque ejecuta su propia lógica de portal. El ordenador portátil puede mostrar una conectividad normal mientras que Firefox sigue comportándose como si el acceso estuviera restringido, o viceversa. Esto no es solo una excentricidad del navegador. Genera un ruido de soporte real porque el sistema operativo, el navegador y el agente del endpoint pueden tener opiniones diferentes sobre el estado de la misma red.
Nota de campo: Cuando los usuarios informen de que "el WiFi está conectado pero Firefox está bloqueado", compruebe el resultado del sondeo del sistema operativo, el resultado del sondeo del navegador y cualquier agente de pasarela web segura en el endpoint. Una suposición incorrecta en esta fase puede enviar la incidencia al equipo equivocado.
Los entornos mixtos necesitan un triaje que tenga en cuenta los dispositivos
Utilice el síntoma para elegir la primera prueba.
- El iPhone se conecta pero no aparece la pantalla de inicio de sesión: compruebe la gestión de pruebas de Apple y confirme que el cuerpo devuelto está intacto.
- Android informa de inmediato que se requiere inicio de sesión: confirme si el redireccionamiento es deliberado y si algún dispositivo recibe contenido en lugar de un código
204. - Windows indica que no hay Internet y el portal aparece tarde: inspeccione la accesibilidad de NCSI, el tiempo de redireccionamiento, la respuesta DNS y los agentes de seguridad locales.
- Firefox se comporta de forma diferente a Chrome en el mismo portátil: separe la detección a nivel de navegador del estado de conectividad del sistema operativo y del filtrado de extremos.
Aquí es también donde influye la decisión de diseño. Para el acceso de invitados, visitantes y BYOD, sigue valiendo la pena esforzarse por mantener una detección del portal en buen estado porque el flujo de trabajo es el esperado y la mezcla de clientes es impredecible. Para los usuarios gestionados en grandes empresas del Reino Unido, los casos extremos repetidos en el portal suelen ser una señal para reducir la dependencia de la lógica del Captive Portal y avanzar hacia Passpoint o OpenRoaming, donde el control de acceso se realiza al entrar en la red en lugar de mediante frágiles pruebas HTTP tras la asociación.
Pruebas de detección prácticas con curl, Python y agentes de dispositivo
La forma más rápida de dejar de adivinar es probar la ruta de sondeo directamente. No necesita capturas de paquetes para cada caso. Comience con comprobaciones HTTP repetibles y luego confirme el comportamiento en puntos de conexión reales.
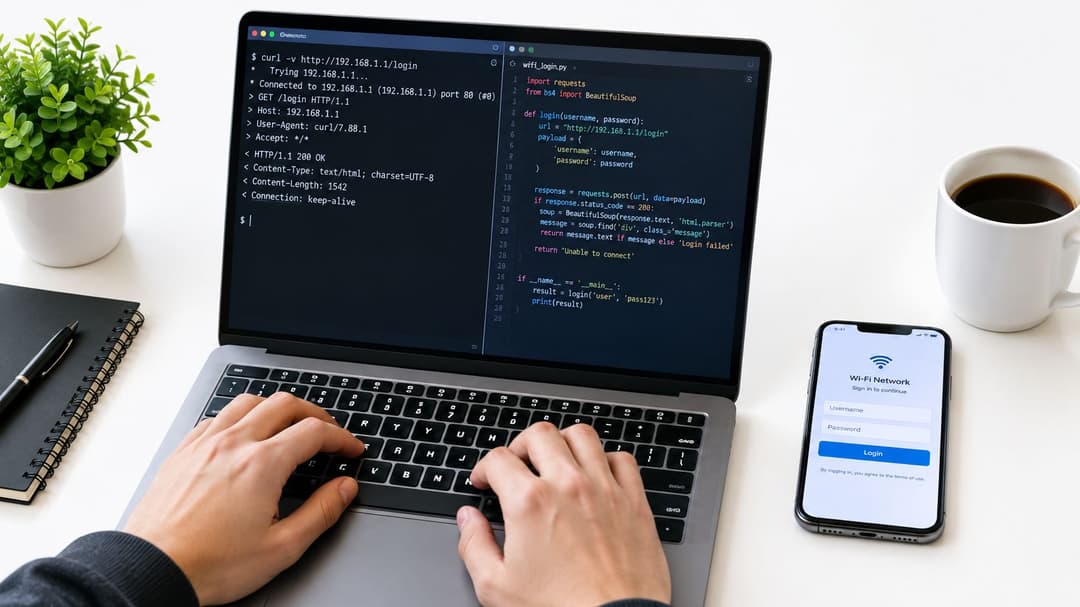
Empiece con curl
Use curl para inspeccionar los códigos de estado, las cabeceras y las redirecciones desde el mismo segmento de red que el cliente.
Para un sondeo al estilo de Google:
- Comprobar solo el estado: solicitar el endpoint
generate_204y confirmar si el resultado es204o una redirección. - Seguir las redirecciones con cuidado: ejecutar la misma solicitud con el seguimiento de redirecciones activado y ver si llega una vez al portal o si entra en bucle.
- Inspeccionar las cabeceras: si los dispositivos de filtrado de contenido añaden banners, cabeceras de categoría o contenido reescrito, la detección puede fallar incluso cuando el portal está activo.
Para sondeos de texto al estilo de Windows:
- Obtener el cuerpo exactamente como se devuelve
- Comparar el resultado del texto plano
- Buscar sustituciones o páginas de contenedor
Para comprobaciones al estilo de Apple:
- Solicitar la página de éxito esperada
- Confirmar que el cuerpo es el que el cliente espera cuando la red está abierta
- Confirmar que la interceptación es deliberada cuando el cliente no está autenticado
Un rápido control de cordura con un verificador de cabeceras HTTP ayuda cuando los proxies o las capas de seguridad están cambiando las respuestas.
Utilice un pequeño verificador en Python
Un script corto es suficiente para automatizar las comprobaciones que su servicio de soporte técnico repite durante toda la semana. Manténgalo simple:
- Definir las URL de sondeo para las familias de clientes con las que sea compatible.
- Enviar solicitudes HTTP sin comportamiento de navegador.
- Registrar el estado, la URL final, el recuento de redirecciones y el fragmento del cuerpo de la respuesta.
- Comparar los resultados con los valores esperados de una red abierta.
- Marcar resultados ambiguos como
200con contenido inesperado o redirecciones repetidas.
Ese script no necesita iniciar la sesión de los usuarios. Su trabajo es responder a una pregunta. ¿Presentó la red el sondeo de una manera que provocara la decisión esperada del cliente?
Los agentes de dispositivo necesitan moderación
Las pruebas en dispositivos gestionados son el punto donde los equipos pueden provocar daños colaterales. Si envías pruebas programadas agresivas a ordenadores portátiles que ya ejecutan clientes VPN, protección DNS o agentes de confianza cero, puedes desencadenar el mismo estado de incorporación que estás intentando evitar.
Utilice agentes ligeros con medidas de seguridad:
- Ejecutar sondeos en eventos de asociación, no de forma continua.
- Evitar cambios amplios en el cortafuegos en el lado del endpoint.
- Separar las pruebas de incorporación de invitados de la aplicación de la VPN de producción siempre que sea posible.
- Registrar los veredictos localmente primero y luego exportar los resúmenes.
Consejo operativo: Realice las pruebas como un cliente, no como un atacante. El objetivo es confirmar las decisiones del sistema operativo, no forzar por fuerza bruta cada ruta de redireccionamiento.
Qué buscar en los resultados
Las buenas pruebas aportan más información que un simple "activo" o "inactivo".
- Respuesta abierta correcta: el sondeo devuelve el código o marcador esperado.
- Respuesta cautiva esperada: el cliente no autenticado recibe una redirección al portal una sola vez.
- Bucle (Looping): la misma solicitud rebota repetidamente.
- Resultado filtrado: la respuesta existe pero el contenido se ha modificado.
- Ruta muerta (Dead path): tiempo de espera agotado o endpoint inaccesible.
Si puede obtener esos resultados desde un ordenador portátil en la VLAN de invitados y desde un punto de conexión corporativo gestionado, normalmente encontrará dónde está el problema antes de que la primera captura de pantalla de un usuario llegue a su bandeja de entrada.
Integración de la detección con plataformas de identidad y WiFi empresarial
En el WiFi empresarial, la detección de Captive Portal no debería ser el centro del diseño. Debería ser una capa de compatibilidad controlada.
Ese es el cambio en el que todavía están trabajando muchas empresas. El acceso de invitados, la incorporación de contratistas y el WiFi de cara al público pueden seguir necesitando la lógica del portal. El acceso del personal y de usuarios conocidos no debería depender de ella si se puede evitar.
Coloque la gestión de sondeos en el lugar adecuado
Tanto si utilizas Meraki, Aruba, Ruckus, Juniper Mist o UniFi, se aplica la misma regla de diseño. Gestiona los sondeos no autenticados de forma predecible en el controlador, la pasarela o el extremo de la nube donde ya resida tu política de invitados.
Eso significa:
- Permitir las rutas de preautenticación correctas: endpoints de sondeo, recursos de portal y cualquier redirección de identidad que deba cargarse antes del acceso completo.
- Mantener la política de no autenticados restringida: lo suficiente para el onboarding, no para internet en general.
- Separar la lógica de invitados y empleados: no permita que la intercepción del portal afecte a los SSID corporativos gestionados o basados en certificados.
Si está sustituyendo el acceso basado en contraseña por flujos de trabajo de identidad, el networking basado en identidad es el modelo adecuado. Cambia el acceso de usuarios conocidos, alejándose de los flujos cautivos y dirigiéndose hacia una conectividad autenticada y basada en políticas.
El registro de datos es importante en el Reino Unido
En el contexto del sector público y las empresas del Reino Unido, el estándar de seguridad inalámbrica SS-019 exige que se registren las autenticaciones del Captive Portal de invitados, se investiguen los intentos fallidos del portal, se registren los cambios de configuración con la identidad del operador y se establezcan umbrales de supervisión de tráfico para que la actividad maliciosa pueda atribuirse a credenciales individuales. También señala anomalías como un número inusualmente alto de dispositivos en un único punto de acceso, un tráfico anormalmente alto de un cliente y muchos intentos fallidos de conexión en un periodo corto (UK wireless security standard SS-019).
Eso cambia la forma en que yo implementaría la detección. No se limite a registrar "impacto en el portal". Registre la cadena:
- Asociación e identidad del cliente
- Vedicto de portal cautivo activado por sondeo
- Éxito o fallo del portal
- Cambio de política después de la autenticación
- Telemetría que vincula el evento de vuelta al comportamiento del punto de acceso y del cliente
Evite que los clientes zero-trust entren en conflicto con el portal
Los malos diseños se desmoronan aquí. Algunas herramientas de seguridad de endpoints tratan los estados cautivos como excepcionales y relajan los controles temporalmente. Si la red provoca detecciones cautivas falsas, esos clientes pueden fluctuar entre la lógica de incorporación y la aplicación normal de políticas.
Un patrón más seguro es:
- Los dispositivos conocidos utilizan primero la autenticación empresarial
- Los dispositivos de invitados y desconocidos entran en una ruta de incorporación restringida
- La detección de portal sigue disponible como respaldo
- Los equipos de VPN y zero-trust validan el comportamiento en versiones de cliente representativas antes del despliegue
Una opción de plataforma en ese espacio es Purple, que admite el registro de WiFi de invitados y patrones de acceso basados en identidad en hardware de red de terceros. Esto resulta útil cuando se necesita soporte de portal para invitados pero se desea reducir la dependencia de los portales para usuarios habituales o gestionados.
Pruebas, resolución de problemas y monitorización que mantienen la detección fiable
La detección del Captive Portal falla. Por eso las pruebas de aceptación puntuales no son suficientes.
La suposición que yo cuestionaría es la siguiente: si la página del portal se carga durante la puesta en marcha, el trabajo está hecho. No es así. El funcionamiento fiable depende de mantener intacto el flujo de trabajo de sondeo a través de las actualizaciones del sistema operativo, los cambios de filtrado, las integraciones de identidad y los cambios de seguridad en el endpoint.
Una rutina práctica de verificación
Utilice una lista de verificación breve cada vez que modifique el acceso de invitados, la política de DNS, el filtrado o el comportamiento del controlador:
- Validación de extremos de sonda: confirmar que cada familia importante de clientes recibe el tipo de respuesta que espera.
- Cordura en las redirecciones: comprobar que existan redirecciones de un solo salto en lugar de bucles.
- Inspección de filtrado: asegurarse de que los filtros web o las capas de proxy no estén reescribiendo el contenido del cuerpo o las cabeceras.
- Comportamiento del DNS: confirmar que los clientes no autenticados resuelven lo que necesitan para la incorporación y nada más.
- Recuperación tras la autenticación: verificar que los clientes vuelven a evaluar la conectividad de forma limpia después de la autenticación.
- Comprobaciones puntuales multiplataforma: realizar pruebas en Windows, macOS, iOS y Android con dispositivos representativos tanto gestionados como no gestionados.
Supervise las señales adecuadas
Para las operaciones en el Reino Unido, la fiabilidad de la detección debe supervisarse junto con la telemetría de seguridad, no de forma aislada. SS-019 es útil en este caso porque orienta a los equipos hacia la auditabilidad y el control de anomalías, no solo al seguimiento del éxito de los inicios de sesión.
Yo vigilaría:
- Ráfagas de intentos de conexión fallidos
- Densidad inesperada de clientes en un único AP
- Fallos repetidos del portal desde el mismo tipo de cliente
- Discrepancias entre el éxito de la asociación y las sesiones útiles de internet
- Cambios bruscos tras actualizaciones de endpoints o navegadores
"Conectado" no es un estado de éxito significativo para el WiFi de invitados. Lo es tener una conectividad utilizable.
Cuándo mantener la detección y cuándo retirarla
Esta es la pregunta estratégica que muchos equipos evitan. Algunas instalaciones todavía necesitan un Captive Portal para la captura de identidad de invitados, la aceptación de condiciones o los flujos de trabajo de acceso público. De acuerdo. Manténlo, pero trata la detección como una ruta de respaldo cuidadosamente probada.
Para visitantes frecuentes, empleados y usuarios gestionados, la necesidad empresarial de alejarse de los Captive Portals es cada vez mayor. La cobertura en el Reino Unido de OpenRoaming y Passpoint indica que estos enfoques "por fin están ofreciendo" una incorporación automática y segura sin tener que iniciar sesión repetidamente en un Captive Portal, y un informe del sector en el Reino Unido revela que el 38% de los encuestados ya había desplegado una red compatible con OpenRoaming o Passpoint, con un 32% que planea desplegarlas en 2026 y un 18% en 2027, tal y como se proyecta en dicho informe (cobertura de Networking+ sobre la dirección de la tecnología inalámbrica en el Reino Unido).
Eso no significa que los portales vayan a desaparecer mañana. Significa que muchas redes deberían dejar de diseñarse en torno a ellos como el recorrido principal del usuario. En un entorno empresarial moderno del Reino Unido, la detección de Captive Portal a menudo pertenece a la misma categoría que otras funciones de compatibilidad heredadas. Necesaria en algunos lugares. Conviene minimizarla en muchos otros.
Si intenta reducir la fricción del portal sin perder el control, Purple ofrece autenticación de WiFi para invitados, acceso basado en la identidad y compatibilidad con enfoques como OpenRoaming y Passpoint que pueden disminuir su dependencia de la detección del Captive Portal. Si esa es la dirección que está tomando su infraestructura, vale la pena ver cómo encaja Purple con su infraestructura de red existente y sus políticas de incorporación.