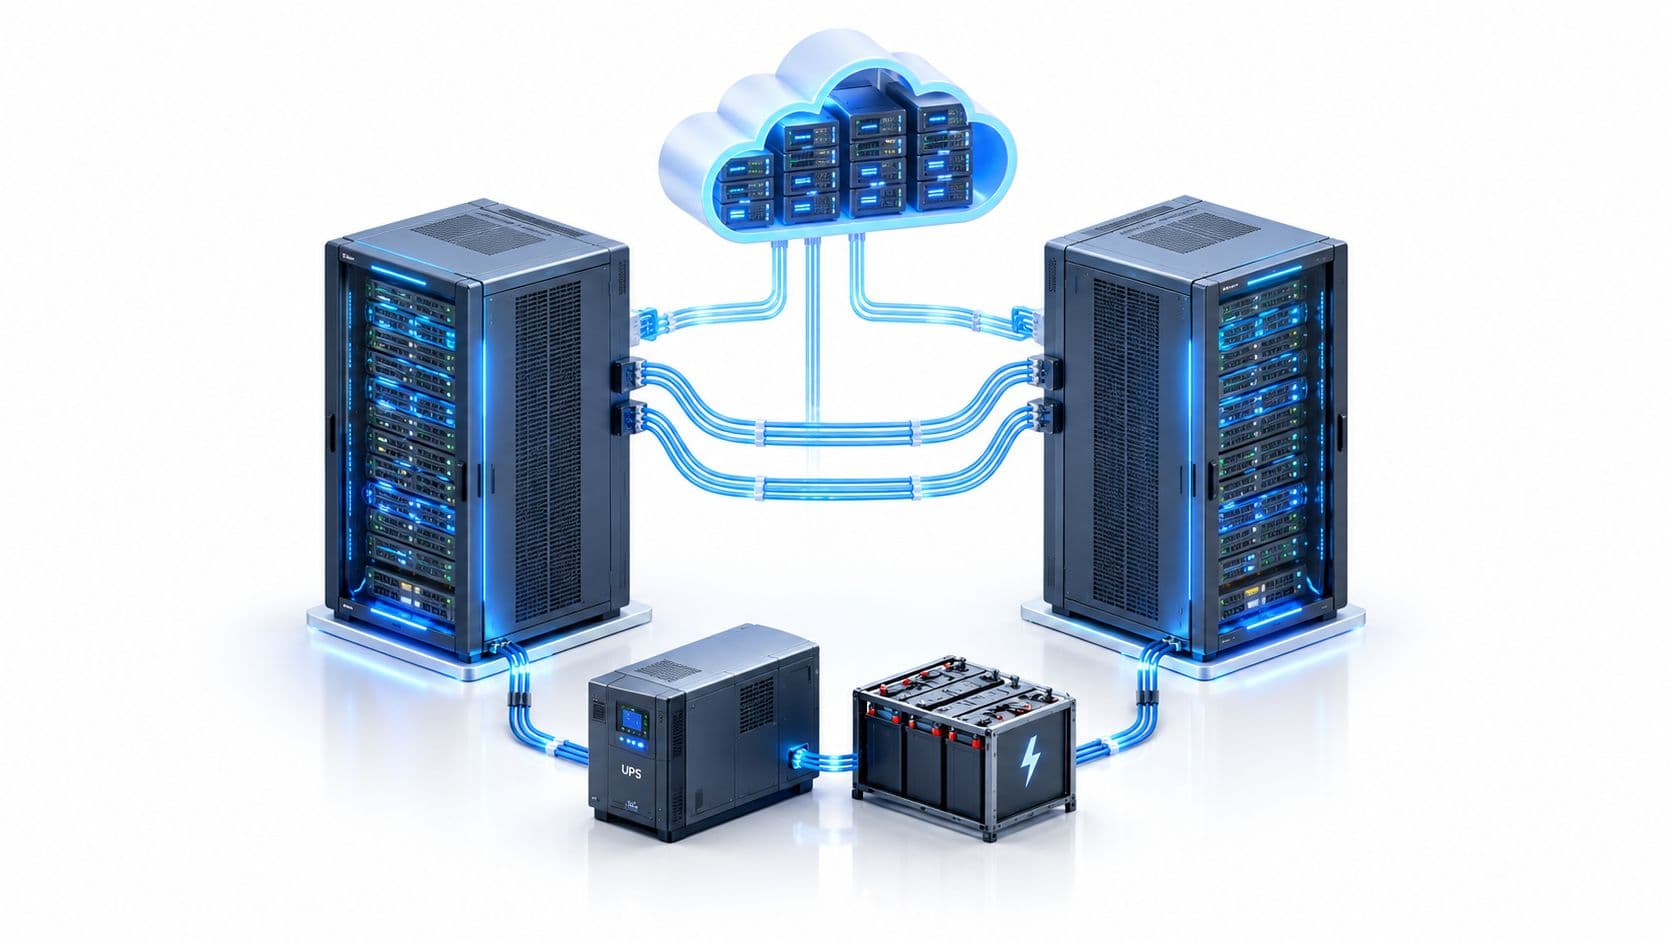
Un hotel perde l'accesso a Internet durante il check-in. Gli ospiti non riescono a autenticarsi al WiFi, i terminali delle carte vanno in timeout, il personale perde l'accesso ai sistemi cloud e la reception inizia a distribuire una password condivisa che nessuno può revocare. Il circuito di backup esiste, ma la policy del firewall non è mai stata testata. Il secondo server RADIUS è configurato, ma nessuno sa se gli access point lo raggiungeranno. L'UPS segnala uno stato integro solo perché nessuno ha controllato la batteria sotto carico.
Questo non è un problema hardware. È un fallimento della pianificazione della ridondanza.
La resilienza della rete significa mantenere disponibili l'autenticazione, la connettività e i servizi essenziali quando si verifica un guasto a un componente, a un collegamento, a una sede, all'alimentazione o a una dipendenza di identità. Uno switch di riserva in un armadio non crea resilienza. Un percorso testato che mantiene attiva una VLAN di pagamento, un'applicazione clinica, l'accesso del personale o una sessione WiFi ospiti lo fa.
Cosa significa realmente pianificare la ridondanza per le reti moderne
La pianificazione della ridondanza di rete è una disciplina di business continuity, non un esercizio di acquisto di apparecchiature. La domanda non è se possiedi due switch. È se gli utenti possono ancora connettersi, autenticarsi, risolvere i servizi e raggiungere le applicazioni che mantengono attiva l'attività dopo un guasto definito.
Ciò richiede una visione chiara dei domini di guasto. Un dominio di guasto è un componente o una dipendenza che può guastarsi in modo indipendente, interrompendo il servizio. I domini tipici includono:
- Infrastruttura di accesso, inclusi switch, access points, budget PoE, uplink e controller wireless.
- Servizi di identità, inclusi RADIUS, integrazioni di directory, certificati, captive portals e identity providers.
- Servizi core, inclusi DHCP, DNS, funzioni di gateway e policy di rete.
- Percorsi esterni, inclusi circuiti WAN, apparecchiature ISP, piattaforme cloud e servizi di autenticazione di terze parti.
- Strutture, inclusa la distribuzione dell'alimentazione, le batterie UPS, la copertura dei generatori e le sale IDF.
Un design può avere router core resilienti e fallire comunque all'edge. Se la risoluzione DNS si interrompe, gli utenti potrebbero essere connessi al WiFi ma impossibilitati a raggiungere i servizi di cui hanno bisogno. Se il RADIUS smette di rispondere, una rete wireless funzionante può rifiutare ogni accesso del personale o degli ospiti. Se il Captive Portal dipende da un unico percorso cloud non raggiungibile, la sede potrebbe avere copertura radio ma senza un accesso ospiti utilizzabile.
Separare la continuità del servizio dalla ridondanza dei componenti
Inizia dai servizi, non dai dispositivi. Identifica i servizi che l'azienda deve preservare, quindi traccia ogni dipendenza per ciascuno di essi. L'autenticazione WiFi per gli ospiti, ad esempio, può dipendere da access point, switching, PoE, piano di controllo wireless, DHCP, DNS, accesso WAN, RADIUS, provider di identità e dal portale stesso.
Un utile riferimento per la pianificazione WiFi dei team di rete dovrebbe portare alla stessa conclusione: l'accesso wireless è un sistema operativo, non uno strato radio semplicemente agganciato alla LAN.
I datori di lavoro del Regno Unito utilizzano un significato legale distinto per la pianificazione dei licenziamenti collettivi. Qualora un datore di lavoro proponga di licenziare 20 o più dipendenti presso un'unica sede entro un periodo mobile di 90 giorni, si applica la consultazione collettiva, che deve iniziare almeno 30 giorni prima del primo licenziamento per esuberi da 20 a 99 dipendenti o 45 giorni prima per 100 o più dipendenti. Le linee guida sulla consultazione del governo del Regno Unito spiegano che la consultazione deve riguardare i motivi dei licenziamenti proposti, i modi per evitarli e i modi per ridurne il numero. Questo rappresenta un quadro di pianificazione delle risorse umane. La disciplina di rete qui descritta riguarda invece i guasti di servizio, la mappatura delle dipendenze e l'architettura di ripristino.
Regola pratica: Non contare i dispositivi di backup. Conta i percorsi indipendenti dall'utente al servizio.
Il resto di questa guida adotta questa prospettiva pratica. Identifica i rischi di guasto, stabilisci obiettivi di ripristino che riflettano l'impatto aziendale, seleziona un'architettura che il tuo team sia in grado di gestire, proteggi ogni livello dall'alimentazione all'identità e testa il risultato in condizioni controllate. Se un componente non si è mai guastato durante una simulazione, considera la sua ridondanza come un'ipotesi, non come una certezza.
Mappare i rischi di guasto prima di progettare la soluzione
La maggior parte dei team di rete non ha bisogno di una piattaforma di governance per individuare i propri single point of failure più pericolosi. Hanno bisogno di un breve registro che definisca il rischio, lo classifichi in modo coerente, assegni un responsabile e registri se qualcuno ha lavorato per ridurlo.
Utilizza tre assi:
- Probabilità, ovvero la frequenza con cui si verifica il guasto in parchi installati simili o nel proprio ambiente.
- Raggio d'azione dell'impatto, ovvero quanti utenti, siti, servizi o attività che generano ricavi diventano non disponibili.
- Complessità di ripristino, ovvero quanto sia difficile il ripristino con le competenze, gli accessi, i ricambi, il supporto del fornitore e la documentazione attualmente a disposizione.
Assegna un punteggio a ciascun asse su una scala locale, quindi moltiplica i tre valori o applica una formula ponderata. La matematica conta meno della coerenza. Un singolo circuito WAN dovrebbe avere una priorità più alta rispetto a un display di marketing isolato, poiché il suo guasto può influire su tutti i servizi dipendenti contemporaneamente.
Costruire il registro attorno alle dipendenze reali
Includi gli asset che i team spesso trascurano. Una prima analisi utile dovrebbe contenere:
- Un unico ISP WAN o circuito che serve l'intera sede.
- Un unico servizio RADIUS o un'unica integrazione con l'identity provider.
- Un unico percorso di risoluzione DNS.
- Un unico controller wireless o dipendenza di gestione cloud.
- Una sala IDF (intermediate distribution frame) senza copertura del generatore.
- Batterie UPS che segnalano lo stato ma non sono mai state testate sotto un carico significativo.
- Un Captive Portal senza una modalità degradata documentata.
- Uno stack di switch i cui uplink condividono un unico percorso fisico.
- Un servizio DHCP senza una procedura di ripristino testata.
Il registro deve anche riportare il proprietario del servizio, il proprietario tecnico, la data dell'ultimo guasto, la mitigazione attuale, la data del test e l'azione successiva. "Team di rete" non è un proprietario. Indica la persona o il team responsabile di organizzare la modifica e dimostrare che funziona.
Esempio di punteggio del registro dei rischi di rete
Quello che segue è un modello di lavoro, non una valutazione di una specifica infrastruttura. Utilizza una scala locale coerente per ciascun asse e calcola il punteggio finale nello stesso modo per ogni voce.
| Scenario di guasto | Probabilità (1-5) | Raggio d'impatto (1-5) | Difficoltà di ripristino (1-5) | Punteggio di rischio |
|---|---|---|---|---|
| Circuito WAN singolo | Valuta localmente | Valuta localmente | Valuta localmente | Probabilità × raggio d'impatto × difficoltà di ripristino |
| Servizio RADIUS singolo | Valuta localmente | Valuta localmente | Valuta localmente | Probabilità × raggio d'impatto × difficoltà di ripristino |
| Percorso del risolutore DNS singolo | Valuta localmente | Valuta localmente | Valuta localmente | Probabilità × raggio d'impatto × difficoltà di ripristino |
| Controller wireless singolo | Valuta localmente | Valuta localmente | Valuta localmente | Probabilità × raggio d'impatto × difficoltà di ripristino |
| Sala IDF senza generatore | Valuta localmente | Valuta localmente | Valuta localmente | Probabilità × raggio d'impatto × difficoltà di ripristino |
| Batterie UPS non monitorate | Valuta localmente | Valuta localmente | Valuta localmente | Probabilità × raggio d'impatto × difficoltà di ripristino |
Non aspettare un registro perfetto. Un elenco di una sola pagina con responsabili credibili è più utile di un raffinato sistema di gestione dei rischi che nessuno aggiorna. L'obiettivo immediato è la definizione delle priorità. Classifica i guasti che possono disattivare i servizi critici, quindi utilizza i risultati per impostare gli obiettivi di ripristino e scegliere l'architettura.
Le informazioni ufficiali di gestione del Regno Unito mostrano perché una pianificazione preventiva strutturata sia importante in un contesto di forza lavoro diverso ma correlato. I datori di lavoro hanno inviato 368 moduli HR1 che coprono 29.496 potenziali licenziamenti nel gennaio 2020 e 326 moduli che coprono 27.804 potenziali licenziamenti nel febbraio 2020, secondo i dati di notifica dei licenziamenti del governo. La lezione per i responsabili di rete è semplice: la pianificazione formale esiste perché i grandi cambiamenti operativi sono difficili da improvvisare. Lo stesso vale quando una rete multi-sito perde una dipendenza condivisa.
Definire obiettivi RTO e RPO in linea con il reale impatto sul business
I parametri RTO e RPO sono utili solo quando i proprietari dei processi aziendali riescono a comprenderli.
L'obiettivo del tempo di ripristino, o RTO, è il tempo massimo accettabile in cui un servizio può rimanere non disponibile. L'obiettivo del punto di ripristino, o RPO, è la perdita massima accettabile di dati, configurazione o stato della sessione dall'ultimo punto ripristinabile. Per una rete, l'RPO può riguardare la configurazione, la policy, lo stato del dispositivo, i record degli eventi o il contesto di autenticazione attivo, anziché una transazione di database tradizionale.
Traducete entrambe le misure in conseguenze operative. Chiedetevi cosa si ferma per primo quando il servizio si interrompe. La reception mette in coda gli ospiti? Le casse smettono di accettare i pagamenti? I medici perdono l'accesso alle cartelle cliniche elettroniche? Un amministratore di condominio perde il controllo degli accessi degli inquilini? Il proprietario del servizio dovrebbe indicare la conseguenza aziendale, non limitarsi a ripetere un obiettivo IT.
Utilizzare livelli di servizio anziché un'unica promessa per l'intera infrastruttura
Una mappa dei servizi pratica separa l'accesso critico dai servizi che possono attendere.
| Livello di Servizio | Esempi di Servizio | RTO Obiettivo | RPO Obiettivo | Implicazione Architetturale |
|---|---|---|---|---|
| Livello 1 | Autenticazione guest WiFi, VLAN dei pagamenti, accesso alle applicazioni cliniche | Minuti, in base alla tolleranza aziendale | Perdita minima di policy e stato di autenticazione | Percorsi indipendenti, failover rapido, identità resiliente, alimentazione testata |
| Livello 2 | WiFi per il personale, sistemi di back-office, sincronizzazione degli analytics | Circa un'ora, laddove l'operatività lo consenta | Configurazione recente e stato del servizio | Warm standby, doppi percorsi dove giustificato, ripristino documentato |
| Livello 3 | Intrattenimento per gli ospiti, splash page di marketing, reportistica non critica | Diverse ore possono essere accettabili | Il ripristino basato su backup può essere sufficiente | Standby a costo inferiore o ripristino manuale |
Questi sono esempi di pianificazione, non livelli di servizio universali. Il dipartimento finanziario dovrebbe convalidare l'obiettivo utilizzando un modello di perdita semplice: contributo stimato ai ricavi orari, interruzione operativa, esposizione della reputazione e impatto sulla conformità, il tutto diviso per il tempo di inattività che l'azienda può accettare. Evita la falsa precisione. Un servizio di pagamento potrebbe non avere una "ora media" significativa, poiché una breve interruzione durante una finestra di trading intensa può causare più danni rispetto a un'interruzione più lunga durante la notte.
L'RTO deve includere anche il tempo di rilevamento e di decisione. Un failover che si completa rapidamente dopo che un tecnico ha notato il guasto può comunque non raggiungere l'obiettivo aziendale se il monitoraggio impiega troppo tempo a generare un avviso. Includete il comportamento di propagazione DNS, la riautenticazione della sessione, la riconnessione dei dispositivi, la convergenza del firewall e l'escalation umana nella stima del ripristino.
L'RPO merita la stessa disciplina. Se una modifica di configurazione apportata poco prima del guasto scompare, il team è in grado di ricrearla? Se le sessioni degli ospiti devono eseguire nuovamente l'autenticazione, questo è accettabile? Se una directory di identità è temporaneamente non disponibile, il livello di accesso può utilizzare una policy nota e sicura senza indebolire la sicurezza?
Obiettivi di RTO aggressivi richiedono solitamente una capacità attivo-attivo o geograficamente indipendente. Un RTO più flessibile può supportare uno standby caldo, un ripristino documentato o un recupero basato su backup. Non copiare un livello di servizio enterprise da un contratto se la sede dipende ancora da un unico ISP, un'unica alimentazione o un unico percorso di identità. L'architettura deve meritarsi l'obiettivo stabilito.
Scegliere la giusta architettura di failover per la tua infrastruttura
Quattro modelli coprono la maggior parte delle implementazioni reali nelle sedi fisiche. Nessuno di essi è automaticamente corretto. La scelta giusta dipende dalla tolleranza ai tempi di inattività, dalle dimensioni dell'infrastruttura, dalle competenze operative, dall'indipendenza dai guasti e dal budget.
La configurazione attivo-attivo mantiene due o più componenti idonei a gestire il traffico contemporaneamente. I controller doppi o i cluster di accesso possono condividere il carico e un lato può continuare a funzionare in caso di guasto dell'altro. Ciò garantisce un'ottima capacità durante un guasto, ma comporta una maggiore sincronizzazione dello stato, coerenza delle policy e rischi di split-brain. Utilizzala quando il tempo di inattività è costoso e il team è in grado di monitorare adeguatamente entrambi i lati.
Active-passive mantiene un componente di standby pronto a subentrare. È più facile da gestire rispetto a un modello active-active, ma la promozione, il trasferimento di stato e il rilevamento possono creare un intervallo nel ripristino. Un hot standby è utile solo se dispone di una configurazione aggiornata, dipendenze raggiungibili e un processo di promozione testato.
N+1 fornisce un'unità di capacità di riserva per un cluster. È una risposta sensata quando una sede può tollerare la sostituzione di un componente ma non può giustificare un ambiente completamente duplicato. N+1 lascia comunque l'infrastruttura esposta a guasti condivisi, come un'alimentazione comune, un uplink comune o una configurazione errata replicata su ogni unità.
La ridondanza geografica colloca una capacità di servizio completa in un altro sito o area geografica. Risolve la perdita del sito, non solo il guasto delle apparecchiature, e comporta l'onere finanziario e operativo più elevato. È adatta per i servizi condivisi che supportano più proprietà o per le organizzazioni che non possono accettare un singolo edificio come dominio di guasto.
Confronto dell'architettura di failover
| Architettura | Costo | Complessità | RTO Tipico | Migliore Integrazione |
|---|---|---|---|---|
| Attivo-attivo | Alto | Alto | Molto breve se gestito correttamente | Servizi critici, infrastrutture più ampie, team in grado di gestire sistemi sincronizzati |
| Attivo-passivo | Da medio ad alto | Medio | Da breve a moderato, a seconda dell'attivazione | Sedi che necessitano di uno standby pronto senza instradare il traffico su entrambi i lati |
| N+1 | Medio | Medio | Moderato, a seconda della sostituzione e del provisioning | Cluster in cui un componente può coprire un nodo gemello guasto |
| Ridondanza geografica | Massimo | Massimo | Da breve a prolungato, a seconda del routing e dello stato | Operatori multi-sede e servizi esposti a guasti totali del sito |
Un gruppo alberghiero con due proprietà può utilizzare servizi active-active tra le sedi se la WAN, l'identità, il DNS, l'alimentazione e la gestione operativa sono realmente indipendenti. Un singolo negozio al dettaglio ottiene solitamente più valore da un firewall resiliente, dal traffico segmentato e da un backup LTE o 5G piuttosto che dal design di un secondo data-centre che non è in grado di gestire.
Utilizza una scorciatoia decisionale diretta. Se le risorse del personale sono limitate e l'azienda può tollerare un ripristino misurato, scegli la modalità attivo-passivo o N+1. Se le transazioni critiche richiedono continuità e il team è in grado di gestire la sincronizzazione, scegli attivo-attivo. Se l'intero sito rappresenta il rischio principale, la ridondanza geografica è la risposta. Se il budget è limitato, rimuovi le dipendenze a percorso singolo in base all'impatto aziendale, piuttosto che acquistare un duplicato del dispositivo più visibile.
Progettare livelli di rete, autenticazione e identità resilienti
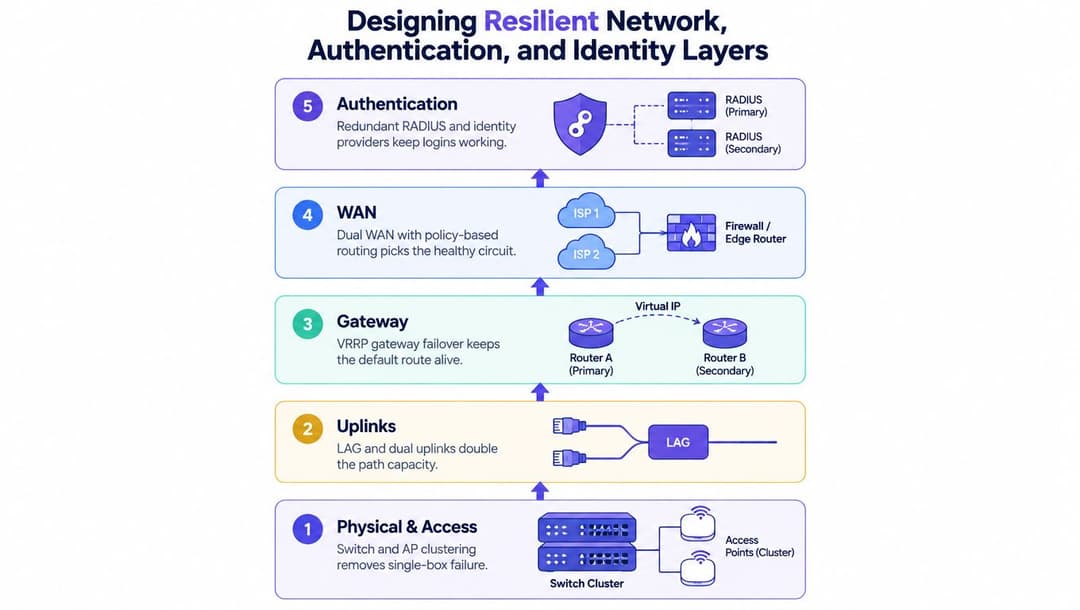
La resilienza viene meno in corrispondenza della dipendenza più debole. Costruisci lo stack a partire dallo strato fisico verso l'alto e assegna a ciascun livello un dominio di guasto indipendente.
Iniziare con l'accesso e gli uplink
Utilizza il clustering di switch e access point dove la struttura lo richiede, ma verifica che i membri del cluster non condividano un unico dominio di guasto. Due switch nello stesso rack possono comunque dipendere da un'unica linea di alimentazione. Due uplink possono comunque seguire la stessa canalina per cavi. L'aggregazione dei link può fornire capacità e resilienza del percorso, mentre i doppi uplink riducono la dipendenza da una singola porta, modulo o cavo.
Sul gateway, utilizza VRRP o un meccanismo di gateway virtuale equivalente in modo che la route di default possa spostarsi tra i dispositivi. Testa il failover del firewall stateful invece di presumere che un gateway fluttuante preservi le sessioni attive. Alcuni servizi si riconnettono in modo pulito. Altri richiedono una gestione esplicita delle sessioni.
La resilienza WAN deve combinare circuiti separati con un instradamento basato su policy che riconosca lo stato di salute generale, non solo lo stato del link. Un circuito può rimanere elettricamente attivo pur perdendo il percorso verso le applicazioni critiche. La tecnologia LTE o 5G fornisce un utile accesso out-of-band per la gestione e un percorso di fallback, ma richiede una copertura, un'alimentazione, una policy dati e controlli di sicurezza dedicati.
Trattare il DNS e l'alimentazione come dipendenze di produzione
Il DNS fa parte del percorso dell'utente. Utilizza una gestione deliberata del TTL, funzionalità di risoluzione secondaria e un design split-horizon nei casi in cui le risposte interne ed esterne debbano differire. Monitora i tempi di risoluzione e i fallimenti, non solo la risposta del processo di risoluzione.
Anche l'alimentazione ha bisogno di livelli. Combina la protezione degli UPS con un budget PoE realistico, alimentazioni separate dove l'edificio lo consente e copertura del generatore per le stanze che ospitano le dipendenze di rete. Un UPS con una batteria guasta non è resilienza. E non lo è nemmeno un generatore che non raggiunge il livello di accesso.
Proteggere l'autenticazione con la stessa cura della connettività
RADIUS dovrebbe avere istanze di servizio indipendenti e un ordine di failover testato. Il comportamento del Captive Portal richiede una modalità degradata definita. Chiediti se un utente già autenticato può continuare, se un nuovo utente può completare il percorso e cosa succede quando l'identity provider non è raggiungibile.
Per l'accesso del personale, un servizio RADIUS gestito in cloud può ridurre la dipendenza da un singolo server on-premise, ma richiede comunque disponibilità multi-regione, endpoint monitorati, certificati aggiornati e una chiara responsabilità di ripristino. Il servizio RADIUS Entra ID di Purple rappresenta un'opzione per connettere l'accesso di rete con l'identità basata su directory, mantenendo il livello di autenticazione al centro del dibattito sulla resilienza.
Ogni livello deve fallire in modo indipendente. Se entrambi i nodi RADIUS utilizzano lo stesso host virtuale, entrambi i percorsi DNS utilizzano lo stesso resolver e entrambi i circuiti WAN entrano attraverso lo stesso condotto, il diagramma è ridondante ma l'infrastruttura non lo è.
Test, monitoraggio e runbook che individuano realmente i disservizi
L'architettura sulla carta non corrisponde all'architettura in produzione. L'unico modo affidabile per convalidare un percorso di failover è testarlo in condizioni controllate, osservare l'esperienza dell'utente e correggere ciò che si interrompe.
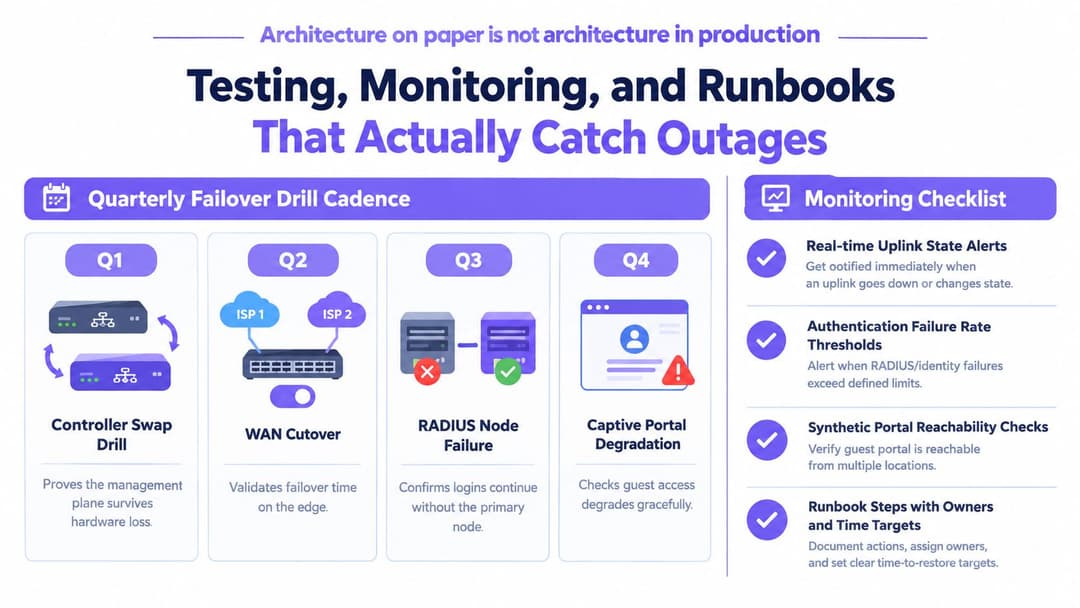
Esegui un programma di esercitazioni trimestrali, concentrandoti su un tipo di guasto diverso ad ogni ciclo:
- Scambio del controller: Dimostra che la gestione e il servizio wireless continuano dopo la rimozione del controller primario.
- Cutover della WAN: Convalida il rilevamento del circuito, il routing delle policy, lo stato del firewall e la raggiungibilità delle applicazioni.
- Guasto del nodo RADIUS: Conferma che i nuovi accessi e la riautenticazione utilizzino il servizio secondario.
- Degradazione del Captive Portal: Verifica che l'accesso ospiti fallisca in modo sicuro e che gli utenti esistenti ricevano l'esperienza prevista.
Il caos controllato è meglio di un esercizio teorico. In una notte a basso rischio, scollega uno stack di switch, disabilita un percorso WAN o isola un nodo RADIUS con una richiesta di modifica approvata. Mantieni il test circoscritto, definisci un piano di rollback e fai in modo che il responsabile del servizio osservi l'impatto sul business invece del solo pannello di monitoraggio.
Monitorare i sintomi, non la vanità dei dispositivi
I segnali utili includono:
- Raggiungibilità del controller e stato del cluster.
- Latenza di risposta RADIUS e tasso di errore di autenticazione.
- Tempo di risoluzione DNS e query non riuscite.
- Stato di associazione dell'access point e riassociazione del client.
- Utilizzo dell'uplink, errori e modifiche del percorso.
- Raggiungibilità sintetica del Captive Portal.
- Stato di integrità della WAN basato su probe applicative, non solo sullo stato dell'interfaccia.
Impostate le soglie di avviso in base all'impatto sul cliente. Un piccolo aumento degli errori di autenticazione può indicare un'interruzione dell'identità prima che gli utenti chiamino l'assistenza. Un uplink a capacità costante può essere il precursore di un failover degradato. Non inviate notifiche ai tecnici per ogni evento transitorio. Fatelo quando diversi segnali si combinano in un sintomo del servizio.
Un runbook deve contenere un albero decisionale, i responsabili delle escalation designati, l'ordine di contatto dei vendor, i requisiti di accesso, i passaggi di rollback e gli obiettivi temporali legati all'RTO del servizio. Includi screenshot o posizioni esatte della console dove opportuno, ma non affidarti alla conoscenza informale del team. Dopo ogni simulazione, registra il tempo di rilevamento, il tempo di decisione, il tempo di ripristino, l'impatto sugli utenti e le modifiche necessarie.
Il Purple WiFi latency and jitter test può supportare la validazione pratica della qualità della rete, ma nessun test sostituisce un vero esercizio di failover. Se non hai simulato il guasto di una dipendenza intenzionalmente, non l'hai validata.
Considerazioni specifiche per settore per hospitality, retail, sanità e WiFi multi-tenant
Lo stesso modello di resilienza richiede priorità diverse in base ai differenti ambienti. Inizia classificando i servizi, quindi scegli i controlli di identità e di rete che proteggono il percorso utente a più alto valore.
| Settore | Servizi Tier-1 | Configurazione di failover consigliata | Rischio chiave per identità e rete |
|---|---|---|---|
| Hospitality | Autenticazione ospiti, accesso ai pagamenti, sistemi della struttura, connettività del personale | Doppia WAN, RADIUS resiliente, ripristino del captive portal testato, alimentazione protetta | La dipendenza da un portale o da un login ospite condiviso può interrompere il check-in e l'erogazione dei servizi |
| Retail | Traffico POS, servizi di pagamento, operazioni del negozio, accesso dello staff | VLAN isolate, edge resiliente, backup LTE o 5G, commutazione di circuito testata | Il traffico di pagamento e operativo può competere con l'accesso WiFi ospiti in assenza di una segmentazione rigorosa |
| Healthcare | WiFi clinico, cartelle cliniche elettroniche, telemetria, BYOD approvato | Livelli di rete supportati da batteria, identità resiliente, ripristino della crittografia controllato, modifiche pronte per l'audit | Un guasto all'autenticazione o all'alimentazione può interrompere i flussi di lavoro clinici e creare rischi per la sicurezza |
| Strutture multi-tenant | Accesso tenant, WiFi aree comuni, operazioni dell'edificio, servizi del personale | SSID segmentati, criteri basati sui tenant, domini di autenticazione indipendenti, percorsi diversificati | Un errore di identità, DNS o policy di un singolo operatore può propagarsi a cascata su tutti i tenant |
Gli operatori del settore alberghiero e della ristorazione dovrebbero trattare il WiFi per gli ospiti come un canale operativo e commerciale, non come un servizio di cortesia. I team del settore retail dovrebbero mantenere i percorsi di pagamento isolati dal traffico degli ospiti e verificare che il circuito di backup supporti l'effettivo flusso delle transazioni. Gli amministratori sanitari hanno bisogno di registri delle modifiche conformi ai controlli di audit, verificando al contempo che le apparecchiature alimentate a batteria coprano il percorso di accesso utilizzato dai medici.
Per stadi, edifici residenziali, spazi di coworking e altre sedi multi-tenant, la segmentazione deve estendersi anche all'autenticazione e al DNS. Gli SSID separati da soli non garantiscono l'isolamento dei tenant se le policy, le ricerche di identità o i percorsi di gestione rimangono condivisi.
Una prima mossa sensata è un inventario pilota di 30 giorni. Catalogate access points, switch, controller, circuiti WAN, servizi di identità, DNS, alimentazione e proprietari in una proprietà o sede rappresentativa. Quindi create una mappa SLA stratificata per il settore, eseguite un failover controllato e utilizzate i risultati per finanziare la successiva riduzione del rischio. L'attuale pressione sulla pianificazione della forza lavoro rende importante anche l'aspetto del rischio legato alle persone. Il CIPD Labour Market Outlook per l'estate 2026 ha riferito che il 21% dei datori di lavoro del Regno Unito ha pianificato licenziamenti nei tre mesi fino a settembre 2026. Meno persone significano meno tolleranza per il lavoro di ripristino non documentato, quindi progettate runbook e responsabilità prima del prossimo cambiamento di personale.
Anche gli obblighi di licenziamento collettivo nel Regno Unito rendono gli asset frammentati un problema di tempistiche e dati. Le linee guida governative sulle consultazioni in materia di licenziamento stabiliscono che la soglia di 20 o più dipendenti si applica a una singola sede entro 90 giorni, con tempistiche di notifica legate all'intervallo di licenziamento proposto. Per i responsabili di rete, la lezione analoga è mappare i siti e le dipendenze in modo preciso. Un patrimonio multi-sito non può presumere in modo sicuro che edifici, circuiti o team separati creino domini di guasto separati senza dimostrare come si connettono il traffico, l'identità e le operazioni.
Purple offre autenticazione WiFi gestita in cloud e accesso basato sull'identità, inclusa la funzionalità RADIUS progettata con percorsi di servizio ridondanti, in modo da poter far parte di un piano di resilienza anziché lasciare l'accesso ospiti come un singolo punto di vulnerabilità nascosto. Verifica come Purple si adatta ai requisiti di rete, identità e failover, quindi inizia con un inventario a livello di proprietà e una simulazione di autenticazione controllata.