Ti colleghi a un SSID ospite, il laptop dice che è connesso, lo smartphone non apre nulla, Windows segnala connettività limitata e l'helpdesk viene incolpato per un "portale non funzionante". Il più delle volte, la pagina del portale non è il primo problema. Lo è invece il rilevamento del Captive Portal.
Questa distinzione è più importante oggi rispetto a qualche anno fa. Nelle infrastrutture aziendali miste del Regno Unito, il flusso di lavoro di rilevamento influisce sull'esperienza utente, sul comportamento di sicurezza degli endpoint, sulla registrazione dei log e sulla stabilità degli strumenti zero-trust durante l'onboarding. Se lo consideri solo come "ciò che fa apparire la splash page", ti sfuggiranno i problemi che lasciano gli utenti senza connessione.
Cosa fa Effettivamente il Rilevamento del Captive Portal
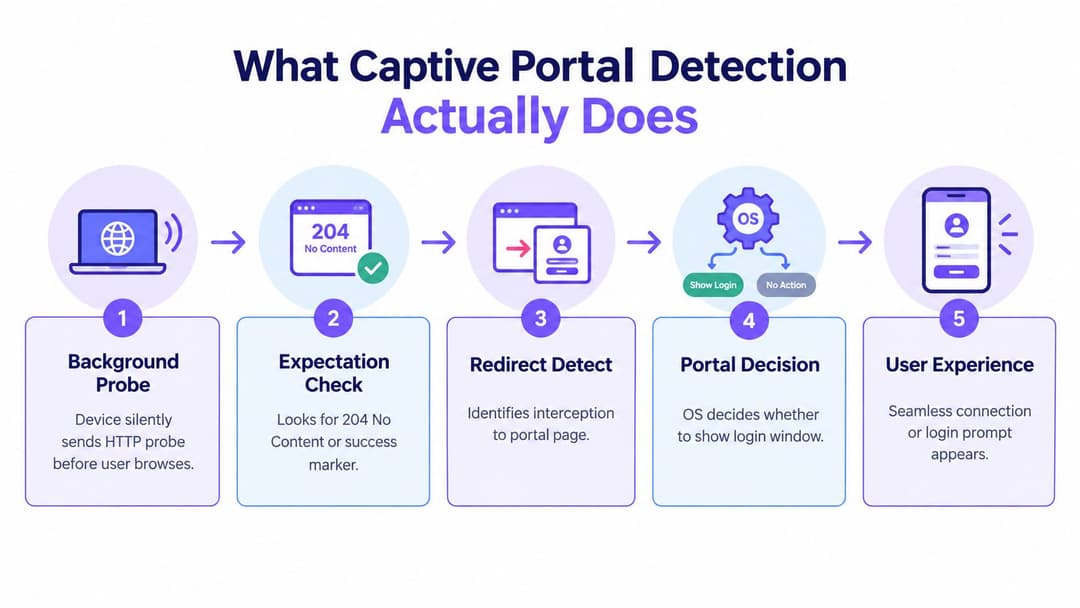
Un Captive Portal non inizia con la pagina del portale. Inizia con la decisione del client se la rete ha o meno un accesso illimitato a Internet.
Quando un dispositivo si connette al WiFi, il sistema operativo invia solitamente una richiesta HTTP in background a un endpoint controllato dal fornitore. Se la risposta corrisponde a quella prevista dal client, il dispositivo presuppone l'accesso a internet aperto e non interviene. Se la risposta viene reindirizzata, modificata o bloccata, il sistema operativo decide che probabilmente esiste un portale e avvia una procedura di login.
Il rilevamento è il cancello, non l'accesso
Questo è il punto in cui molti team fanno confusione:
- Rilevamento: stabilisce se l'utente debba visualizzare o meno un portale.
- Autenticazione: stabilisce se l'utente è autorizzato ad accedere.
- Autorizzazione: stabilisce cosa l'utente può raggiungere successivamente.
Se il rilevamento fallisce, il portale può essere perfettamente integro ma nessuno lo vedrà mai. Se il rilevamento ha successo ma l'autenticazione fallisce, gli utenti vedranno la pagina ma non avranno comunque accesso. Si tratta di guasti diversi, con soluzioni diverse.
Un modello mentale utile consiste nel trattare il rilevamento del Captive Portal come un verdetto di connettività gestito dal sistema operativo. Non è il browser a guidare, è il sistema operativo.
Perché questo è importante nelle reti reali
Questo non è un caso limite di nicchia. Uno studio sugli hotspot ha rilevato che 484 reti hanno raggiunto il primo test di rilevamento del Captive Portal e 390 reti distinte utilizzavano una qualche forma di Captive Portal, dimostrando che il rilevamento del portale era già attivo su scala reale di implementazione piuttosto che solo in configurazioni di laboratorio (riepilogo dello studio).
Questa scala è importante perché ognuna di queste reti dipende dal fatto che i client interpretino correttamente le risposte dei probe. In pratica, ciò significa che l'esperienza utente dipende da un piccolissimo scambio: un codice di stato, un corpo di risposta o un reindirizzamento.
Regola pratica: se gli utenti dicono "il portale non è apparso", ispeziona il percorso della sonda prima di ispezionare la pagina del portale.
Perché il problema è cambiato
In passato, la risoluzione dei problemi relativi agli hotspot si concentrava sulla visualizzazione della splash page. Questo fa ancora parte del lavoro, ma le infrastrutture moderne presentano un ulteriore livello di complessità. Anche gli agent di sicurezza, i client VPN e gli strumenti di onboarding reagiscono quando rilevano la presenza di un Captive Portal. Mozilla documenta che Firefox verifica endpoint dedicati al portale prima di aprire una pagina di accesso, mentre Cloudflare rileva che il proprio client può inviare più richieste di portale specifiche per il sistema operativo e potrebbe aprire completamente il firewall di sistema fino al completamento dell'onboarding, trasformando il rilevamento in un problema di affidabilità e sicurezza degli endpoint, e non solo in un problema di accesso (Mozilla captive portal support article).
Ecco perché i team esperti ora si pongono due domande, non una. In primo luogo, la rete è in grado di attivare il portale in modo coerente? In secondo luogo, questo patrimonio infrastrutturale dovrebbe ancora affidarsi a quel flusso di lavoro come metodo di accesso primario?
Sonde Principali ed Euristiche Dietro un Rilevamento Affidabile
Un client si connette al WiFi, ottiene il DHCP, mostra un buon segnale, eppure segnala "Nessuna connessione Internet" o non apre mai la finestra di accesso. In quasi tutti i casi, il problema risiede nel percorso del probe, non nella pagina del portale.
Cosa stanno verificando effettivamente i client
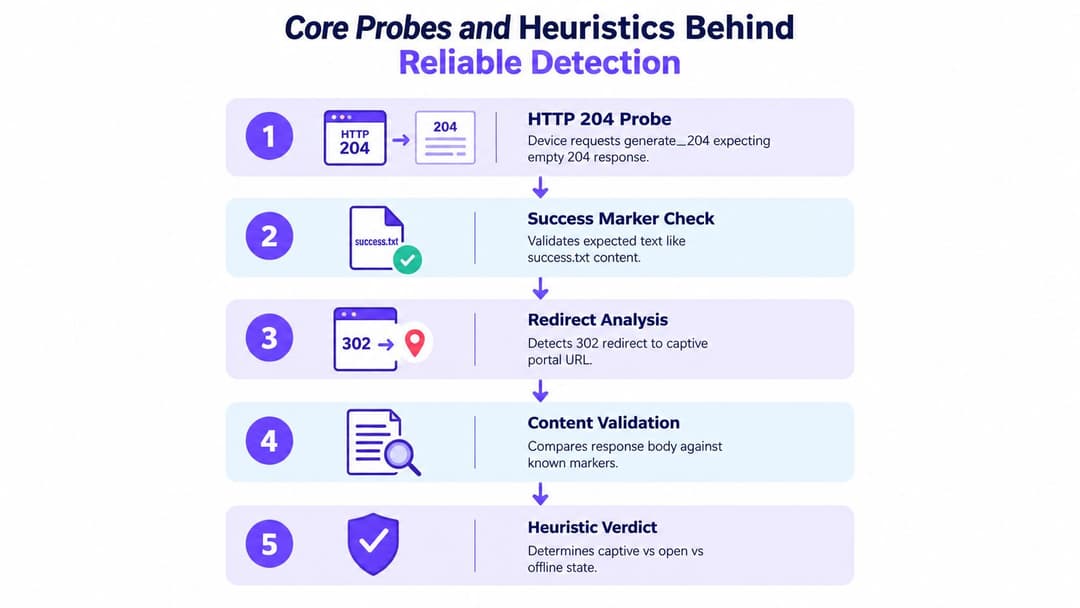
Il rilevamento del Captive Portal è un piccolo motore decisionale integrato nel sistema operativo o nell'agente client. Il dispositivo invia una richiesta nota a un endpoint noto, confronta la risposta con il risultato previsto e poi decide se la rete è online, protetta da portale o non funzionante. L'utente potrebbe vedere solo un browser pop-up, ma il lavoro è avvenuto pochi pacchetti prima.
I target di probe più comuni includono captive.apple.com di Apple, connectivitycheck.gstatic.com e clients3.google.com/generate_204 di Google, msftconnecttest.com/connecttest.txt di Microsoft e detectportal.firefox.com di Firefox. L'attivazione non dipende solo dal nome host, ma dalla combinazione di codice di stato, header, contenuto del corpo, comportamento di reindirizzamento e tempistica, come evidenziato nella panoramica del portale hotspot DrayTek.
La logica di solito si presenta così:
- Il client invia un probe
- La rete lo fa passare o lo intercetta
- Il client verifica la risposta rispetto al modello previsto
- Il client classifica lo stato della rete
- Il sistema operativo o l'agente decide se avviare un flusso captive, avvisare l'utente o non fare nulla
Quest'ultimo passaggio conta più di quanto molti team si aspettino. Gli agenti di sicurezza, i client VPN e gli strumenti di onboarding spesso si basano sullo stesso verdetto. Una risposta errata al probe può interrompere l'accesso, ritardare i controlli sullo stato di sicurezza o lasciare l'endpoint in uno strano stato di parziale connessione.
Cosa interrompe più spesso il rilevamento
Le modalità di errore più comuni sono banali, ripetitive e facili da trascurare durante un rapido test del browser.
- Stato HTTP errato: i controlli della famiglia Android spesso si aspettano
204 No Content. Se restituisci una pagina brandizzata200 OK, il client potrebbe classificare la rete come captive, non funzionante o instabile. - Contenuto del corpo errato: Windows e altri stack potrebbero cercare marcatori di testo normale esatti. I banner proxy, l'HTML riscritto o le funzionalità di iniezione di contenuti possono interrompere questa corrispondenza.
- Errori di reindirizzamento: un singolo reindirizzamento chiaro al Captive Portal va bene. I reindirizzamenti a catena, i loop o i reindirizzamenti che alternano tra HTTP e HTTPS causano spesso errori silenziosi.
- Interferenza DNS: il dirottamento del DNS, il DNS split-horizon o i resolver ricorsivi che rispondono in modo incoerente possono inviare i probe in una posizione non prevista dal client.
- Intercettazione TLS: il filtraggio HTTPS e la sostituzione dei certificati causano regolarmente reclami del tipo "connesso, senza internet" perché il client non si fida più del risultato del probe.
- Problemi di tempistica e raggiungibilità: la lentezza del DNS a monte, i CDN bloccati per le risorse del portale o la mancanza di liste di elementi consentiti per i provider di identità possono far oscillare il rilevamento tra i vari stati.
Un controllo pratico per il rollout consiste nel creare prima la lista di elementi consentiti per la pre-autorizzazione e testarla separatamente. Strumenti come il generatore di walled garden per domini di Captive Portal e dipendenze di Purple aiutano a individuare gli host di probe, le risorse del portale, i reindirizzamenti di identità e le destinazioni post-autenticazione che richiedono un trattamento diverso.
Un errore ambiguo sovraccarica la coda dei ticket. Un errore netto è più facile da diagnosticare.
Perché le euristiche sono fragili
Questi controlli sono fragili perché sono stati progettati per dedurre lo stato della rete da uno scambio minimo, spesso prima che il dispositivo abbia pieno accesso. Piccoli cambiamenti nel filtraggio dei contenuti, nell'ispezione SSL, nei reverse proxy o nelle policy del firewall possono modificare il risultato senza che nessuno tocchi il portale stesso.
Vedo questo scenario molto spesso negli SSID di onboarding e guest aziendali dove diversi team gestiscono parti differenti del percorso. Il team wireless vede l'associazione riuscire. Il team del firewall vede una policy di reindirizzamento consentita. Il team della sicurezza vede l'ispezione HTTPS funzionare come previsto. L'endpoint vede solo una risposta di probe che non corrisponde più a ciò che aveva richiesto.
Questo è il motivo per cui il rilevamento del Captive Portal dovrebbe essere trattato come un controllo di affidabilità e sicurezza dell'endpoint, e non solo come una funzionalità di comodità che fa apparire una pagina di login. Se il rilevamento non è affidabile, gli utenti non riescono a effettuare l'onboarding, gli agenti di sicurezza possono interpretare erroneamente la raggiungibilità e i team di supporto finiscono per risolvere i problemi sul livello errato.
Spiega anche perché alcune realtà aziendali dovrebbero smettere di fare affidamento sui flussi di lavoro captive come metodo di accesso primario. Per l'accesso degli ospiti BYOD, i visitatori che soggiornano per brevi periodi e l'onboarding legacy, il rilevamento del portale ha ancora un suo ruolo. Per gli utenti gestiti nelle grandi aziende del Regno Unito, Passpoint o OpenRoaming offrono spesso un risultato migliore perché le decisioni di accesso passano dalle fragili euristiche HTTP a un accesso di rete autenticato fin dall'inizio.
Come si presenta una configurazione ottimale
Un'implementazione solida presenta alcune caratteristiche costanti:
- La gestione dei probe è deliberata: ogni famiglia principale di client riceve il modello di risposta che si aspetta nello stato di pre-autenticazione.
- I percorsi di pre-autenticazione sono strettamente definiti: sono raggiungibili solo i domini probe richiesti, i componenti del portale, gli endpoint di identità e i percorsi di aggiornamento.
- I controlli di sicurezza riconoscono il traffico dei probe: proxy, filtri e policy di ispezione TLS non riscrvono o intercettano questi controlli per errore.
- I cambi di stato sono rapidi dopo l'autenticazione: una volta che l'utente è autorizzato ad accedere, il client può verificare nuovamente la connettività e cancellare il verdetto di captive senza dover disattivare e riattivare il WiFi.
- I team operativi possono eseguire test a livello di pacchetto: possono prevedere l'esito del client dalle tracce DNS, HTTP e di reindirizzamento, anziché da uno screenshot del browser.
Se il team sa spiegare perché un dispositivo ha contrassegnato la rete come captive, aperta o non funzionante solo in base allo scambio non elaborato, la progettazione del rilevamento è solitamente a buon punto.
Come i principali sistemi operativi gestiscono il rilevamento in modo diverso
Lunedì mattina, l'SSID ospite sembra funzionare bene. I client si associano, ottengono l'IP tramite DHCP e mostrano un buon segnale. Poi le segnalazioni di assistenza si dividono per tipo di dispositivo. Gli iPhone si collegano ma non mostrano mai la schermata di accesso, i telefoni Android dichiarano immediatamente che è richiesto l'accesso e i laptop Windows rimangono su "Nessuna connessione Internet" abbastanza a lungo da spingere gli utenti a incolpare il WiFi. Ecco perché il rilevamento del portale deve far parte del manuale di affidabilità della rete, non solo della progettazione dell'accesso ospiti.
Le differenze sono minime sulla carta ma costose in produzione. Ogni piattaforma testa la connettività a modo suo e ognuna reagisce male a modalità di errore leggermente diverse. In ambienti misti, queste particolarità si sovrappongono anche ai controlli degli endpoint come il filtraggio web, l'ispezione TLS, gli agenti VPN e i controlli specifici del browser. Un portale che "funziona solo in un browser" non sta funzionando correttamente.
Confronto delle Aspettative delle Sonde OS
| Famiglia Client | Endpoint di Probe | Segnale di Successo Previsto |
|---|---|---|
| Apple | captive.apple.com |
Risposta HTTP contenente la pagina di successo prevista |
| Stack Android e Google | connectivitycheck.gstatic.com o clients3.google.com/generate_204 |
204 No Content |
| Windows | msftconnecttest.com/connecttest.txt |
Testo semplice Microsoft Connect Test previsto |
| Firefox | detectportal.firefox.com |
Risposta di rilevamento del portale prevista utilizzata da Firefox |
Apple spesso fallisce silenziosamente
Apple offre solitamente l'esperienza utente più fluida quando il percorso di pre-autenticazione è configurato correttamente. Quando è errato, il malfunzionamento può avvenire in modo quasi invisibile. Il dispositivo si associa all'SSID, ottiene un indirizzo e appare normale nel controller, ma l'assistente per il Captive Portal non si apre mai.
In pratica, ciò indica due cause comuni. La prima è un'intercettazione del probe che non corrisponde a ciò che Apple considera captive. La seconda è la modifica dei contenuti da parte di un controllo di sicurezza a monte. Una pagina di blocco, l'iniezione di intestazioni o una policy di gestione SSL possono alterare la risposta al punto che il dispositivo non si fida più del risultato. I team di supporto si concentrano quindi su problemi di RF o DHCP quando il vero problema è l'integrità HTTP.
Android è più facile da testare e meno tollerante
Il modello di Android 204 No Content è netto. Questo aiuta durante la diagnosi perché il comportamento atteso è chiaro, ma significa anche che i piccoli errori emergono rapidamente. Se si restituisce un reindirizzamento, un corpo HTML o una risposta filtrata laddove Android non si aspettava nulla, il client potrebbe contrassegnare la rete come captive o limitata.
Questa severità è utile. Se Android risulta instabile sullo stesso SSID in cui Apple sembra funzionare correttamente, inizia analizzando il comportamento del proxy, il filtraggio dei contenuti e la logica di reindirizzamento prima di esaminare il livello wireless.
Windows evidenzia problemi di tempistica e di policy
Windows tende a evidenziare l'ambiguità in modo più evidente rispetto ad Apple. Gli utenti riscontrano una connettività limitata, lunghi ritardi prima che appaia il portale o una connessione che sembra stabilita ma che fallisce il traffico delle applicazioni in modi insoliti. Nelle reti aziendali, questo spesso si interseca con gli strumenti di sicurezza. I client VPN sempre attivi, i moduli di protezione web e i firewall host possono influenzare gli stessi controlli che Windows utilizza per verificare lo stato della connettività.
Microsoft documenta l'attuale comportamento e gli endpoint di NCSI all'interno delle proprie linee guida, che rappresentano il punto di riferimento corretto per i client Windows attuali. La lezione operativa è più semplice. Se NCSI viene intercettato, filtrato o risponde troppo lentamente, gli utenti lo avvertiranno prima ancora di rendersene conto.
Firefox può non essere in linea con l'OS host
Firefox merita un'attenzione separata sui desktop perché esegue una propria logica di portale. Il laptop potrebbe mostrare una connettività normale mentre Firefox si comporta ancora come se l'accesso fosse limitato, o viceversa. Questa non è solo una particolarità del browser. Crea un reale sovraccarico per il supporto perché il sistema operativo, il browser e l'agente endpoint possono avere ciascuno una visione diversa della stessa rete.
Nota sul campo: Quando gli utenti segnalano "Il WiFi è connesso ma Firefox è bloccato," verifica il risultato del probe del sistema operativo, il risultato del probe del browser e qualsiasi agent secure web gateway sull'endpoint. Un singolo presupposto errato in questa fase può inviare il ticket al team sbagliato.
Le infrastrutture miste richiedono una sfoltitura orientata ai dispositivi
Usa il sintomo per scegliere il primo test.
- L'iPhone si connette ma non appare la schermata di accesso: verificare la gestione dei probe Apple e confermare che il corpo della risposta sia integro.
- Android segnala immediatamente che è richiesto l'accesso: verificare se il reindirizzamento è deliberato e se qualche dispositivo sta ricevendo contenuti invece di
204. - Windows segnala assenza di internet, il portale appare in ritardo: ispezionare la raggiungibilità NCSI, i tempi di reindirizzamento, la risposta DNS e gli agent di sicurezza locali.
- Firefox si comporta in modo diverso da Chrome sullo stesso laptop: separare il rilevamento a livello di browser dallo stato di connettività del sistema operativo e dal filtraggio degli endpoint.
Questo è anche il punto in cui la decisione di progettazione conta. Per l'accesso di ospiti, visitatori e BYOD, mantenere efficiente il rilevamento del portale merita ancora lo sforzo perché il flusso di lavoro è previsto e il mix di client è imprevedibile. Per gli utenti gestiti all'interno di reti aziendali più grandi nel Regno Unito, i ripetuti casi limite del portale indicano solitamente la necessità di ridurre la dipendenza dalla logica captive e di passare a Passpoint o OpenRoaming, dove il controllo degli accessi avviene all'ingresso della rete anziché tramite fragili test HTTP post-associazione.
Rilevamento Pratico con curl Python e Agenti di Dispositivo
Il modo più rapido per smettere di tirare a indovinare è testare direttamente il percorso della sonda. Non servono catture di pacchetti per ogni caso. Inizia con controlli HTTP ripetibili, quindi conferma il comportamento su endpoint reali.
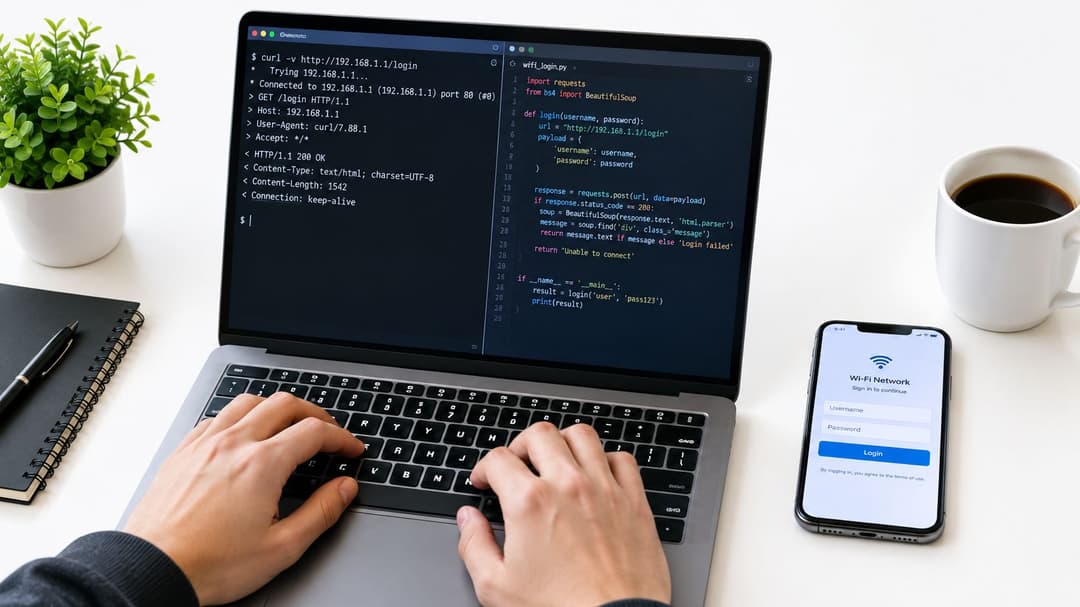
Inizia con curl
Usa curl per ispezionare codici di stato, intestazioni e reindirizzamenti dallo stesso segmento di rete del client.
Per una sonda in stile Google:
- Verificare solo lo stato: richiedere l'endpoint
generate_204e confermare se il risultato è204o un reindirizzamento. - Seguire attentamente i reindirizzamenti: eseguire la stessa richiesta con il tracciamento dei reindirizzamenti abilitato e verificare se atterra una sola volta sul portale o se entra in un loop.
- Ispezionare gli header: se i dispositivi di filtraggio dei contenuti aggiungono banner, header di categoria o contenuti riscritti, il rilevamento può interrompersi anche quando il portale è attivo.
Per le sonde di testo in stile Windows:
- Recupera il corpo esattamente come restituito
- Confronta l'output in testo normale
- Cerca sostituzioni o pagine wrapper
Per i controlli in stile Apple:
- Richiedere la pagina di successo prevista
- Confermare che il corpo della risposta corrisponda a ciò che il client si aspetta quando la rete è aperta
- Confermare che l'intercettazione sia intenzionale quando il client non è autenticato
Un rapido controllo di integrità con un HTTP header checker aiuta quando i proxy o i livelli di sicurezza modificano le risposte.
Usa un piccolo verificatore Python
Un breve script è sufficiente per automatizzare i controlli che il service desk ripete tutta la settimana. Mantienilo semplice:
- Definire gli URL di probe per le famiglie di client supportate.
- Inviare richieste HTTP escludendo il comportamento del browser.
- Registrare lo stato, l'URL finale, il numero di reindirizzamenti e un frammento del corpo della risposta.
- Confrontare i risultati con i valori previsti per una rete aperta.
- Segnalare esiti ambigui come un codice
200con contenuto imprevisto o reindirizzamenti ripetuti.
Questo script non deve autenticare gli utenti. Il suo compito è rispondere a una sola domanda: la rete ha presentato la sonda in modo tale da innescare la decisione attesa del client?
Gli agenti di dispositivo richiedono moderazione
I test sui dispositivi gestiti sono l'ambito in cui i team possono causare danni collaterali. Se si inviano test con script aggressivi a laptop che eseguono già client VPN, protezione DNS o agenti zero-trust, si rischia di attivare proprio lo stato di onboarding che si sta cercando di evitare.
Utilizza agenti leggeri con sistemi di protezione:
- Eseguire i probe in caso di eventi di associazione, non in modo continuo.
- Evitare ampie modifiche al firewall lato endpoint.
- Separare i test di onboarding guest dall'applicazione della VPN di produzione ove possibile.
- Registrare i verdetti localmente prima, quindi esportare i riepiloghi.
Consiglio operativo: Esegui i test come se fossi un client, non un utente malintenzionato. L'obiettivo è confermare le decisioni del sistema operativo, non forzare ogni percorso di reindirizzamento.
Cosa cercare nei risultati
I buoni test dicono molto di più di un semplice "attivo" o "inattivo".
- Risposta aperta corretta: il probe restituisce il codice o il marcatore previsto.
- Risposta captive prevista: il client non autenticato riceve un reindirizzamento al portale una sola volta.
- Looping: la stessa richiesta rimbalza ripetutamente.
- Risultato filtrato: la risposta esiste ma il contenuto è modificato.
- Percorso interrotto: timeout o endpoint non raggiungibile.
Se si riescono a raccogliere questi risultati da un laptop sulla VLAN guest e da un endpoint aziendale gestito, di solito si individua dove risiede il problema prima che il primo screenshot dell'utente arrivi nella casella di posta.
Integrazione del rilevamento con le piattaforme WiFi aziendali e di identità
Nel Wi-Fi aziendale, il rilevamento del Captive Portal non dovrebbe essere il centro del design. Dovrebbe essere un livello di compatibilità controllato.
Questo è il cambiamento su cui molte infrastrutture stanno ancora lavorando. L'accesso per gli ospiti, l'onboarding dei collaboratori esterni e il WiFi pubblico potrebbero avere ancora bisogno della logica del portale. L'accesso del personale e degli utenti noti di solito non dovrebbe dipendere da questo, se possibile evitarlo.
Colloca la gestione delle sonde nel posto corretto
Sia che utilizziate Meraki, Aruba, Ruckus, Mist o UniFi, si applica la stessa regola di progettazione. Gestite i probe non autenticati in modo prevedibile a livello di controller, gateway o edge cloud dove risiede già la vostra policy per gli ospiti.
Ciò significa:
- Consenti i corretti percorsi di pre-autorizzazione: endpoint di probe, risorse del portale e qualsiasi reindirizzamento dell'identità che deve caricarsi prima del pieno accesso.
- Mantieni limitata la policy non autenticata: sufficiente per l'onboarding, non per l'accesso generico a internet.
- Separa la logica degli ospiti da quella del personale: non lasciare che l'intercettazione del portale influisca sugli SSID aziendali gestiti o basati su certificati.
Se stai sostituendo l'accesso basato su password con flussi di lavoro di identità, il networking basato sull'identità è il modello di riferimento. Sposta l'accesso degli utenti noti dai flussi captive a una connettività autenticata e guidata dalle policy.
La registrazione dei log è importante nel Regno Unito
Nel contesto del settore pubblico e delle imprese del Regno Unito, lo standard di sicurezza wireless SS-019 richiede la registrazione delle autenticazioni ai Captive Portal degli ospiti, l'analisi dei tentativi falliti di accesso al portale, la registrazione delle modifiche di configurazione con l'identità dell'operatore e l'impostazione di soglie di monitoraggio del traffico in modo che l'attività dannosa possa essere attribuita a singole credenziali. Segnala inoltre anomalie come un numero insolitamente elevato di dispositivi su un singolo access point, un traffico anormalmente elevato da un singolo client e molti tentativi di connessione falliti in un breve periodo (UK wireless security standard SS-019).
Questo cambia il modo in cui implementerei il rilevamento. Non limitarti a registrare "portale raggiunto". Registra la catena:
- Associazione e identità del client
- Verdetto di Captive Portal attivato dal probe
- Successo o fallimento del portale
- Modifica della policy dopo l'autenticazione
- Telemetria che collega l'evento al comportamento dell'access point e del client
Evitare conflitti tra client zero-trust e il portale
I progetti scadenti falliscono qui. Alcuni strumenti di sicurezza per endpoint gestiscono gli stati dei captive portal come eccezioni e allentano temporaneamente i controlli. Se la rete causa falsi rilevamenti di captive portal, questi client possono oscillare continuamente tra la logica di onboarding e la normale applicazione delle regole.
Un modello più sicuro è:
- I dispositivi noti utilizzano prima l'autenticazione enterprise
- I dispositivi guest e sconosciuti seguono un percorso di onboarding limitato
- Il rilevamento del Captive Portal rimane disponibile come fallback
- I team VPN e zero-trust convalidano il comportamento su build client rappresentative prima del rilascio
Un'opzione di piattaforma in questo ambito è Purple, che supporta l'onboarding del WiFi per gli ospiti e i modelli di accesso basati sull'identità su hardware di rete di terze parti. Questo è utile quando si ha bisogno del supporto del portale per gli ospiti ma si desidera ridurre la dipendenza dai portali per gli utenti abituali o gestiti.
Test, risoluzione dei problemi e monitoraggio per mantenere affidabile il rilevamento
Il rilevamento del Captive Portal si interrompe. Ecco perché un test di accettazione una tantum non è sufficiente.
Il presupposto che vorrei contestare è questo: se la pagina del portale si carica durante la messa in servizio, il lavoro è finito. Non è così. Il funzionamento affidabile dipende dal mantenimento intatto del flusso di lavoro del probe tra aggiornamenti del sistema operativo, modifiche del filtraggio, integrazioni dell'identità e modifiche della sicurezza degli endpoint.
Una procedura di verifica pratica
Usa una breve checklist ogni volta che intervieni su accesso guest, criteri DNS, filtraggio o comportamento del controller:
- Validazione dell'endpoint dei probe: conferma che ogni famiglia principale di client riceva il tipo di risposta che si aspetta.
- Integrità del reindirizzamento: verifica la presenza di reindirizzamenti a salto singolo anziché di loop.
- Ispezione dei filtri: assicurati che i filtri web o i livelli proxy non stiano riscrivendo il contenuto del corpo o gli intestazioni.
- Comportamento del DNS: conferma che i client non autenticati risolvano solo ciò di cui hanno bisogno per l'onboarding e nient'altro.
- Ripristino post-autenticazione: verifica che i client rivalutino correttamente la connettività dopo l'autenticazione.
- Controlli a campione multipiattaforma: esegui test su Windows, macOS, iOS e Android con dispositivi rappresentativi gestiti e non gestiti.
Monitora i segnali corretti
Per le attività nel Regno Unito, l'affidabilità del rilevamento dovrebbe essere monitorata insieme alla telemetria di sicurezza, non separatamente. Lo standard SS-019 è utile in questo contesto perché spinge i team verso l'auditabilità e il monitoraggio delle anomalie, non solo verso il tracciamento degli accessi riusciti.
Presta attenzione a:
- Picchi di tentativi di connessione non riusciti
- Densità di client imprevista su un singolo AP
- Errori ripetuti del portale da parte della stessa classe di client
- Discrepanze tra l'associazione riuscita e le sessioni effettivamente utilizzabili per internet
- Cambiamenti repentini dopo gli aggiornamenti degli endpoint o dei browser
"Connesso" non è uno stato di successo significativo per il Wi-Fi guest. Lo è una connettività utilizzabile.
Quando mantenere il rilevamento e quando disattivarlo
Questa è la domanda strategica che molti team evitano. Alcune infrastrutture necessitano ancora di un Captive Portal per l'acquisizione dell'identità degli ospiti, l'accettazione dei termini o i flussi di lavoro di accesso pubblico. Va bene. Mantenetelo, ma gestite il rilevamento come un percorso di fallback accuratamente testato.
Per i visitatori abituali, il personale e gli utenti gestiti, la validità commerciale del passaggio a sistemi alternativi ai Captive Portal è sempre più forte. La copertura nel Regno Unito di OpenRoaming e Passpoint indica che questi approcci stanno "finalmente offrendo" un onboarding automatico e sicuro senza ripetuti accessi ai Captive Portal; un rapporto del settore britannico indica che il 38% degli intervistati ha già implementato una rete conforme a OpenRoaming o Passpoint, con il 32% che pianifica l'implementazione nel 2026 e il 18% nel 2027, come previsto nel medesimo report (copertura di Networking+ sulle tendenze del wireless nel Regno Unito).
Questo non significa che i portali spariranno domani. Significa che molte reti dovrebbero smettere di essere progettate considerando questi ultimi come il percorso utente principale. In un moderno contesto aziendale nel Regno Unito, il rilevamento del Captive Portal appartiene spesso alla stessa categoria di altre funzionalità di compatibilità legacy. Necessario in alcuni punti. Da ridurre al minimo in molti altri.
Se stai cercando di ridurre l'attrito del portale senza perdere il controllo, Purple offre l'autenticazione WiFi per gli ospiti, l'accesso basato sull'identità e il supporto per approcci come OpenRoaming e Passpoint che possono ridurre la dipendenza dal rilevamento del Captive Portal. Se questa è la direzione in cui si sta dirigendo il tuo parco macchine, vale la pena vedere come Purple si integra con il tuo stack di rete esistente e con le tue policy di onboarding.