Você se conecta a um SSID de visitantes, o laptop diz que está conectado, o telefone não abre nada, o Windows relata conectividade limitada e a equipe de helpdesk é culpada por um “portal quebrado”. Na maioria das vezes, a página do portal não é o primeiro problema. A detecção de Captive Portal é.
Essa distinção importa mais hoje do que há alguns anos. Em infraestruturas mistas do Reino Unido, o fluxo de trabalho de detecção afeta a experiência do usuário, o comportamento de segurança do endpoint, os registros de log e se as ferramentas de zero trust permanecem estáveis durante a integração. Se você tratar isso apenas como "aquilo que abre a tela de login", perderá as falhas que deixam os usuários desconectados.
O que a detecção de Captive Portal realmente faz
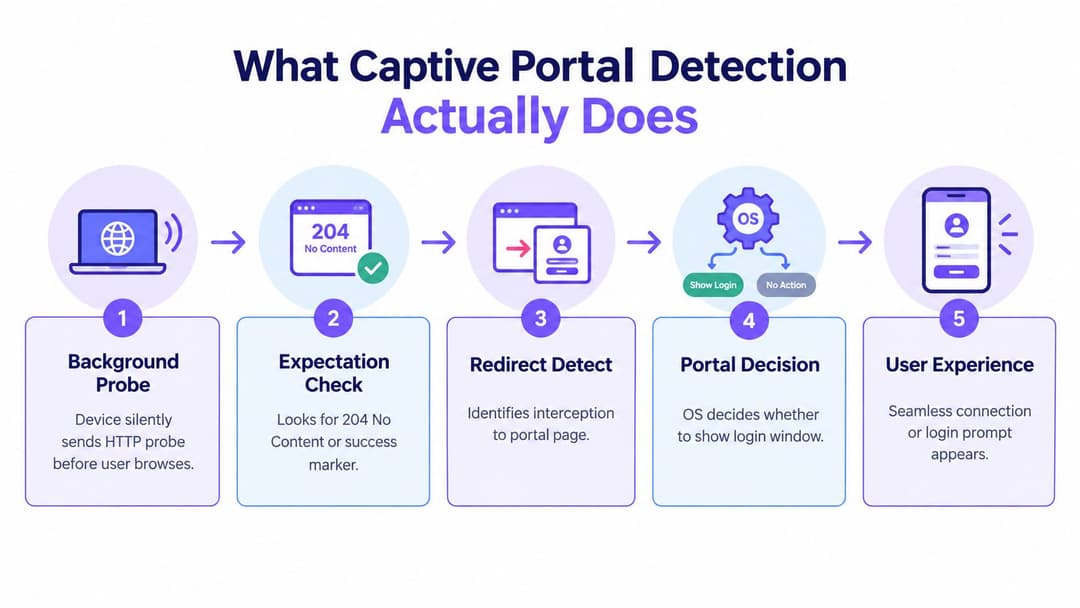
Um Captive Portal não começa com a página do portal. Começa com a decisão do cliente sobre se a rede tem acesso irrestrito à internet.
Quando um dispositivo se conecta ao WiFi, o sistema operacional geralmente envia uma solicitação HTTP em segundo plano para um endpoint controlado pelo fornecedor. Se a resposta corresponder ao que o cliente espera, o dispositivo assume que tem acesso livre à internet e permanece silencioso. Se a resposta for redirecionada, modificada ou bloqueada, o SO decide que provavelmente existe um portal e abre um fluxo de login.
A detecção é o portal, não o login
Esta é a parte que muitas equipes confundem:
- A Detecção decide se o usuário deve ver um portal.
- A Autenticação decide se o usuário tem permissão para passar.
- A Autorização decide o que esse usuário pode acessar depois.
Se a detecção falhar, o portal pode estar perfeitamente funcional e ninguém conseguirá visualizá-lo. Se a detecção funcionar mas a autenticação falhar, os usuários verão a página mas continuarão sem acesso. Esses são problemas distintos, com correções diferentes.
Um modelo mental útil é tratar a detecção do Captive Portal como um veredicto de conectividade orientado pelo sistema operacional. O navegador não está liderando. O sistema operacional está.
Por que isso importa em redes reais
Isso não é um caso isolado de nicho. Um estudo de hotspot descobriu que 484 redes atingiram o primeiro teste de detecção de Captive Portal, e 390 redes distintas estavam usando alguma forma de Captive Portal, mostrando que a detecção de portal já estava ativa em escala real de implantação, e não apenas em ambientes de laboratório (resumo do estudo).
Essa escala importa porque cada uma dessas redes dependia de os clientes interpretarem as respostas de teste corretamente. Na prática, isso significa que a experiência do usuário depende de uma troca muito pequena: um código de status, um corpo de resposta ou um redirecionamento.
Regra prática: se os usuários disserem "o portal não apareceu", inspecione o caminho de verificação antes de inspecionar a página do portal.
Por que o problema mudou
A solução de problemas de hotspots antigos se concentrava em fazer a splash page carregar. Isso ainda faz parte do trabalho, mas as infraestruturas modernas têm outra camada. Agentes de segurança, clientes VPN e ferramentas de onboarding também reagem quando detectam que um Captive Portal existe. A Mozilla documenta que o Firefox verifica endpoints de portal dedicados antes de abrir uma página de login, enquanto a Cloudflare observa que seu cliente pode enviar várias solicitações de portal específicas do sistema operacional e pode abrir totalmente o firewall do sistema até que o onboarding seja concluído, o que transforma a detecção em um problema de confiabilidade e segurança de endpoint, e não apenas em uma questão de login (Mozilla captive portal support article).
É por isso que equipes experientes agora fazem duas perguntas, não apenas uma. Primeiro, a rede consegue disparar o portal de forma consistente? Segundo, este ambiente ainda deve depender desse fluxo de trabalho como método de acesso principal?
Sondas centrais e heurísticas por trás de uma detecção confiável
Um cliente se conecta ao WiFi, obtém o DHCP, mostra um bom sinal e ainda assim relata "Sem Internet" ou nunca abre a janela de login. Em quase todos os casos, o problema está no caminho do teste, não na página do portal.
O que os clientes estão realmente verificando
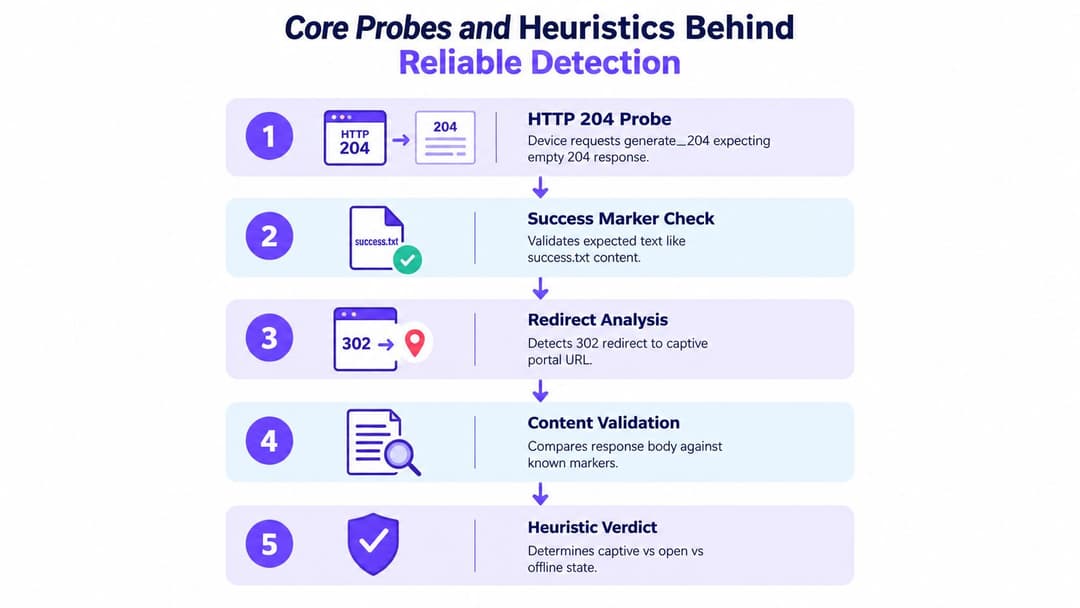
A detecção de Captive Portal é um pequeno mecanismo de decisão integrado ao SO ou ao agente cliente. O dispositivo envia uma solicitação conhecida para um endpoint conhecido, compara a resposta com o resultado esperado e decide se a rede está online, restrita por um portal ou com falha. O usuário pode ver apenas um navegador pop-up, mas o trabalho aconteceu alguns pacotes antes.
Os alvos comuns de sondagem incluem o captive.apple.com da Apple, o connectivitycheck.gstatic.com e o clients3.google.com/generate_204 do Google, o msftconnecttest.com/connecttest.txt da Microsoft e o detectportal.firefox.com do Firefox. O gatilho não é apenas o hostname. É a combinação de código de status, cabeçalhos, conteúdo do corpo, comportamento de redirecionamento e tempo, conforme observado na visão geral do portal de hotspot da DrayTek.
A lógica geralmente se parece com isso:
- O cliente envia um teste
- A rede permite a passagem ou faz a interceptação
- O cliente verifica a resposta em relação ao padrão esperado
- O cliente classifica o estado da rede
- O SO ou agente decide se deve iniciar o fluxo de Captive Portal, alertar o usuário ou permanecer silencioso
Essa última etapa importa mais do que muitas equipes esperam. Agentes de segurança, clientes VPN e ferramentas de integração frequentemente se baseiam no mesmo veredicto. Uma resposta de teste ruim pode interromper o acesso, atrasar verificações de postura ou deixar o endpoint em um estado estranho de meia conexão.
O que mais costuma quebrar a detecção
Os modos de falha comuns são tediosos, repetitivos e fáceis de passar despercebidos durante um teste rápido de navegador.
- Status HTTP incorreto: as verificações da família Android geralmente esperam
204 No Content. Retorne uma página personalizada com200 OKe o cliente poderá classificar a rede como de portal, quebrada ou instável. - Conteúdo do corpo incorreto: o Windows e outras pilhas de rede podem procurar marcadores exatos de texto simples. Banners de proxy, HTML reescrito ou recursos de injeção de conteúdo podem quebrar essa correspondência.
- Erros de redirecionamento: um redirecionamento claro para o portal funciona bem. Redirecionamentos em cadeia, loops ou redirecionamentos que alternam entre HTTP e HTTPS geralmente causam falhas silenciosas.
- Interferência de DNS: sequestro de DNS, DNS split-horizon ou resolvedores recursivos que respondem de forma inconsistente podem enviar investigações para um local que o cliente não esperava.
- Interceptação de TLS: a filtragem de HTTPS e a substituição de certificados frequentemente causam reclamações de "conectado, sem internet" porque o cliente deixa de confiar no resultado da investigação.
- Problemas de tempo e acessibilidade: DNS upstream lento, CDNs bloqueados para ativos do portal ou ausência de listas de permissão para provedores de identidade podem fazer com que a detecção oscile entre diferentes estados.
Uma verificação prática de implementação é criar primeiro a lista de permissões de pré-autenticação e testá-la separadamente. Ferramentas como o gerador de walled garden para domínios de Captive Portal e dependências da Purple ajudam a identificar hosts de teste, ativos do portal, redirecionamentos de identidade e destinos pós-autenticação que exigem tratamentos diferentes.
Falhas ambíguas aumentam a fila de chamados. Uma falha limpa é mais fácil de diagnosticar.
Por que as heurísticas são frágeis
Essas verificações são frágeis porque foram projetadas para inferir o estado da rede a partir de uma pequena troca, geralmente antes que o dispositivo tenha acesso total. Pequenas mudanças na filtragem de conteúdo, inspeção SSL, proxies reversos ou política de firewall podem alterar o resultado sem que ninguém toque no portal em si.
Vejo isso com mais frequência em SSIDs corporativos de convidados e de integração, onde várias equipes controlam partes diferentes do caminho. A equipe de rede sem fio vê a associação ser bem-sucedida. A equipe de firewall vê uma política de redirecionamento permitida. A equipe de segurança vê a inspeção HTTPS funcionando como planejado. O endpoint apenas vê uma resposta de sonda que não corresponde mais ao que ele solicitou.
É por isso que a detecção de Captive Portal deve ser tratada como um controle de confiabilidade e segurança de endpoint, e não apenas como um recurso de conveniência que exibe uma página de login. Se a detecção for não confiável, os usuários falham na integração, os agentes de segurança podem interpretar incorretamente a conectividade e as equipes de suporte acabam solucionando problemas na camada errada.
Isso também explica por que algumas infraestruturas devem parar de confiar em fluxos de trabalho captive como o método de acesso principal. Para acesso de convidados BYOD, visitantes de curta permanência e integrações legadas, a detecção de portal ainda tem o seu espaço. Para usuários gerenciados em grandes infraestruturas corporativas do Reino Unido, o Passpoint ou o OpenRoaming geralmente oferecem um resultado melhor, pois as decisões de acesso deixam de depender de heurísticas HTTP frágeis e passam para um acesso de rede autenticado desde o início.
Como deve ser um bom funcionamento
Uma implantação sólida possui algumas características consistentes:
- O tratamento de investigação é deliberado: cada grande família de clientes obtém o padrão de resposta esperado no estado de pré-autenticação.
- Os caminhos de pré-autenticação são rigidamente definidos: apenas os domínios de investigação necessários, componentes do portal, endpoints de identidade e caminhos de atualização permanecem acessíveis.
- Os controles de segurança reconhecem o tráfego de investigação: proxies, filtros e políticas de inspeção de TLS não reescrevem ou interceptam essas verificações por acidente.
- As mudanças de estado são rápidas após a autenticação: assim que o usuário tem o acesso liberado, o cliente pode verificar novamente a conectividade e limpar o veredicto do portal sem precisar desativar e reativar o WiFi.
- As equipes de operações podem testar no nível dos pacotes: elas conseguem prever o resultado do cliente a partir de rastreamentos de DNS, HTTP e redirecionamento, em vez de depender de um print de tela do navegador.
Se a equipe conseguir explicar por que um dispositivo marcou a rede como cativa, aberta ou com falha apenas com base na troca de dados brutos, o design de detecção geralmente está em boa forma.
Como os Principais Sistemas Operacionais Lidam com a Detecção de Forma Diferente
Segunda-feira de manhã, o SSID de convidados parece saudável. Os clientes se associam, obtêm DHCP e mostram um bom sinal. Em seguida, os chamados de suporte se dividem por tipo de dispositivo. Os iPhones se conectam, mas nunca mostram a página de login, os celulares Android declaram imediatamente que o login é necessário, e os notebooks Windows ficam em "Sem Internet" por tempo suficiente para que os usuários culpem o WiFi. É por isso que a detecção de portal pertence ao manual de confiabilidade, e não apenas ao design do acesso de convidados.
As diferenças são pequenas na teoria e caras na produção. Cada plataforma testa a conectividade de uma maneira própria, e cada uma reage mal a modos de falha ligeiramente diferentes. Em ambientes mistos, essas peculiaridades também se sobrepõem aos controles de endpoint, como filtragem web, inspeção TLS, agentes de VPN e verificações específicas do navegador. Um portal que apenas "funciona no navegador" não está funcionando corretamente.
Comparativo de expectativas de sondas de OS
| Família do Cliente | Endpoint de Teste (Probe) | Sinal de Sucesso Esperado |
|---|---|---|
| Apple | captive.apple.com |
Resposta HTTP contendo a página de sucesso esperada |
| Android e ecossistema Google | connectivitycheck.gstatic.com ou clients3.google.com/generate_204 |
204 No Content |
| Windows | msftconnecttest.com/connecttest.txt |
Texto simples do Microsoft Connect Test esperado |
| Firefox | detectportal.firefox.com |
Resposta de detecção de portal esperada usada pelo Firefox |
Apple frequentemente falha silenciosamente
A Apple geralmente oferece a experiência de usuário mais limpa quando o caminho de pré-autenticação está configurado corretamente. Quando está errado, a falha pode ser quase silenciosa. O dispositivo se conecta ao SSID, obtém um endereço e parece normal no controlador, mas o assistente do Captive Portal nunca abre.
Na prática, isso aponta para duas causas comuns. A primeira é a interceptação de testes que não corresponde ao que a Apple trata como cativo. A segunda é a modificação de conteúdo por um controle de segurança upstream. Uma página de bloqueio, injeção de cabeçalho ou política de tratamento de SSL pode alterar a resposta o suficiente para que o dispositivo não confie mais no resultado. As equipes de suporte acabam investigando RF ou DHCP quando o problema real é a integridade HTTP.
Android é mais fácil de testar e menos tolerante
O modelo 204 No Content do Android é direto. Isso ajuda durante o diagnóstico porque o comportamento esperado é claro, mas também significa que pequenos erros aparecem rapidamente. Se você retornar um redirecionamento, um corpo HTML ou uma resposta filtrada onde o Android não esperava nada, o cliente poderá marcar a rede como cativa ou instável.
Esse rigor é útil. Se o Android estiver instável no mesmo SSID em que a Apple funciona perfeitamente, comece analisando o comportamento do proxy, a filtragem de conteúdo e a lógica de redirecionamento antes de investigar a camada sem fio.
Windows expõe problemas de tempo e política
O Windows tende a expor ambiguidades de forma mais aberta do que a Apple. Os usuários enfrentam conectividade limitada, longos atrasos antes do portal aparecer ou uma conexão que parece estabelecida, mas que falha de maneiras estranhas no tráfego de aplicativos. Em infraestruturas corporativas, isso geralmente se cruza com ferramentas de segurança. Clientes de VPN sempre ativos, módulos de proteção web e firewalls de host podem influenciar as mesmas verificações que o Windows usa para o status de conectividade.
A Microsoft documenta o comportamento e os endpoints atuais do NCSI em suas próprias orientações, que são o ponto de referência correto para clientes Windows atuais. A lição operacional é mais simples. Se o NCSI estiver sendo interceptado, filtrado ou respondido muito lentamente, os usuários sentirão isso antes de entenderem.
Firefox pode divergir do sistema operacional host
O Firefox merece atenção especial em computadores porque executa sua própria lógica de portal. O notebook pode mostrar conectividade normal enquanto o Firefox ainda se comporta como se o acesso estivesse restrito, ou o inverso. Isso não é apenas uma peculiaridade do navegador. Isso gera chamados de suporte reais porque o sistema operacional, o navegador e o agente de endpoint podem ter visões diferentes da mesma rede.
Nota de campo: Quando os usuários relatarem "O WiFi está conectado, mas o Firefox está bloqueado," verifique o resultado do probe do SO, o resultado do probe do navegador e qualquer agente de secure web gateway no endpoint. Uma suposição errada nesta fase pode enviar o chamado para a equipe errada.
Ambientes mistos precisam de triagem focada no dispositivo
Use o sintoma para escolher o primeiro teste.
- iPhone se conecta, mas a tela de login não aparece: verifique o tratamento de testes da Apple e confirme se o corpo retornado está intacto.
- Android informa imediatamente que o login é necessário: confirme se o redirecionamento é intencional e se algum dispositivo está recebendo conteúdo em vez de
204. - Windows diz sem internet, portal aparece tarde: inspecione a acessibilidade do NCSI, o tempo de redirecionamento, a resposta do DNS e os agentes de segurança locais.
- Firefox se comporta de maneira diferente do Chrome no mesmo notebook: separe a detecção em nível de navegador do estado de conectividade do sistema operacional e da filtragem de endpoint.
É aqui também que a decisão de design faz a diferença. Para acesso de convidados, visitantes e BYOD, manter a detecção do portal funcionando bem ainda vale o esforço porque o fluxo de trabalho é esperado e a mistura de clientes é imprevisível. Para usuários gerenciados em grandes corporações no Reino Unido, problemas repetidos no portal geralmente são um sinal para reduzir a dependência da lógica cativa e migrar para Passpoint ou OpenRoaming, onde o controle de acesso ocorre na entrada da rede, em vez de testes HTTP frágeis pós-associação.
Detecção na prática com curl Python e agentes de dispositivos
A maneira mais rápida de parar de adivinhar é testar o caminho de verificação diretamente. Você não precisa de capturas de pacotes para todos os casos. Comece com verificações HTTP repetíveis e depois confirme o comportamento em dispositivos reais.
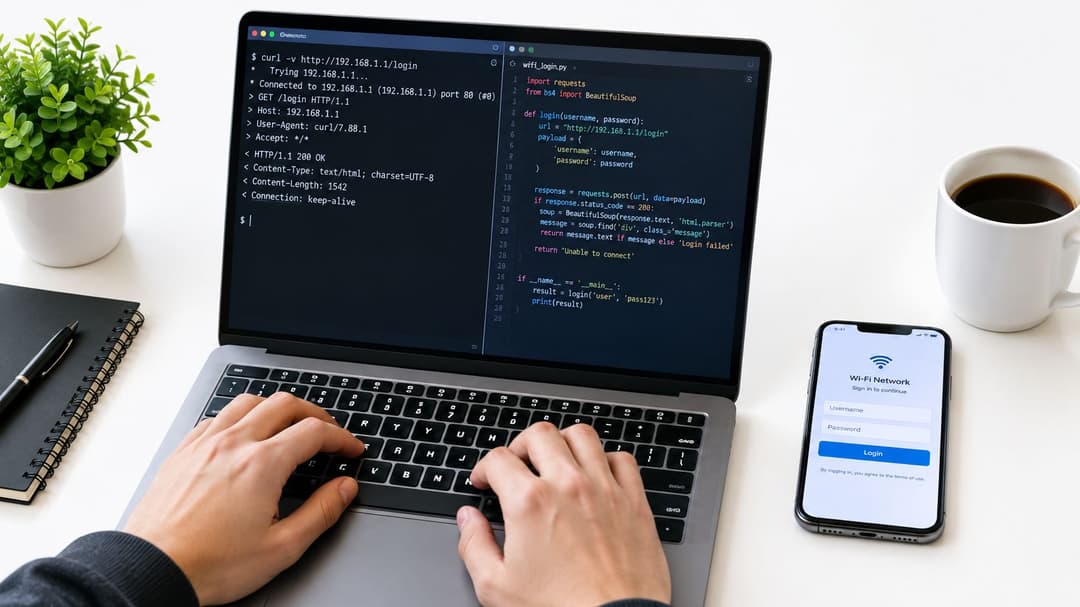
Comece com curl
Use curl para inspecionar códigos de status, cabeçalhos e redirecionamentos a partir do mesmo segmento de rede do cliente.
Para uma sonda no estilo Google:
- Verificar apenas o status: solicite o endpoint
generate_204e confirme se o resultado é204ou um redirecionamento. - Seguir redirecionamentos com cuidado: execute a mesma solicitação com o rastreamento de redirecionamento ativado e observe se ela chega uma vez ao portal ou entra em loop.
- Inspecionar cabeçalhos: se os dispositivos de filtragem de conteúdo adicionarem banners, cabeçalhos de categoria ou conteúdo reescrito, a detecção pode falhar mesmo quando o portal estiver ativo.
Para sondas de texto no estilo Windows:
- Busque o corpo exatamente como retornado
- Compare a saída de texto simples
- Procure por substituições ou páginas de wrapper
Para verificações no estilo Apple:
- Solicitar a página de sucesso esperada
- Confirmar se o corpo é o que o cliente espera quando a rede está aberta
- Confirmar se a interceptação é deliberada quando o cliente não está autenticado
Uma verificação rápida com um verificador de cabeçalho HTTP ajuda quando proxies ou camadas de segurança estão alterando as respostas.
Use um pequeno verificador em Python
Um script curto é suficiente para automatizar as verificações que seu suporte repete a semana toda. Mantenha as coisas simples:
- Defina as URLs de sondagem para as famílias de clientes que você suporta.
- Envie solicitações HTTP sem comportamento de navegador.
- Registre o status, a URL final, a contagem de redirecionamentos e o trecho do corpo da resposta.
- Compare os resultados com os valores esperados para redes abertas.
- Sinalize resultados ambíguos, como
200com conteúdo inesperado ou redirecionamentos repetidos.
Esse script não precisa autenticar os usuários. O trabalho dele é responder a uma pergunta: a rede apresentou a verificação de uma forma que disparasse a decisão esperada do cliente?
Agentes de dispositivos precisam de moderação
O teste de dispositivos gerenciados é onde as equipes podem criar danos colaterais. Se você aplicar testes com scripts agressivos em laptops que já executam clientes VPN, proteção de DNS ou agentes de zero-trust, poderá acionar o próprio estado de integração que está tentando evitar.
Use agentes leves com limites de segurança:
- Execute sondagens em eventos de associação, não continuamente.
- Evite alterações amplas de firewall no lado do endpoint.
- Separe os testes de integração de convidados da aplicação de VPN de produção sempre que possível.
- Registre as decisões localmente primeiro, depois exporte os resumos.
Conselho operacional: Teste como um cliente, não como um invasor. O objetivo é confirmar as decisões do sistema operacional, não forçar sistematicamente cada caminho de redirecionamento.
O que procurar nos resultados
Bons testes dizem mais do que apenas "ativo" ou "inativo".
- Resposta aberta correta: a sondagem retorna o código ou marcador esperado.
- Resposta captive esperada: o cliente não autenticado recebe um redirecionamento para o portal uma única vez.
- Looping: a mesma solicitação falha repetidamente.
- Resultado filtrado: a resposta existe, mas o conteúdo é modificado.
- Caminho morto: tempo limite esgotado ou endpoint inacessível.
Se você conseguir reunir esses resultados a partir de um laptop na VLAN de convidados e de um dispositivo corporativo gerenciado, geralmente encontrará onde está o problema antes que o primeiro print de tela do usuário chegue à sua caixa de entrada.
Integrando a Detecção com Redes WiFi Corporativas e Plataformas de Identidade
Em redes WiFi corporativas, a detecção de Captive Portal não deve ser o centro do design. Ela deve ser uma camada de compatibilidade controlada.
Essa é a mudança pela qual muitos ambientes ainda estão passando. O acesso de visitantes, a integração de prestadores de serviços e o WiFi voltado para o público ainda podem precisar da lógica do portal. O acesso de funcionários e usuários conhecidos geralmente não deve depender disso, se você puder evitar.
Coloque o tratamento de sondas no lugar certo
Quer você utilize Meraki, Aruba, Ruckus, Juniper Mist ou UniFi, a mesma regra de design se aplica. Trate testes não autenticados de forma previsível no controlador, gateway ou na borda da nuvem onde sua política de visitantes já reside.
Isso significa:
- Permita os caminhos corretos de pré-autenticação: endpoints de teste, ativos do portal e quaisquer redirecionamentos de identidade que precisem carregar antes do acesso total.
- Mantenha a política de não autenticados restrita: o suficiente para o onboarding, sem liberar a internet em geral.
- Separe a lógica de convidados e funcionários: não permita que a interceptação do portal afete SSIDs corporativos gerenciados ou baseados em certificados.
Se você está substituindo o acesso baseado em senha por fluxos de trabalho de identidade, a identity-based networking é o modelo relevante. Ela muda o acesso de usuários conhecidos de fluxos cativos para uma conectividade autenticada e orientada por políticas.
Registro de logs é importante no Reino Unido
No contexto corporativo e do setor público do Reino Unido, o padrão de segurança sem fio SS-019 exige que as autenticações de Captive Portal de convidados sejam registradas em log, que as tentativas falhas de portal sejam investigadas, que as alterações de configuração sejam registradas com a identidade do operador e que os limites de monitoramento de tráfego sejam definidos para que atividades maliciosas possam ser atribuídas a credenciais individuais. Ele também sinaliza anomalias, como contagens de dispositivos excepcionalmente altas em um único ponto de acesso, tráfego anormalmente alto de um único cliente e muitas tentativas falhas de conexão em um curto período (UK wireless security standard SS-019).
Isso muda a forma como eu implementaria a detecção. Não registre apenas "acesso ao portal". Registre a cadeia:
- Associação e identidade do cliente
- Decisão de portal retida por sonda
- Sucesso ou falha do portal
- Alteração de política pós-autenticação
- Telemetria que vincula o evento de volta ao comportamento do AP e do cliente
Evite que clientes de zero-trust entrem em conflito com o portal
Projetos ruins desmoronam aqui. Algumas ferramentas de segurança de endpoint tratam estados cativos como excepcionais e relaxam os controles temporariamente. Se a rede causar detecções falsas de portal cativo, esses clientes podem oscilar entre a lógica de integração e a aplicação normal.
Um padrão mais seguro é:
- Dispositivos conhecidos usam a autenticação corporativa primeiro
- Dispositivos de convidados e desconhecidos entram em um caminho de integração restrito
- A detecção de Captive Portal permanece disponível como alternativa
- As equipes de VPN e zero-trust validam o comportamento em compilações de clientes representativas antes da implantação
Uma opção de plataforma nesse espaço é a Purple, que oferece suporte a integração de WiFi de visitantes e padrões de acesso baseados em identidade em hardware de rede de terceiros. Isso é útil quando você precisa de suporte a portal para visitantes, mas deseja reduzir a dependência de portais para usuários recorrentes ou gerenciados.
Testes de Resolução de Problemas e Monitoramento que Mantêm a Detecção Confiável
A detecção de Captive Portal falha. É por isso que testes de aceitação pontuais não são suficientes.
A suposição que eu questionaria é esta: se a página do portal carrega durante o comissionamento, o trabalho está feito. Não está. A operação confiável depende de manter o fluxo de trabalho do probe intacto em atualizações de SO, mudanças de filtragem, integrações de identidade e alterações de segurança de endpoint.
Uma rotina prática de verificação
Use uma lista de verificação simples toda vez que alterar o acesso de convidados, política de DNS, filtragem ou comportamento do controlador:
- Validação de endpoint de investigação: confirme se cada grande família de clientes recebe o tipo de resposta esperado.
- Sanidade de redirecionamento: verifique se há redirecionamentos de salto único em vez de loops.
- Inspeção de filtragem: certifique-se de que as camadas de proxy ou filtros web não estejam reescrevendo o conteúdo do corpo ou os cabeçalhos.
- Comportamento do DNS: confirme se os clientes não autenticados resolvem apenas o necessário para a integração e nada mais.
- Recuperação pós-autenticação: verifique se os clientes reavaliam a conectividade de forma limpa após a autenticação.
- Verificações rápidas multiplataforma: teste no Windows, macOS, iOS e Android com dispositivos gerenciados e não gerenciados representativos.
Monitore os sinais corretos
Para operações no Reino Unido, a confiabilidade da detecção deve ser monitorada junto com a telemetria de segurança, e não de forma isolada. O SS-019 é útil aqui porque direciona as equipes para a auditabilidade e monitoramento de anomalias, e não apenas para o rastreamento de sucesso de login.
Eu acompanharia:
- Picos de tentativas de conexão malsucedidas
- Densidade inesperada de clientes em um único AP
- Falhas repetidas no portal vindas da mesma classe de cliente
- Incompatibilidades entre o sucesso da associação e sessões com acesso útil à internet
- Mudanças repentinas após atualizações de endpoints ou navegadores
"Conectado" não é um estado de sucesso significativo para WiFi de convidados. Conectividade utilizável é.
Quando manter a detecção e quando desativá-la
Esta é a questão estratégica que muitas equipes evitam. Alguns ambientes ainda precisam de um Captive Portal para captura de identidade de visitantes, aceitação de termos ou fluxos de trabalho de acesso público. Tudo bem. Mantenha-o, mas trate a detecção como um caminho de fallback testado com cuidado.
Para visitantes recorrentes, funcionários e usuários gerenciados, o caso de negócios para abandonar os portais cativos está se tornando cada vez mais forte. A cobertura de OpenRoaming e Passpoint no Reino Unido afirma que essas abordagens estão "finalmente entregando" uma integração automática e segura, sem a necessidade de logins repetidos no Captive Portal. Além disso, um relatório do setor no Reino Unido aponta que 38% dos entrevistados já implantaram uma rede compatível com OpenRoaming ou Passpoint, com 32% planejando implantações em 2026 e 18% em 2027, conforme projetado no relatório (cobertura da Networking+ sobre a direção do wireless no Reino Unido).
Isso não significa que os portais desaparecerão amanhã. Significa que muitas redes devem parar de projetar em torno deles como a jornada principal do usuário. Em uma infraestrutura corporativa moderna, a detecção de Captive Portal geralmente pertence à mesma categoria de outros recursos de compatibilidade legados. Necessário em alguns lugares. Digno de ser minimizado em muitos outros.
Se você está tentando reduzir o atrito do portal sem perder o controle, a Purple oferece autenticação de WiFi para convidados, acesso baseado em identidade e suporte para abordagens como OpenRoaming e Passpoint que podem diminuir sua dependência da detecção de Captive Portal. Se essa é a direção que sua infraestrutura está tomando, vale a pena ver como a Purple se integra ao seu stack de rede existente e às suas políticas de integração.