
Alta Disponibilidade de Servidor RADIUS: Ativo-Ativo vs Ativo-Passivo
Um guia de referência técnica definitivo para gerentes de TI e arquitetos de rede que avaliam arquiteturas de alta disponibilidade de RADIUS. Ele contrasta implantações Ativo-Ativo e Ativo-Passivo, detalha os requisitos de replicação de banco de dados e explica como o Cloud RADIUS mitiga a latência de failover para locais corporativos.
Video overview
Ouça este guia
Ver transcrição do podcast
Parte da nossa série principal: Guia de Segurança de WiFi Corporativo →
RADIUS high availability architecture and failover calculator
Model failover latency, accounting state integrity, and administrative overhead across Active-Passive, Active-Active on-premises clusters, and Cloud RADIUS architectures.
Active directory and MDM deployments benefit from automated certificate authentication. Active-Active or Cloud RADIUS prevents Monday morning authentication storms when hundreds of devices re-authenticate simultaneously.
Traffic is distributed across operational nodes. If one node fails, the load balancer removes it immediately from the active pool.
Need to eliminate RADIUS single points of failure across enterprise venues?
Purple Cloud RADIUS delivers native Active-Active multi-region resilience, zero-touch certificate lifecycle management, and 99.99% SLA over encrypted RadSec. Speak with our network architecture team.

Resumo Executivo
Para redes corporativas, a autenticação é binária: ou funciona perfeitamente, ou as operações comerciais cessam totalmente. O RADIUS (Remote Authentication Dial-In User Service) serve como o guardião crítico para implantações de IEEE 802.1X, WPA3 corporativo e Guest WiFi em locais modernos. Ao contrário dos serviços de aplicativos que degradam de forma controlada sob carga, uma falha de RADIUS bloqueia imediatamente o acesso à rede de usuários, terminais de ponto de venda e dispositivos operacionais.
Este guia de referência técnica avalia os modelos de arquitetura para a implantação de infraestrutura RADIUS altamente disponível. Especificamente, ele contrasta as configurações tradicionais Ativo-Passivo com os clusters Ativo-Ativo modernos. Para gerentes de TI, arquitetos de rede e diretores de operações de locais que gerenciam ambientes de alta densidade, como Retail, Hospitality e estádios, compreender essas estratégias de failover, mecânicas de balanceamento de carga e requisitos de replicação de banco de dados é essencial.
Além disso, este guia examina como as plataformas Cloud RADIUS abstraem a complexidade da alta disponibilidade, fornecendo failover automático e escalabilidade elástica sem o ônus operacional de manter infraestrutura local redundante. Ao aplicar essas melhores práticas independentes de fornecedor, as equipes de engenharia podem projetar arquiteturas de autenticação que eliminam pontos únicos de falha e atendem a rigorosos Acordos de Nível de Serviço (SLAs) de tempo de atividade.
Detalhamento Técnico: Entendendo a Arquitetura RADIUS
O RADIUS opera como um protocolo cliente-servidor sobre UDP, normalmente utilizando a porta 1812 para autenticação e a porta 1813 para contabilização, conforme definido nas RFC 2865 e RFC 2866. A natureza sem estado das solicitações de autenticação UDP é uma vantagem estrutural para projetos de alta disponibilidade. Como cada pacote Access-Request contém todas as credenciais e parâmetros necessários, qualquer servidor RADIUS dentro de um cluster pode processar qualquer solicitação de forma independente, sem exigir sincronização de estado complexa para a fase de autenticação em si.
Arquitetura Ativo-Passivo
Em uma implantação Ativo-Passivo (ou primário-reserva), um único servidor RADIUS processa todo o tráfego de autenticação e contabilização de entrada. Um servidor secundário permanece online, mas inativo, recebendo atualizações de replicação de banco de dados, mas não respondendo ativamente aos Dispositivos de Acesso à Rede (NADs), como pontos de acesso, switches ou gateways VPN.
Quando o servidor primário falha, o NAD detecta o tempo limite (timeout) e redireciona as solicitações subsequentes para o servidor secundário. O tempo de detecção de failover depende inteiramente dos temporizadores de configuração do NAD. Um NAD típico envia uma solicitação RADIUS e aguarda um tempo limite de pacote padrão (geralmente dois segundos). Se nenhuma resposta for recebida, ele tenta novamente. Com uma configuração padrão de três tentativas por servidor, o NAD pode aguardar até seis segundos antes de declarar o servidor primário inativo e realizar o failover para o secundário. Em ambientes com três servidores configurados, essa janela de failover pode se estender para dezoito segundos. Para um local de Hospitality movimentado ou um ambiente de Retail que processa transações, esse atraso representa uma interrupção perceptível no serviço.
Arquitetura Ativo-Ativo
Por outro lado, uma arquitetura Ativo-Ativo distribui a carga de autenticação entre vários servidores RADIUS operacionais simultaneamente. O tráfego é roteado para o cluster por meio de configuração round-robin nos NADs ou por meio de um balanceador de carga dedicado.
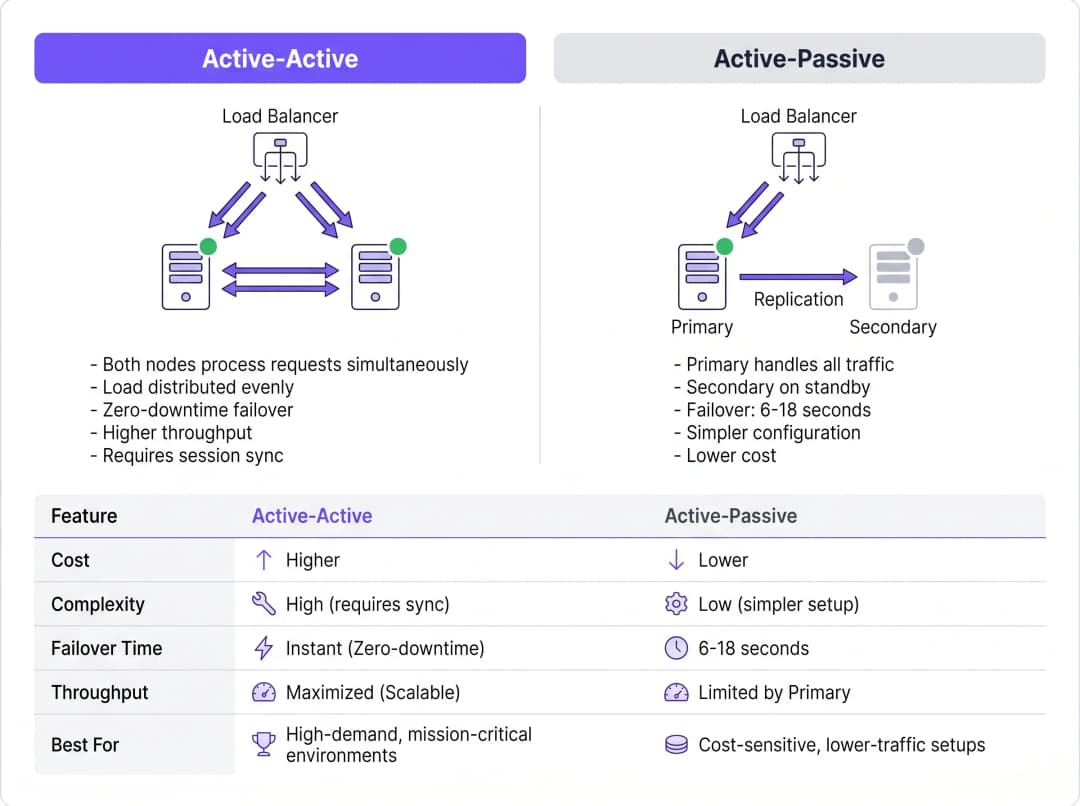
Este modelo elimina o atraso de detecção de failover inerente às configurações Ativo-Passivo. Se um nó falhar, o balanceador de carga (ou os NADs que usam round-robin) simplesmente deixa de rotear o tráfego para o servidor que não responde, normalmente dentro de um a dois segundos com base nos intervalos de verificação de integridade (health-checks). Os nós ativos restantes absorvem o tráfego instantaneamente. Além disso, os clusters Ativo-Ativo escalam horizontalmente; adicionar capacidade para eventos de alta densidade requer apenas o provisionamento de nós adicionais ao cluster.
O Desafio da Replicação de Banco de Dados
Embora a autenticação RADIUS seja stateless, o accounting RADIUS é inerentemente stateful. Ele rastreia o início da sessão (Start), o uso contínuo (Interim-Update) e o encerramento (Stop). Para locais que utilizam WiFi Analytics ou sistemas de faturamento, esses dados de accounting devem permanecer consistentes em todos os nós.
Fazer o backup de um cluster RADIUS com um banco de dados replicado (como MySQL ou MariaDB integrado ao FreeRADIUS) é obrigatório para uma alta disponibilidade robusta. Para implantações Ativo-Ativo, é necessária a replicação síncrona multi-master - como Galera Cluster ou MySQL NDB Cluster. A replicação síncrona garante que um registro de accounting seja gravado em todos os nós simultaneamente, evitando a perda de dados se um nó falhar. A replicação assíncrona tradicional, frequentemente usada em configurações Ativo-Passivo, introduz atraso de replicação. Se o nó primário falhar antes que o secundário receba a atualização, os dados da sessão ativa serão perdidos permanentemente, o que pode violar frameworks de conformidade como PCI-DSS.
Tem dúvidas sobre a sua configuração específica?
A nossa equipa trabalha com operadores de espaços, gestores de TI e engenheiros de rede em 80.000 locais. Agende uma chamada de 20 minutos e mostraremos como outros profissionais na sua situação o resolveram.
Guia de Implantação: Nuvem vs Local (On-Premise)
A decisão arquitetônica vai além de como agrupar servidores em cluster; envolve onde esses servidores residem. Para operadores com vários locais, o transporte de retorno do tráfego de autenticação para um data center local centralizado introduz latência de WAN e cria um ponto único de falha no link de WAN.
Plataformas Cloud RADIUS
Os serviços de Cloud RADIUS resolvem os desafios de distribuição geográfica hospedando a infraestrutura de autenticação em várias zonas de disponibilidade globais. Quando um usuário se conecta em uma filial, a solicitação é roteada para o nó de borda de nuvem mais próximo, minimizando a latência.
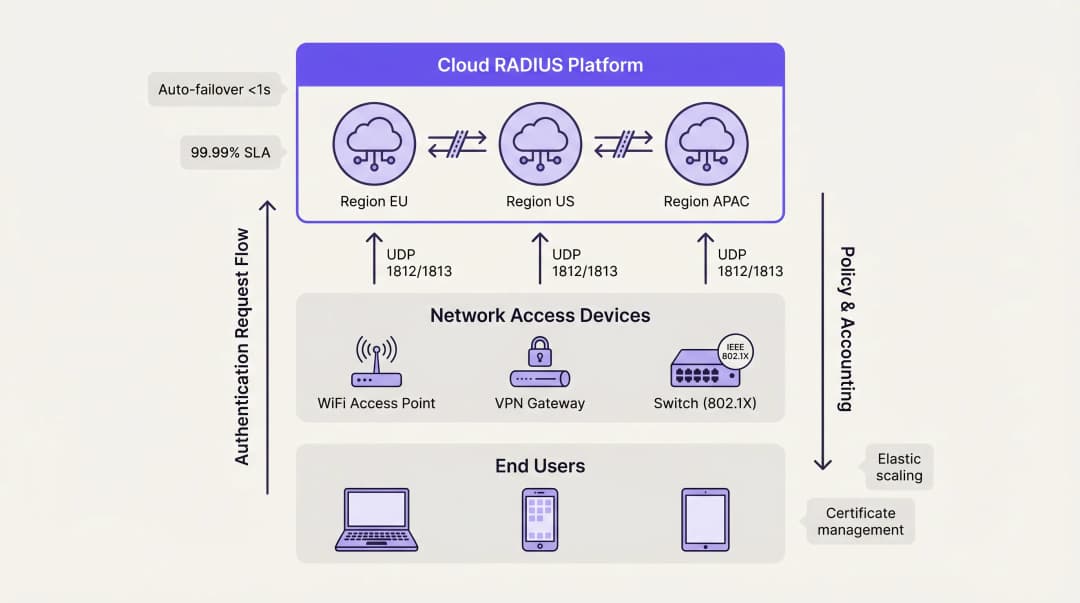
As plataformas em nuvem utilizam inerentemente arquiteturas Ativo-Ativo. O failover entre zonas de disponibilidade é gerenciado automaticamente pelo balanceamento de carga interno do provedor, abstraindo totalmente a complexidade para a equipe de engenharia do cliente. Esse modelo normalmente oferece SLAs de 99,99% de tempo de atividade e elimina a necessidade de gerenciamento manual de certificados, aplicação de patches no sistema operacional e ajuste de replicação de banco de dados. Para organizações que implantam Wayfinding ou Sensors em campi distribuídos, a autenticação hospedada na nuvem garante a aplicação consistente de políticas sem dependências de hardware localizadas.
Considerações de Implantação Local (On-Premise)
Organizações que operam em setores altamente regulamentados - como ambientes específicos de Healthcare ou governamentais - podem exigir implantações locais devido a mandatos rígidos de soberania de dados. Nesses cenários, implantar um cluster FreeRADIUS Ativo-Ativo com replicação síncrona Galera oferece o mais alto nível de resiliência. No entanto, as equipes de engenharia devem considerar a sobrecarga operacional. O gerenciamento de certificados TLS em vários nós, a garantia de consistência de configuração e o monitoramento ativo da integridade da replicação do banco de dados exigem recursos administrativos dedicados. Os balanceadores de carga de hardware devem ser configurados especificamente para suportar o tráfego UDP com verificações de integridade de RADIUS apropriadas, pois muitos balanceadores de carga padrão são otimizados exclusivamente para o tráfego TCP HTTP/HTTPS.
Melhores Práticas para Alta Disponibilidade de RADIUS
- Distribuir em Vez de Duplicar: Para implantações que excedam 500 usuários simultâneos, priorize arquiteturas Ativo-Ativo em vez de configurações Ativo-Passivo para maximizar a capacidade de processamento e minimizar a latência de failover.
- Implementar Replicação Síncrona: Proteja os dados de contabilização stateful utilizando replicação síncrona de banco de dados multi-master (por exemplo, Galera Cluster) em vez de modelos primário-réplica assíncronos.
- Padronizar a Confiança do Certificado: Em um cluster Ativo-Ativo, certifique-se de que todos os nós apresentem o certificado de servidor idêntico ou certificados da exata mesma cadeia de Autoridade Certificadora (CA). As divergências farão com que os handshakes EAP-TLS e PEAP falhem durante a rotação de nós.
- Ajustar os Temporizadores NAD: Otimize os temporizadores de nova tentativa e tempo limite de RADIUS em seus Dispositivos de Acesso à Rede. Um tempo limite de dois segundos com duas novas tentativas oferece um equilíbrio entre a detecção rápida de failover e a prevenção de failovers prematuros durante pequenos congestionamentos de rede.
- Testar Cenários de Falha: Trate os nós secundários como sistemas de produção. Simule regularmente falhas de nós, dessincronização de banco de dados e quedas de link WAN para validar se os mecanismos de failover automatizados funcionam conforme projetado.
Resolução de Problemas e Mitigação de Riscos
O modo de falha mais comum na alta disponibilidade de RADIUS é o desvio de configuração. Em configurações Ativo-Passivo, os administradores frequentemente atualizam políticas ou renovam certificados no nó primário, mas negligenciam o secundário. Quando ocorre um evento de failover, o nó secundário rejeita o tráfego legítimo devido a credenciais expiradas ou políticas desatualizadas.
Para mitigar esse risco, implemente ferramentas de gerenciamento de configuração (como Ansible ou Terraform) para implantar alterações de forma simétrica em todos os nós. Para o gerenciamento de certificados, utilize protocolos de renovação automatizados (como ACME) configurados para distribuir o certificado atualizado para todo o cluster simultaneamente.
Outro risco significativo é a configuração incorreta do balanceador de carga. Se um balanceador de carga não realizar verificações de integridade na camada de aplicação (verificando especificamente a capacidade de resposta da porta UDP 1812), ele poderá continuar roteando o tráfego para um nó onde o sistema operacional está em execução, mas o daemon RADIUS travou. Certifique-se de que as verificações de integridade validem explicitamente a disponibilidade do serviço RADIUS.
ROI e Impacto nos Negócios
O retorno sobre o investimento para uma alta disponibilidade robusta de RADIUS é medido principalmente por meio da mitigação de riscos e da eficiência operacional. Interrupções de autenticação resultam em perdas imediatas de produtividade para os funcionários e graves danos à reputação de locais voltados ao público.
Ao fazer a transição de implantações manuais em servidor único para arquiteturas automatizadas Ativo-Ativo (particularmente via Cloud RADIUS), as organizações recuperam horas significativas de engenharia anteriormente dedicadas à manutenção de rotina. Essa eficiência operacional permite que as equipes de rede se concentrem em iniciativas estratégicas - como implantar The Core SD WAN Benefits for Modern Businesses ou otimizar a cobertura de alta densidade - em vez de combater falhas de autenticação. Em última análise, uma autenticação confiável é a camada fundamental da qual todos os serviços de rede subsequentes dependem.
Definições principais
Arquitetura Ativo-Ativo
Um design de alta disponibilidade onde múltiplos servidores RADIUS processam solicitações de autenticação simultaneamente, distribuindo a carga e fornecendo failover instantâneo sem atrasos de detecção.
Essencial para locais de alta densidade (estádios, grandes varejos) onde um único servidor não consegue lidar com picos de autenticação.
Arquitetura Ativo-Passivo
Um modelo de redundância onde um servidor primário lida com todo o tráfego e um servidor secundário permanece ocioso em espera até que o primário falhe.
Adequado para implantações menores e sensíveis a custos, mas introduz um atraso de failover de 6 a 18 segundos enquanto o dispositivo de acesso à rede detecta a falha.
Replicação Síncrona
Um método de replicação de banco de dados onde os dados são gravados em todos os nós de um cluster simultaneamente antes que a transação seja considerada concluída.
Obrigatório para bancos de dados de tarifação RADIUS Ativo-Ativo (como Galera Cluster) para evitar perda de dados e garantir a conformidade.
Replicação Assíncrona
Um método de replicação de banco de dados onde o nó primário registra os dados e depois os copia para os nós secundários, introduzindo um leve atraso (atraso de replicação).
Frequentemente usado em configurações Ativo-Passivo, mas corre o risco de perder registros de bilhetagem recentes se o nó primário falhar abruptamente.
Network Access Device (NAD)
O componente de hardware (como um ponto de acesso WiFi, switch ou gateway VPN) que solicita autenticação do servidor RADIUS em nome do usuário.
Os temporizadores internos de tentativa e limite de tempo (timeout) do NAD ditam a rapidez com que ocorre um failover Ativo-Passivo.
Stateless Protocol
Um protocolo de comunicação que trata cada solicitação como uma transação independente, não relacionada a nenhuma solicitação anterior.
A autenticação RADIUS sobre UDP é stateless, permitindo que os balanceadores de carga encaminhem qualquer solicitação para qualquer servidor ativo de forma contínua.
Desvio de Configuração
O fenômeno no qual os servidores secundários ou de backup ficam fora de sincronia com o servidor primário em relação a políticas, atualizações ou certificados ao longo do tempo.
A principal causa de falhas em implantações RADIUS Ativo-Passivo quando o nó secundário é forçado a assumir o controle.
Cloud RADIUS
Um serviço de autenticação gerenciado hospedado em uma infraestrutura em nuvem distribuída globalmente, fornecendo redundância integrada Ativo-Ativo e dimensionamento automático.
Substitui a necessidade de as equipes de TI compilarem, aplicarem patches e monitorarem manualmente servidores RADIUS locais redundantes.
Exemplos práticos
Um grupo hoteleiro europeu administra 45 propriedades em seis países. Atualmente, eles executam máquinas virtuais FreeRADIUS independentes em cada propriedade. Um certificado TLS expirado recentemente em um dos locais causou uma interrupção completa do WiFi para convidados durante uma grande conferência. Como eles devem redesenhar sua arquitetura de autenticação para evitar interrupções localizadas e reduzir os custos de manutenção?
O grupo hoteleiro deve migrar de instâncias locais de nó único do FreeRADIUS para uma plataforma centralizada de Cloud RADIUS utilizando uma arquitetura Ativo-Ativo. Ao aproveitar um provedor de nuvem com nós de borda distribuídos geograficamente, as solicitações de autenticação de cada propriedade são roteadas para o nó regional mais próximo, minimizando a latência. O gerenciamento centralizado de políticas permite que a equipe de TI defina regras de autenticação uma vez e as aplique globalmente. O provedor de nuvem lida automaticamente com a rotação de certificados TLS, aplicação de patches no sistema operacional e replicação de banco de dados.
Um estádio de futebol nacional está se preparando para um evento com 60.000 participantes. Sua configuração atual de RADIUS é Ativo-Passivo. Durante os testes de carga, o servidor primário ficou saturado processando 8.000 solicitações de autenticação por minuto quando os portões abriram, causando graves atrasos na conexão, enquanto o servidor secundário permaneceu completamente ocioso. Como eles podem otimizar essa implantação?
A equipe de engenharia de rede deve converter a implantação de Ativo-Passivo para Ativo-Ativo. Primeiro, eles devem reconfigurar os Dispositivos de Acesso à Rede (NADs) do estádio para utilizar o balanceamento de carga round-robin entre ambos os servidores RADIUS, duplicando instantaneamente a capacidade de autenticação. Segundo, eles devem provisionar um terceiro nó RADIUS para fornecer a margem de segurança necessária para picos de pico. Finalmente, para garantir que os dados de tarifação permaneçam consistentes em todos os três nós ativos, eles devem implementar uma solução de replicação de banco de dados multi-master síncrona, como o Galera Cluster.
Questões práticas
Q1. Seu cliente corporativo do setor varejista exige uma solução RADIUS de alta disponibilidade para seus terminais de ponto de venda. Eles possuem requisitos rígidos de conformidade PCI DSS que ditam que absolutamente nenhum dado de sessão de bilhetagem pode ser perdido durante um failover de servidor. Qual estratégia de replicação de banco de dados você deve implementar para o backend RADIUS?
Dica: Considere a diferença entre dados sendo gravados simultaneamente versus dados sendo copiados após o ocorrido.
Ver resposta modelo
Você deve implementar a Replicação Síncrona (como um Galera Cluster ou MySQL NDB Cluster). A replicação síncrona garante que o registro de bilhetagem seja gravado em todos os nós simultaneamente antes de confirmar a transação. Se você usasse replicação Assíncrona, uma falha no nó poderia resultar na perda de transações recentes que ainda não haviam sido copiadas para o banco de dados secundário, violando o rigoroso requisito de conformidade.
Q2. A rede de um campus universitário utiliza uma configuração RADIUS Ativo-Passivo. Os estudantes reclamam que, quando o servidor primário passa por manutenção, leva quase 20 segundos para que seus laptops se conectem ao WiFi. Os pontos de acesso estão configurados com um timeout do RADIUS de 3 segundos e 5 tentativas. Como você pode reduzir o atraso do failover sem alterar a arquitetura do servidor?
Dica: Calcule o tempo máximo de espera com base nos temporizadores do NAD antes que ele tente o servidor secundário.
Ver resposta modelo
Você deve ajustar os temporizadores nos Network Access Devices (pontos de acesso). Atualmente, o AP aguarda 3 segundos e realiza 5 tentativas, resultando em um atraso de 18 segundos (3 segundos × 6 tentativas no total) antes de fazer o failover para o servidor passivo. Ao reduzir a configuração para um timeout de 2 segundos e 2 tentativas, o tempo de detecção de failover cai para 6 segundos, melhorando significativamente a experiência do usuário durante as janelas de manutenção.
Q3. Você está migrando uma rede corporativa de várias unidades de um servidor RADIUS local Ativo-Passivo para uma plataforma Cloud RADIUS Ativo-Ativo. Durante a fase piloto, os dispositivos se autenticam com sucesso no Cloud Node A, mas quando o balanceador de carga os direciona para o Cloud Node B, os handshakes EAP-TLS falham. Qual é o erro de configuração mais provável?
Dica: Considere o que o dispositivo cliente verifica ao estabelecer um túnel EAP seguro com um novo servidor.
Ver resposta modelo
O problema mais provável é uma divergência na Confiança do Certificado (Certificate Trust). Em um cluster Ativo-Ativo, todos os nós RADIUS devem apresentar exatamente o mesmo certificado de servidor (ou certificados emitidos exatamente pela mesma cadeia de CA confiável). Se o Cloud Node B estiver apresentando um certificado diferente no qual os dispositivos clientes não confiam, o handshake EAP-TLS será rejeitado pelo cliente, fazendo com que a autenticação falhe, apesar de o servidor estar funcionando corretamente.
Continue a ler esta série
Solução de problemas de 802.1X no iOS e macOS: um checklist de implantação para Intune, Jamf e Microsoft Entra ID
Use este checklist para diagnosticar por que iPhones, iPads e Macs falham no 802.1X no Intune ou Jamf Pro. Cada falha corresponde a uma de quatro causas: confiança do servidor, certificado de identidade, modo macOS ou escopo de grupo do Microsoft Entra ID. Você confirmará a causa a partir dos logs do eapolclient e RADIUS, aplicará a correção e organizará as futuras rotações de certificados.
Confiança do servidor de perfil WiFi do Intune: nomes de servidor de certificado e checklist de CA raiz para Entra ID
Você será capaz de configurar a validação de servidor de um perfil WiFi do Intune para que o EAP-TLS e o PEAP se conectem no Windows, Apple e Android. Você fará a correspondência dos nomes de servidor de certificado com o certificado RADIUS, implantará a CA raiz correta, alinhará as atribuições de grupo do Entra ID e programará as renovações de certificado antes que elas interrompam as conexões silenciosamente.
Solução de problemas de Android 802.1X e EAP-TLS: uma checklist de implantação para Intune e Microsoft Entra ID
Você será capaz de identificar por que telefones Android gerenciados falham no EAP-TLS no seu SSID de funcionários e corrigir isso no Intune. Associe cada sintoma a uma das quatro causas comuns - CA ou domínio ausente, certificado de cliente no perfil incorreto, valor incompatível de nomes de servidor RADIUS ou uma raiz confiável não entregue. Em seguida, aplique uma checklist de implantação que evita interrupções repetidas.
Tem dúvidas sobre a sua configuração específica?
A nossa equipa trabalha com operadores de espaços, gestores de TI e engenheiros de rede em 80.000 locais. Agende uma chamada de 20 minutos e mostraremos como outros profissionais na sua situação o resolveram.