Ein Hotel verliert während des Check-ins den Internetzugang. Gäste können sich nicht am WiFi authentifizieren, Kartenterminals melden Timeouts, Mitarbeiter verlieren den Zugriff auf Cloud-Systeme und die Rezeption beginnt, ein gemeinsames Passwort herauszugeben, das niemand widerrufen kann. Die Backup-Leitung existiert zwar, aber die Firewall-Richtlinie wurde nie getestet. Der zweite RADIUS-Server ist konfiguriert, aber niemand weiß, ob die Access Points ihn erreichen. Die USV meldet einen fehlerfreien Zustand, weil niemand die Batterie unter Last getestet hat.
Das ist kein Hardwareproblem. Es ist ein Fehler bei der Redundanzplanung.
Netzwerkresilienz bedeutet, dass Authentifizierung, Konnektivität und wichtige Dienste verfügbar bleiben, wenn eine Komponente, eine Verbindung, ein Standort, die Stromversorgung oder eine Identitätsabhängigkeit ausfällt. Ein Ersatz-Switch im Schrank sorgt nicht für Resilienz. Ein getesteter Pfad, der ein Zahlungs-VLAN, eine klinische Anwendung, den Mitarbeiter-Login oder eine Gäste-WiFi-Sitzung aufrechterhält, tut dies hingegen schon.
Was Redundancy Planning für moderne Netzwerke tatsächlich bedeutet
Die Planung der Netzwerkredundanz ist eine Disziplin der Business Continuity und kein reiner Hardware-Einkauf. Die Frage ist nicht, ob Sie zwei Switches besitzen. Sie lautet, ob sich Benutzer nach einem definierten Ausfall weiterhin verbinden, authentifizieren, Dienste auflösen und die Anwendungen erreichen können, die den Betrieb am Laufen halten.
Das erfordert eine klare Sicht auf Ausfalldomänen. Eine Ausfalldomäne ist eine Komponente oder Abhängigkeit, die unabhängig ausfallen und einen Dienst mit sich reißen kann. Typische Domänen sind:
- Zugriffsinfrastruktur, einschließlich Switches, Access Points, PoE-Budgets, Uplinks und Wireless-Controllern.
- Identitätsdienste, einschließlich RADIUS, Verzeichnisintegrationen, Zertifikaten, Captive Portals und Identitätsanbietern.
- Kerndienste, einschließlich DHCP, DNS, Gateway-Funktionen und Netzwerkrichtlinien.
- Externe Pfade, einschließlich WAN-Leitungen, ISP-Geräten, Cloud-Plattformen und Authentifizierungsdiensten von Drittanbietern.
- Einrichtungen, einschließlich Stromverteilung, USV-Batterien, Generatorabdeckung und Räumen für Zwischenverteiler.
Ein Design kann über ausfallsichere Core-Router verfügen und dennoch am Edge scheitern. Wenn die DNS-Auflösung stoppt, sind die Benutzer zwar möglicherweise mit dem WiFi verbunden, können aber die benötigten Dienste nicht erreichen. Wenn RADIUS nicht mehr reagiert, kann ein ansonsten einwandfreies drahtloses Netzwerk jede Anmeldung von Mitarbeitern oder Gästen ablehnen. Wenn das Captive Portal von einem nicht erreichbaren Cloud-Pfad abhängt, verfügt der Standort zwar über Funkabdeckung, aber über keinen nutzbaren Gastzugang.
Separate service continuity from component redundancy
Beginnen Sie mit Diensten, nicht mit Geräten. Schreiben Sie die Dienste auf, die das Unternehmen schützen muss, und verfolgen Sie dann jede Abhängigkeit darunter. Die Authentifizierung im Gäste-WiFi kann beispielsweise von Access Points, Switching, PoE, der Wireless Control Plane, DHCP, DNS, WAN-Zugang, RADIUS, dem Identity Provider und dem Portal selbst abhängen.
Eine nützliche Planungsreferenz für das Netzwerkteam WiFi sollte zum selben Schluss führen: Der drahtlose Zugriff ist ein operatives System, kein Radiolayer, der einfach an das LAN angehängt wurde.
Arbeitgeber im Vereinigten Königreich nutzen eine andere gesetzliche Definition für kollektive Redundanzplanung (Massenentlassungen). Wenn ein Arbeitgeber beabsichtigt, 20 oder mehr Mitarbeiter an einem Standort innerhalb eines rollierenden Zeitraums von 90 Tagen zu entlassen, greift die kollektive Konsultationspflicht. Die Konsultation muss mindestens 30 Tage vor der ersten Entlassung bei 20 bis 99 Entlassungen oder 45 Tage vor der ersten Entlassung bei 100 oder mehr Entlassungen beginnen. Der Leitfaden der Regierung des Vereinigten Königreichs zur Konsultation erklärt, dass die Konsultation die Gründe für die vorgeschlagenen Entlassungen, Wege zu ihrer Vermeidung und Möglichkeiten zur Reduzierung der Anzahl der Entlassungen behandeln muss. Dies ist ein HR-Planungsrahmen. Die hier beschriebene Netzwerkdisziplin befasst sich mit Serviceausfällen, der Zuordnung von Abhängigkeiten und der Wiederherstellungsarchitektur.
Praktische Regel: Zählen Sie keine Backup-Geräte. Zählen Sie unabhängige Pfade vom Benutzer zum Dienst.
Der Rest dieses Leitfadens nutzt diese praktische Perspektive. Identifizieren Sie die Ausfallrisiken, legen Sie Wiederherstellungsziele fest, die den geschäftlichen Schaden widerspiegeln, wählen Sie eine Architektur, die Ihr Team bedienen kann, schützen Sie jede Ebene von der Stromversorgung bis zur Identität und testen Sie das Ergebnis unter kontrollierten Bedingungen. Wenn eine Komponente bei einer Übung noch nie ausgefallen ist, betrachten Sie ihre Redundanz als Annahme, nicht als bewiesene Fähigkeit.
Kartierung von Ausfallrisiken vor dem Entwurf der Lösung
Die meisten Netzwerkteams benötigen keine Governance-Plattform, um ihre gefährlichsten Single Points of Failure zu finden. Sie benötigen ein kurzes Register, das das Risiko benennt, es konsistent einstuft, einen Verantwortlichen zuweist und festhält, ob jemand es minimiert hat.
Nutzen Sie drei Achsen:
- Wahrscheinlichkeit, d. h. wie oft der Ausfall in vergleichbaren Umgebungen oder in Ihrer eigenen Umgebung aufgetreten ist.
- Explosionsradius (Blast Radius), d. h. wie viele Benutzer, Standorte, Dienste oder umsatzgenerierende Aktivitäten nicht mehr verfügbar sind.
- Wiederherstellungsaufwand, d. h. wie schwierig die Wiederherstellung mit den heute vorhandenen Fähigkeiten, Zugriffsrechten, Ersatzteilen, dem Support der Anbieter und der Dokumentation ist.
Bewerten Sie jede Achse auf einer lokalen Skala und multiplizieren Sie dann die drei Werte oder wenden Sie eine gewichtete Formel an. Die mathematische Genauigkeit ist weniger wichtig als die Konsistenz. Eine einzelne WAN-Leitung sollte höher eingestuft werden als ein isoliertes Marketing-Display, da ihr Ausfall alle abhängigen Dienste auf einmal beeinträchtigen kann.
Build the register around real dependencies
Beziehen Sie Assets ein, die von Teams oft übersehen werden. Ein nützlicher erster Durchgang sollte Folgendes enthalten:
- Ein einzelner WAN-ISP oder eine Leitung, die den gesamten Standort versorgt.
- Ein einzelner RADIUS-Service oder eine einzelne Identity-Provider-Integration.
- Ein einzelner DNS-Resolver-Pfad.
- Ein einzelner Wireless-Controller oder eine Abhängigkeit vom Cloud-Management.
- Ein Etagenverteiler-Raum (IDF) ohne Generatorabdeckung.
- USV-Batterien, die zwar ihren Status melden, aber nie unter nennenswerter Last getestet wurden.
- Ein Captive Portal ohne dokumentierten Ausfallmodus (Degraded Mode).
- Ein Switch-Stack, dessen Uplinks sich eine einzige physische Route teilen.
- Ein DHCP-Dienst ohne getestetes Wiederherstellungsverfahren.
Das Register sollte auch den Service-Verantwortlichen, den technischen Eigentümer, das Datum des letzten Ausfalls, die aktuelle Schadensbegrenzung, das Testdatum und die nächste Maßnahme erfassen. "Netzwerkteam" ist kein Eigentümer. Nennen Sie die Person oder das Team, das dafür verantwortlich ist, die Änderung zu veranlassen und nachzuweisen, dass sie funktioniert.
Sample network risk register scoring
Das Folgende ist eine Arbeitsvorlage, kein Anspruch auf eine bestimmte Infrastruktur. Verwenden Sie für jede Achse eine einheitliche lokale Skala und berechnen Sie das Endergebnis für jeden Eintrag auf dieselbe Weise.
| Ausfallszenario | Wahrscheinlichkeit (1-5) | Auswirkung/Blast Radius (1-5) | Wiederherstellungsaufwand (1-5) | Risiko-Score |
|---|---|---|---|---|
| Einzelner WAN-Schaltkreis | Lokal bewerten | Lokal bewerten | Lokal bewerten | Wahrscheinlichkeit × Blast Radius × Wiederherstellungsaufwand |
| Einzelner RADIUS-Dienst | Lokal bewerten | Lokal bewerten | Lokal bewerten | Wahrscheinlichkeit × Blast Radius × Wiederherstellungsaufwand |
| Einzelner DNS-Resolver-Pfad | Lokal bewerten | Lokal bewerten | Lokal bewerten | Wahrscheinlichkeit × Blast Radius × Wiederherstellungsaufwand |
| Einzelner Wireless Controller | Lokal bewerten | Lokal bewerten | Lokal bewerten | Wahrscheinlichkeit × Blast Radius × Wiederherstellungsaufwand |
| IDF-Verteilerraum ohne Generator | Lokal bewerten | Lokal bewerten | Lokal bewerten | Wahrscheinlichkeit × Blast Radius × Wiederherstellungsaufwand |
| Unüberwachte USV-Batterien | Lokal bewerten | Lokal bewerten | Lokal bewerten | Wahrscheinlichkeit × Blast Radius × Wiederherstellungsaufwand |
Warten Sie nicht auf ein perfektes Register. Eine einseitige Liste mit glaubwürdigen Verantwortlichen ist nützlicher als ein ausgefeiltes Risikosystem, das niemand aktualisiert. Das unmittelbare Ziel ist die Priorisierung. Ordnen Sie die Ausfälle, die kritische Dienste lahmlegen können, nach ihrer Priorität und nutzen Sie diese Ergebnisse, um Wiederherstellungsziele festzulegen und die Architektur auszuwählen.
Offizielle britische Management-Informationen zeigen, warum eine strukturierte Vorabplanung in einem anderen, aber verwandten Arbeitskräftekontext wichtig ist. Arbeitgeber reichten 368 HR1-Formulare ein, die 29.496 potenzielle Entlassungen im Januar 2020 abdeckten, und 326 Formulare für 27.804 potenzielle Entlassungen im Februar 2020, wie aus den Meldungsdaten der Regierung zu betriebsbedingten Kündigungen hervorgeht. Die Lektion für Netzwerkverantwortliche ist einfach: Formelle Planung existiert, weil große betriebliche Veränderungen improvisiert nur schwer zu bewältigen sind. Das Gleiche gilt, wenn ein standortübergreifendes Netzwerk eine gemeinsame Abhängigkeit verliert.
Festlegung von RTO- und RPO-Zielen, die dem tatsächlichen geschäftlichen Schmerzpunkt entsprechen
RTO und RPO sind nur dann nützlich, wenn die Geschäftsinhaber sie auch verstehen können.
Das Recovery Time Objective (RTO) ist die maximal akzeptable Zeit, die ein Dienst nicht verfügbar sein darf. Das Recovery Point Objective (RPO) ist der maximal akzeptable Verlust von Daten, Konfigurationen oder Sitzungsstatus seit dem letzten wiederherstellbaren Zeitpunkt. Bei einem Netzwerk kann sich das RPO eher auf die Konfiguration, Richtlinien, den Gerätestatus, Ereignisprotokolle oder den aktiven Authentifizierungskontext beziehen als auf eine traditionelle Datenbanktransaktion.
Übersetzen Sie beide Kennzahlen in betriebliche Konsequenzen. Fragen Sie sich, was als Erstes stoppt, wenn der Service ausfällt. Müssen Gäste an der Rezeption warten? Können Kassen keine Zahlungen mehr annehmen? Verlieren Ärzte den Zugriff auf elektronische Patientenakten? Verliert ein Immobilienverwalter die Zutrittskontrolle für Mieter? Der Service-Verantwortliche sollte die geschäftlichen Auswirkungen benennen und nicht nur ein IT-Ziel wiederholen.
Use service tiers rather than one estate-wide promise
Eine praxisnahe Service-Übersicht trennt geschäftskritische Zugänge von Diensten, die warten können.
| Service-Stufe | Beispiel-Services | Ziel-RTO | Ziel-RPO | Auswirkung auf die Architektur |
|---|---|---|---|---|
| Stufe 1 | Gast WiFi Authentifizierung, Zahlungs-VLAN, Zugriff auf klinische Anwendungen | Minuten, basierend auf der Geschäftstoleranz | Minimaler Verlust von Richtlinien- und Authentifizierungsstatus | Unabhängige Pfade, schnelles Failover, resiliente Identität, geprüfte Stromversorgung |
| Stufe 2 | Mitarbeiter WiFi, Back-Office-Systeme, Synchronisierung von Analysen | Etwa eine Stunde, sofern der Betrieb dies zulässt | Aktuelle Konfiguration und Servicestatus | Warm-Standby, duale Pfade wo gerechtfertigt, dokumentierte Wiederherstellung |
| Stufe 3 | Gastunterhaltung, Marketing-Splash-Pages, unkritische Berichterstattung | Mehrere Stunden können akzeptabel sein | Backup-basierte Wiederherstellung kann ausreichend sein | Kostengünstigerer Standby oder manuelle Wiederherstellung |
Dies sind Planungsbeispiele und keine universellen Service-Levels. Die Finanzabteilung sollte das Ziel anhand eines einfachen Verlustmodells validieren: geschätzter stündlicher Umsatzbeitrag, betriebliche Beeinträchtigung, Reputationsrisiko und Compliance-Auswirkungen, geteilt durch die Ausfallzeit, die das Unternehmen akzeptieren kann. Vermeiden Sie Scheingenauigkeit. Für einen Zahlungsdienst gibt es unter Umständen keine sinnvolle "durchschnittliche Stunde", da ein kurzer Ausfall während eines geschäftigen Handelsfensters mehr Schaden anrichten kann als ein längerer Ausfall in der Nacht.
Die RTO muss auch Erkennungs- und Entscheidungszeiten umfassen. Ein Failover, das schnell abgeschlossen ist, nachdem ein Techniker den Fehler bemerkt hat, kann das geschäftliche Ziel dennoch verfehlen, wenn das Monitoring zu lange braucht, um einen Alarm auszulösen. Berücksichtigen Sie DNS-Propagierungsverhalten, Sitzungs-Reauthentifizierung, Geräte-Wiederverbindung, Firewall-Konvergenz und menschliche Eskalation in der Wiederherstellungsschätzung.
Die RPO verdient die gleiche Aufmerksamkeit. Wenn eine Konfigurationsänderung, die kurz vor dem Ausfall vorgenommen wurde, verloren geht, kann das Team sie dann wiederherstellen? Ist es akzeptabel, wenn sich Gäste-Sitzungen neu authentifizieren müssen? Wenn ein Identitätsverzeichnis vorübergehend nicht verfügbar ist, kann die Zugriffsebene eine bewährte Richtlinie nutzen, ohne die Sicherheit zu schwächen?
Aggressive RTO-Ziele erfordern in der Regel aktiv-aktive oder geografisch unabhängige Kapazitäten. Eine großzügigere RTO kann ein Warm-Standby, eine dokumentierte Wiederherstellung oder eine Backup-basierte Wiederherstellung unterstützen. Kopieren Sie kein Enterprise-Service-Level aus einem Vertrag, wenn der Standort immer noch von einem einzigen ISP, einer einzigen Stromversorgung oder einem einzigen Identitätspfad abhängt. Die Architektur muss sich das Ziel erst verdienen.
Die Wahl der richtigen Failover-Architektur für Ihre Infrastruktur
Vier Muster decken die meisten realen Standort-Bereitstellungen ab. Keines ist automatisch richtig. Die richtige Wahl hängt von der Ausfalltoleranz, der Größe der Infrastruktur, den operativen Fähigkeiten, der Unabhängigkeit von Fehlern und dem Budget ab.
Bei Active-Active leiten zwei oder mehr leistungsfähige Komponenten gleichzeitig den Datenverkehr weiter. Duale Controller oder Access-Cluster können die Last teilen, und eine Seite kann den Betrieb fortsetzen, wenn die andere ausfällt. Dies bietet eine hohe Kapazität im Fehlerfall, führt jedoch zu mehr Zustandssynchronisierung, Richtlinienkonsistenz und dem Risiko eines Split-Brain-Szenarios. Nutzen Sie dies, wenn Ausfallzeiten teuer sind und das Team in der Lage ist, beide Seiten ordnungsgemäß zu überwachen.
Active-Passive hält eine Standby-Komponente bereit, um im Bedarfsfall zu übernehmen. Dies ist einfacher zu handhaben als ein Active-Active-Szenario, aber die Übernahme, die Zustandsübertragung und die Erkennung können zu einer Wiederherstellungslücke führen. Ein Hot-Standby ist nur dann wertvoll, wenn er über eine aktuelle Konfiguration, erreichbare Abhängigkeiten und einen getesteten Übernahmeprozess verfügt.
N+1 bietet eine zusätzliche Reservekapazität für ein Cluster. Das ist eine sinnvolle Lösung, wenn ein Standort den Austausch einer Komponente tolerieren kann, aber keine vollständig duplizierte Umgebung rechtfertigt. N+1 setzt die Infrastruktur dennoch gemeinsamen Fehlern aus - wie einer gemeinsamen Stromversorgung, einem gemeinsamen Uplink oder einer fehlerhaften Konfiguration, die auf alle Einheiten repliziert wird.
Geografische Redundanz platziert eine vollständige Servicekapazität an einem anderen Standort oder in einer anderen Region. Sie fängt den Verlust eines Standorts auf, nicht nur den Ausfall von Geräten, und bringt den höchsten Investitions- und Betriebsaufwand mit sich. Sie eignet sich für gemeinsam genutzte Dienste, die mehrere Standorte unterstützen, oder für Organisationen, für die ein einzelnes Gebäude als Ausfalldomäne inakzeptabel ist.
Failover architecture comparison
| Architektur | Kosten | Komplexität | Typische RTO | Beste Eignung |
|---|---|---|---|---|
| Aktiv-Aktiv | Hoch | Hoch | Sehr kurz bei korrektem Betrieb | Kritische Services, größere Standorte, Teams, die synchronisierte Systeme verwalten können |
| Aktiv-Passiv | Mittel bis hoch | Mittel | Kurz bis moderat, je nach Aktivierung | Standorte, die einen einsatzbereiten Standby benötigen, ohne Datenverkehr auf beiden Seiten abzuwickeln |
| N+1 | Mittel | Mittel | Moderat, je nach Austausch und Bereitstellung | Cluster, bei denen eine Komponente einen ausgefallenen Peer abdecken kann |
| Geografische Redundanz | Am höchsten | Am höchsten | Kurz bis verlängert, je nach Routing und Status | Multi-Site-Betreiber und Services, die einem Komplettausfall eines Standorts ausgesetzt sind |
Eine Hotelgruppe mit zwei Standorten kann Active-Active-Dienste zwischen den Standorten nutzen, wenn WAN, Identität, DNS, Stromversorgung und betriebliche Verantwortung wirklich unabhängig sind. Ein einzelnes Ladengeschäft profitiert in der Regel mehr von einer resilienten Firewall, segmentiertem Traffic und einem LTE- oder 5G-Backup als von einem redundanten Rechenzentrumsdesign, das es nicht betreiben kann.
Nutzen Sie eine direkte Entscheidungshilfe. Wenn die personellen Ressourcen begrenzt sind und das Unternehmen eine messbare Wiederherstellungszeit tolerieren kann, wählen Sie Aktiv-Passiv oder N+1. Wenn kritische Transaktionen Kontinuität erfordern und das Team die Synchronisation bewältigen kann, wählen Sie Aktiv-Aktiv. Wenn eine gesamte Niederlassung das Hauptrisiko darstellt, ist geografische Redundanz die Antwort. Wenn das Budget knapp ist, eliminieren Sie Abhängigkeiten auf einzelnen Pfaden in der Reihenfolge ihrer geschäftlichen Auswirkungen, anstatt ein Duplikat des am besten sichtbaren Geräts zu kaufen.
Entwurf resilienter Netzwerk-, Authentifizierungs- und Identitätsschichten
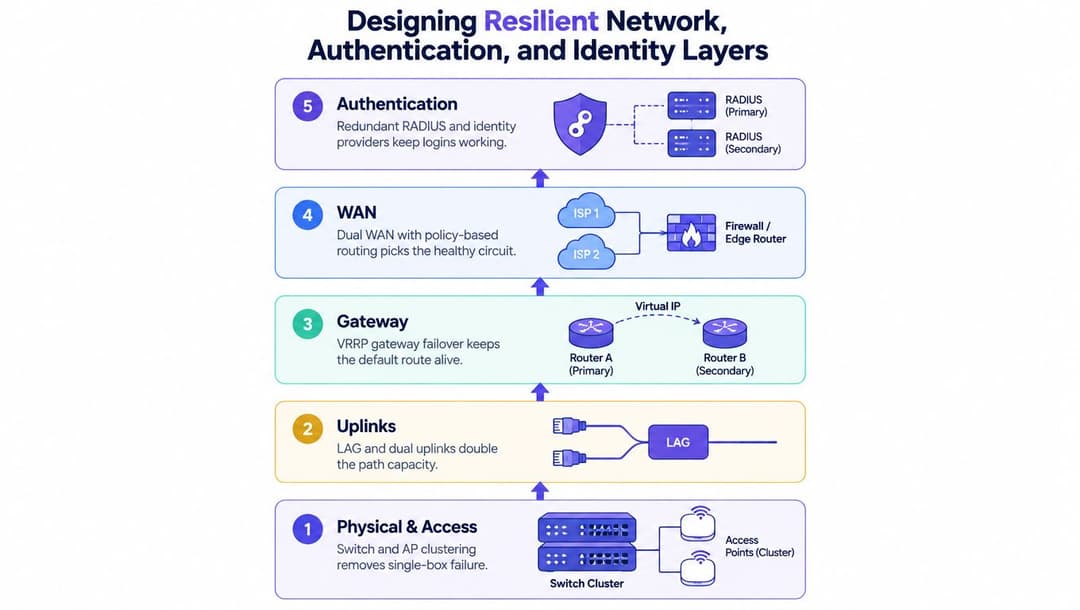
Resilienz scheitert an der schwächsten Abhängigkeit. Bauen Sie den Stack von der physischen Schicht nach oben auf und weisen Sie jeder Schicht eine unabhängige Ausfalldomäne zu.
Start with access and uplinks
Nutzen Sie Switch- und Access-Point-Clustering, wo es die Infrastruktur erfordert, aber stellen Sie sicher, dass Cluster-Mitglieder keine gemeinsame Ausfalldomäne teilen. Zwei Switches im selben Rack können immer noch von einer einzigen Stromversorgung abhängen. Zwei Uplinks können immer noch derselben Kabeltrasse folgen. Link-Aggregation kann Kapazität und Pfadredundanz bieten, während duale Uplinks die Abhängigkeit von einem einzelnen Port, Modul oder Kabel verringern.
Verwenden Sie am Gateway VRRP oder einen gleichwertigen virtuellen Gateway-Mechanismus, damit sich die Standardroute zwischen Geräten verschieben kann. Testen Sie das Stateful Firewall Failover, anstatt davon auszugehen, dass ein Floating Gateway aktive Sitzungen aufrechterhält. Einige Dienste stellen die Verbindung sauber wieder her. Andere erfordern eine explizite Sitzungsbehandlung.
WAN-Resilienz sollte separate Leitungen mit richtlinienbasiertem Routing kombinieren, das den Zustand und nicht nur den Verbindungsstatus erkennt. Eine Leitung kann elektrisch aktiv bleiben, während der Pfad zu den entscheidenden Anwendungen unterbrochen ist. LTE oder 5G bietet einen nützlichen Out-of-Band-Zugriff für die Verwaltung und einen Ausweichpfad, benötigt jedoch eine eigene Abdeckung, Stromversorgung, Datenrichtlinie und Sicherheitskontrollen.
Treat DNS and power as production dependencies
DNS ist Teil der User Journey. Nutzen Sie ein gezieltes TTL-Management, sekundäre Auflösungsfunktionen und ein Split-Horizon-Design, wenn sich interne und externe Antworten unterscheiden müssen. Überwachen Sie die Auflösungszeit und -fehler, nicht nur, ob ein Resolver-Prozess antwortet.
Auch die Stromversorgung benötigt Redundanzebenen. Kombinieren Sie den USV-Schutz mit einem realistischen PoE-Budget, getrennten Zuleitungen, sofern das Gebäude dies unterstützt, und einer Generatorabdeckung für die Räume, in denen sich Netzwerkabhängigkeiten befinden. Eine USV mit einer defekten Batterie ist keine Ausfallsicherheit. Genauso wenig wie ein Generator, der den Access-Layer nicht erreicht.
Protect authentication as carefully as connectivity
RADIUS sollte über unabhängige Service-Instanzen und eine getestete Failover-Reihenfolge verfügen. Das Verhalten des Captive Portal erfordert einen definierten eingeschränkten Modus (Degraded Mode). Fragen Sie sich, ob ein bereits authentifizierter Benutzer fortfahren kann, ob ein neuer Benutzer den Prozess abschließen kann und was passiert, wenn der Identitätsanbieter nicht erreichbar ist.
Für den Mitarbeiterzugang kann ein Cloud-gesteuerter RADIUS-Service die Abhängigkeit von einem einzelnen On-Premises-Server verringern. Er erfordert jedoch weiterhin Multiregions-Verfügbarkeit, überwachte Endpunkte, aktuelle Zertifikate und eine klare Zuständigkeit für die Wiederherstellung. Der Microsoft Entra ID RADIUS-Service von Purple ist eine Option, um den Netzwerkzugriff mit der verzeichnisbasierten Identität zu verbinden und gleichzeitig die Authentifizierungsebene in die Resilienz-Strategie einzubeziehen.
Jede Ebene muss unabhängig voneinander ausfallen können. Wenn beide RADIUS-Knoten denselben virtuellen Host nutzen, beide DNS-Pfade denselben Resolver verwenden und beide WAN-Leitungen durch denselben Kabelschacht ins Gebäude führen, ist das Diagramm zwar redundant, die Infrastruktur ist es jedoch nicht.
Tests, Monitoring und Runbooks, die Ausfälle tatsächlich abfangen
Die Architektur auf dem Papier ist nicht die Architektur in der Produktion. Der einzige zuverlässige Weg, einen Failover-Pfad zu validieren, besteht darin, ihn unter kontrollierten Bedingungen zu testen, die User Experience zu beobachten und zu beheben, was fehlschlägt.
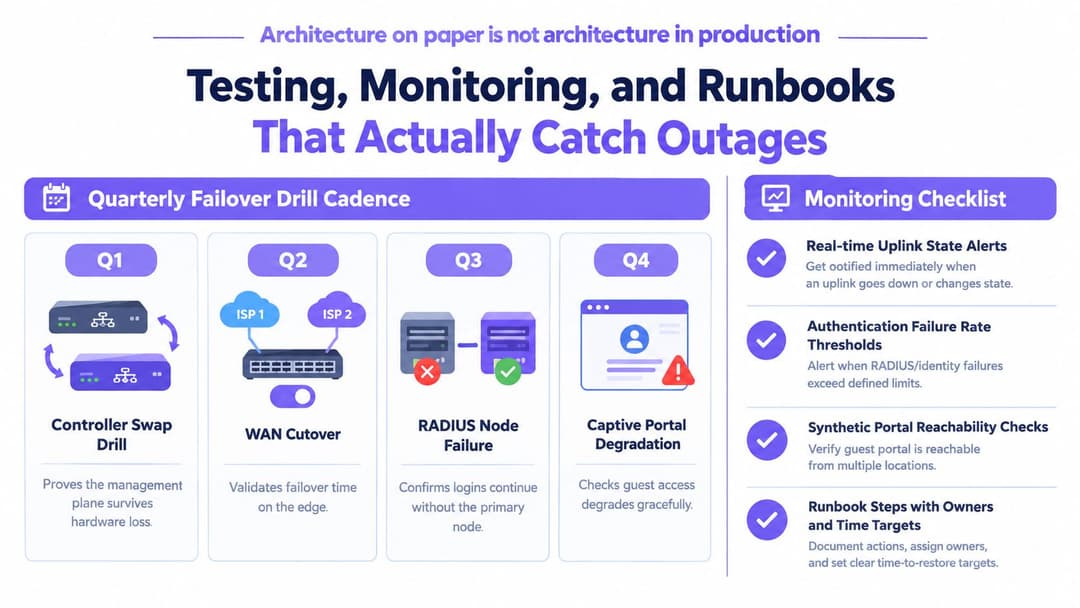
Führen Sie ein vierteljährliches Drill-Programm durch, bei dem in jedem Zyklus ein anderer Ausfallschwerpunkt im Mittelpunkt steht:
- Controller-Wechsel: Weisen Sie nach, dass das Management und der Wireless-Service fortgesetzt werden, nachdem der primäre Controller entfernt wurde.
- WAN-Umschaltung: Validieren Sie die Leitungserkennung, das Policy-Routing, den Firewall-Status und die Erreichbarkeit von Anwendungen.
- RADIUS-Knotenausfall: Bestätigen Sie, dass neue Anmeldungen und die Reauthentifizierung den sekundären Dienst nutzen.
- Ausfall des Captive Portals: Überprüfen Sie, ob der Gastzugang sicher ausfällt (Fail-Safe) und ob bestehende Benutzer die vorgesehene Benutzererfahrung erhalten.
Kontrolliertes Chaos ist besser als eine Trockenübung auf dem Papier. Trennen Sie in einer Nacht mit geringem Risiko einen Switch-Stack, deaktivieren Sie einen WAN-Pfad oder isolieren Sie einen RADIUS-Knoten mit einem genehmigten Change-Record. Halten Sie den Test in Grenzen, definieren Sie ein Rollback und lassen Sie den Service-Verantwortlichen das geschäftliche Ergebnis beobachten, anstatt nur auf das Monitoring-Dashboard zu schauen.
Monitor symptoms, not device vanity
Nützliche Signale sind unter anderem:
- Erreichbarkeit des Controllers und Cluster-Status.
- RADIUS Antwort-Latenz und Authentifizierungs-Fehlerrate.
- DNS Auflösungszeit und fehlgeschlagene Abfragen.
- Access Point Verbindungsstatus und Client-Reassoziation.
- Uplink-Auslastung, Fehler und Pfadänderungen.
- Synthetische Erreichbarkeit des Captive Portal.
- WAN Zustand basierend auf Anwendungs-Probes, nicht nur auf dem Schnittstellenstatus.
Legen Sie Alarmschwellenwerte basierend auf den Auswirkungen für Kunden fest. Ein geringfügiger Anstieg von Authentifizierungsfehlern kann auf einen Ausfall der Identitätsverwaltung hindeuten, noch bevor Benutzer den Helpdesk anrufen. Ein Uplink mit dauerhafter Vollauslastung kann ein Vorbote für ein beeinträchtigtes Failover sein. Alarmieren Sie Techniker nicht bei jedem vorübergehenden Ereignis. Alarmieren Sie sie, wenn sich mehrere Signale zu einem Service-Symptom summieren.
Ein Runbook sollte einen Entscheidungsbaum, namentlich genannte Eskalationsverantwortliche, die Reihenfolge der Anbieterkontakte, Zugriffsanforderungen, Rollback-Schritte und an die Service-RTO gebundene Zeitziele enthalten. Fügen Sie gegebenenfalls Screenshots oder genaue Konsolenpfade hinzu, aber verlassen Sie sich nicht auf implizites Wissen. Erfassen Sie nach jeder Übung die Erkennungszeit, die Entscheidungszeit, die Wiederherstellungszeit, die Auswirkungen auf die Benutzer und die erforderlichen Änderungen.
Der Purple WiFi Latenz- und Jitter-Test kann die praktische Validierung der Netzwerkqualität unterstützen, aber kein Test ersetzt eine echte Failover-Übung. Wenn Sie eine Abhängigkeit nicht absichtlich unterbrochen haben, haben Sie sie auch nicht validiert.
Branchenspezifische Überlegungen für das Gastgewerbe, den Einzelhandel, das Gesundheitswesen und Multi-Mandanten-WiFi
Dasselbe Resilienz-Konzept erfordert in unterschiedlichen Umgebungen unterschiedliche Prioritäten. Beginnen Sie mit der Einstufung der Services und wählen Sie dann die Identitäts- und Netzwerkkontrollen aus, die die wertvollste User Journey schützen.
| Branche | Tier-1-Dienste | Empfohlenes Failover-Verhalten | Zentrales Identitäts- und Netzwerk-Risiko |
|---|---|---|---|
| Hotellerie | Gäste-Authentifizierung, Zahlungszugriff, Gebäudesysteme, Mitarbeiter-Konnektivität | Dual-WAN, redundantes RADIUS, getestete Captive Portal Wiederherstellung, geschützte Stromversorgung | Eine geteilte Gäste-Anmeldung oder Portal-Abhängigkeit kann den Check-in und die Service-Bereitstellung stören |
| Einzelhandel | POS-Datenverkehr, Zahlungsdienste, Filialbetrieb, Mitarbeiter-Zugang | Isolierte VLANs, ausfallsicheres Edge, LTE- oder 5G-Backup, getestetes Umschalten der Leitung | Zahlungs- und betrieblicher Datenverkehr können ohne strikte Segmentierung mit dem Gäste-Zugang konkurrieren |
| Gesundheitswesen | Klinisches WiFi, elektronische Patientenakten, Telemetrie, freigegebenes BYOD | Batteriegepufferte Netzwerkschichten, ausfallsichere Identität, kontrollierte Verschlüsselungswiederherstellung, auditierbare Änderungen | Ein Fehler bei Authentifizierung oder Stromversorgung kann klinische Abläufe unterbrechen und Sicherheitsrisiken verursachen |
| Multi-Tenant-Objekte | Mieter-Zugang, WiFi in Gemeinschaftsbereichen, Gebäudebetrieb, Mitarbeiter-Dienste | Segmentierte SSIDs, mieterspezifische Richtlinien, unabhängige Authentifizierungsdomänen, redundante Pfade | Der Ausfall von Identität, DNS oder Richtlinien eines einzigen Betreibers kann sich auf alle Mieter auswirken |
Gastronomie- und Hotelbetreiber sollten das Gäste-WiFi als operativen und kommerziellen Kanal betrachten, nicht als reine Gefälligkeit. Einzelhandelsteams sollten die Zahlungspfade vom Gästedatenverkehr isoliert halten und überprüfen, ob die Backup-Leitung den tatsächlichen Transaktionsfluss unterstützt. Administratoren im Gesundheitswesen benötigen Protokolle über Änderungen, die Audits standhalten, und müssen gleichzeitig sicherstellen, dass batteriegepufferte Geräte den von Medizinern genutzten Zugriffspfad abdecken.
Für Stadien, Wohngebäude, Coworking Spaces und andere Multi-Mandanten-Standorte muss sich die Segmentierung auch auf die Authentifizierung und das DNS erstrecken. Separate SSIDs allein garantieren keine Mandantentrennung, wenn Richtlinien, Identitätsabfragen oder Verwaltungspfade weiterhin gemeinsam genutzt werden.
Ein sinnvoller erster Schritt ist eine 30-tägige Pilot-Inventarisierung. Katalogisieren Sie Access Points, Switches, Controller, WAN-Leitungen, Identitätsdienste, DNS, Stromversorgung und Eigentümer in einer repräsentativen Immobilie oder an einem repräsentativen Standort. Erstellen Sie dann eine gestaffelte SLA-Übersicht für den Sektor, führen Sie einen kontrollierten Failover durch und nutzen Sie die Ergebnisse, um die nächste Risikominderung zu finanzieren. Der aktuelle Druck auf die Personalplanung macht auch den Faktor Mensch-Risiko wichtig. Der CIPD Labour Market Outlook für den Sommer 2026 berichtete, dass 21 % der britischen Arbeitgeber in den drei Monaten bis September 2026 betriebsbedingte Kündigungen planten. Weniger Personal bedeutet weniger Toleranz für undokumentierte Wiederherstellungsarbeiten. Entwerfen Sie daher Runbooks und Zuständigkeiten vor der nächsten personellen Veränderung.
Die britischen Pflichten bei Massenentlassungen machen fragmentierte Standorte auch zu einem Zeit- und Datenproblem. Die Richtlinien der Regierung zu Konsultationen bei Entlassungen besagen, dass der Schwellenwert von 20 oder mehr Mitarbeitern für eine einzelne Betriebsstätte innerhalb von 90 Tagen gilt, wobei der Zeitrahmen für die Benachrichtigung an den geplanten Entlassungszeitraum gekoppelt ist. Für Netzwerkverantwortliche besteht die analoge Lektion darin, Standorte und Abhängigkeiten präzise zu kartieren. Bei einem standortübergreifenden Netz kann man nicht einfach davon ausgehen, dass separate Gebäude, Leitungen oder Teams separate Ausfalldomänen bilden, ohne zu beweisen, wie Datenverkehr, Identität und Betrieb miteinander verbunden sind.
Purple bietet Cloud-gesteuerte WiFi Authentifizierung und identitätsbasierten Zugriff, einschließlich RADIUS-Funktionen, die mit redundanten Dienstpfaden entwickelt wurden. So kann es Teil eines Resilienz-Konzepts werden, anstatt die Anmeldung von Gästen als versteckten Single Point of Failure zu belassen. Prüfen Sie, wie Purple in Ihre Netzwerk-, Identitäts- und Failover-Anforderungen passt, und beginnen Sie dann mit einer Bestandsaufnahme auf Standortebene und einer kontrollierten Authentifizierungsübung.