
Por que o nosso Guest WiFi está tão lento? Diagnosticando o congestionamento de rede
Este guia diagnostica os fatores ocultos do congestionamento de Guest WiFi - telemetria de segundo plano, redes de anúncios programáticos e atualizações automatizadas de SO - que coletivamente consomem até 40% da largura de banda do WiFi público antes mesmo de um visitante abrir o navegador. O guia fornece uma estrutura de implementação em fases e neutra em termos de fornecedor para filtragem de DNS e políticas de QoS que recuperam essa largura de banda, melhoram a experiência do visitante e geram ROI mensurável. Voltado para Diretores de TI e Gerentes de Operações nos setores de hotelaria, varejo, eventos e ambientes do setor público.
Video overview
Ouça este guia
Ver transcrição do podcast
Parte da nossa série principal: Guia de Guest WiFi →
Resumo Executivo
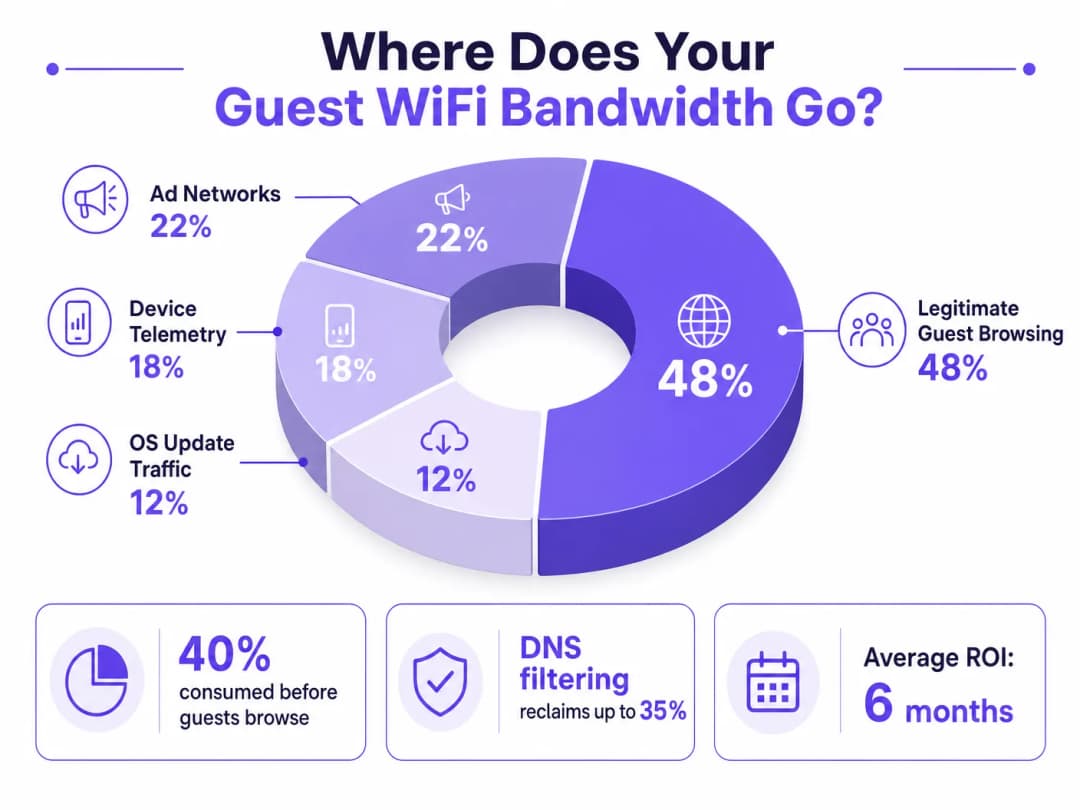
Para Diretores de TI e Gerentes de Operações que supervisionam locais de alta densidade, garantir uma experiência de Guest WiFi confiável é uma batalha constante contra o congestionamento da rede. Embora as abordagens herdadas se concentrem no aumento da largura de banda geral ou na implantação de pontos de acesso adicionais, a causa raiz do baixo rendimento geralmente não está no tráfego de usuários legítimos, mas na camada oculta de dados em segundo plano. Em ambientes modernos - de complexos de Hospitality em expansão a espaços de Retail de grande circulação - até 40% da largura de banda do WiFi público é consumida por telemetria de dispositivos, redes de anúncios programáticos e atualizações automatizadas de SO antes mesmo de um convidado abrir um navegador.
Este guia de referência técnica fornece uma metodologia definitiva para diagnosticar esse congestionamento e implementar mitigação estratégica. Ao implantar filtragem DNS no nível da rede e Zonas de Política de Resposta (RPZ), os arquitetos de rede corporativa podem recuperar uma largura de banda significativa, reduzir a latência e melhorar drasticamente a experiência do usuário final sem incorrer em despesas de capital com atualizações de infraestrutura. Exploraremos a arquitetura técnica dessas soluções, estudos de caso de implementação no mundo real e o ROI mensurável de recuperar sua rede.
Detalhamento Técnico
A Anatomia do Congestionamento de Segundo Plano
Quando um dispositivo de visitante se autentica em uma rede pública, ele inicia imediatamente uma enxurrada de conexões em segundo plano. Essas conexões são impulsionadas principalmente por três categorias de tráfego que, em conjunto, constituem o que os engenheiros de rede chamam de carga fantasma - a largura de banda consumida pela rede antes de ocorrer qualquer atividade deliberada do visitante.
1. Telemetria e Análise de Dispositivos
Os sistemas operacionais modernos (iOS, Android, Windows) e os aplicativos instalados transmitem constantemente dados de uso, métricas de localização, relatórios de falhas e análises comportamentais para servidores remotos. Em um ambiente denso, como um hub de Transporte ou centro de conferências, milhares de dispositivos transmitindo simultaneamente pequenas, mas frequentes, cargas de telemetria podem esgotar o tempo de transmissão sem fio disponível e sobrecarregar as tabelas NAT. Um único dispositivo iOS pode gerar mais de 200 consultas DNS distintas em segundo plano nos primeiros 60 segundos após a conexão a uma rede sem limite.
2. Redes de Anúncios Programáticos
Muitos aplicativos gratuitos dependem de ecossistemas de publicidade programática. No momento em que um dispositivo detecta uma conexão WiFi sem limite de uso, esses aplicativos começam a carregar previamente anúncios em vídeo, banners de exibição de alta resolução e scripts de rastreamento de plataformas de ad exchange. Esse tráfego consome muita largura de banda e é sensível à latência, competindo agressivamente pelo tempo de transmissão com a navegação legítima dos visitantes. A análise de redes de locais públicos mostra consistentemente que o tráfego de anúncios programáticos representa de 15% a 22% da utilização total da WAN durante os horários de pico.
3. Atualizações Automáticas de SO e Aplicativos
Sem uma modelagem de tráfego adequada, os dispositivos tentarão baixar grandes patches de SO e atualizações de aplicativos assim que detectarem uma conexão WiFi sem limite. Uma única atualização principal do iOS pode ter de 3 a 5 GB. Em um ambiente de 500 dispositivos, o acionamento de uma atualização simultânea - comum quando uma nova versão de SO é lançada - pode saturar até mesmo um link WAN de 1 Gbps em poucos minutos.
Por que as Abordagens Tradicionais Falham
A resposta convencional ao congestionamento de WiFi de visitantes é aumentar a largura de banda da WAN ou implantar pontos de acesso adicionais. Embora ambas as medidas tenham seu valor, nenhuma delas resolve a carga fantasma. Adicionar mais largura de banda simplesmente fornece mais capacidade para o tráfego de segundo plano consumir. A Inspeção Profunda de Pacotes (DPI), a outra ferramenta tradicional, é cada vez mais ineficaz: a adoção generalizada do TLS 1.3 e da criptografia de ponta a ponta significa que a maioria das cargas úteis de tráfego é opaca para os mecanismos de inspeção. Não é possível limitar o que não se pode classificar.
Para uma discussão mais ampla sobre como as frequências sem fio interagem com implantações de alta densidade, consulte nosso guia sobre Wi-Fi Frequencies: A Guide to Wi-Fi Frequencies in 2026.### Filtro DNS: A Contrapartida Eficiente
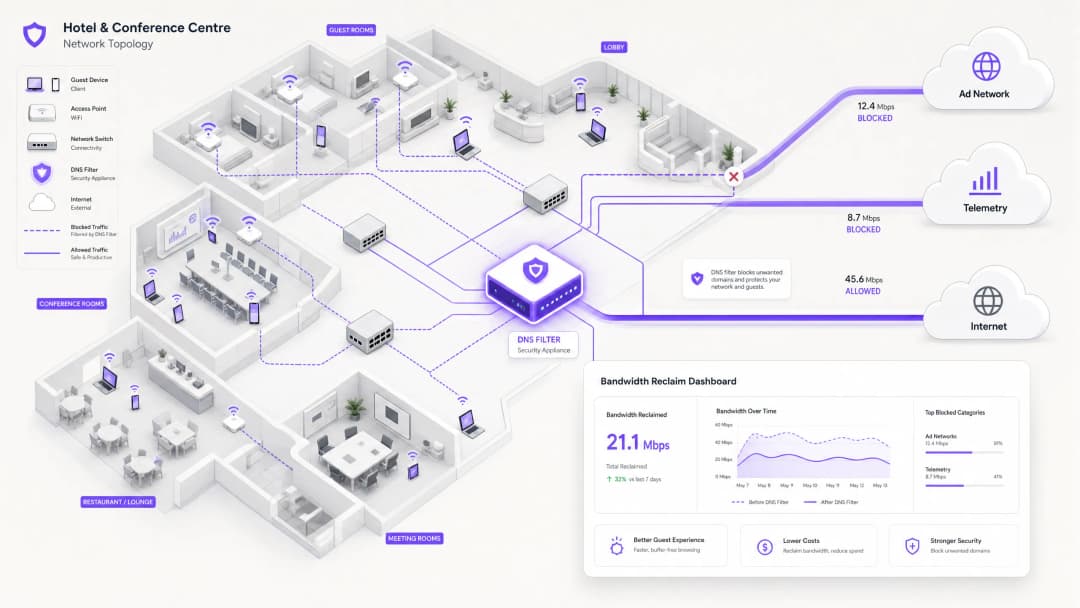
A solução moderna e escalável é o filtro DNS na borda da rede. Em vez de inspecionar o conteúdo do tráfego, o filtro DNS opera na camada de resolução - impedindo que as conexões sejam estabelecidas em primeiro lugar.
Quando um dispositivo solicita acesso a uma rede de anúncios conhecida ou a um domínio de telemetria, o resolvedor DNS compara a solicitação com uma Response Policy Zone (RPZ). Se o domínio estiver na lista de bloqueio, o resolvedor retorna uma resposta NXDOMAIN (Domínio Inexistente) ou redireciona o tráfego para um endereço IP nulo local (sinkhole). A conexão é encerrada antes que ocorra o handshake TCP, preservando tanto o tempo de transmissão de dados do WiFi quanto a largura de banda da WAN. Essa abordagem consome poucos recursos de computação, escala de forma linear com a capacidade do resolvedor e não é afetada pela criptografia do tráfego.

A Dimensão de Segurança
O filtro DNS oferece um benefício secundário significativo: a segurança. Ao bloquear domínios conhecidos de Command and Control (C2) de malware, infraestruturas de phishing e redes de distribuição de kits de exploração na camada DNS, a rede de visitantes torna-se substancialmente mais defensável. Isso é diretamente relevante para as obrigações de conformidade sob frameworks como PCI-DSS (que exige segmentação e monitoramento de rede para ambientes de dados de portadores de cartão) e GDPR (que exige medidas técnicas apropriadas para proteger dados pessoais). Para um detalhamento sobre os requisitos de trilha de auditoria neste contexto, consulte Explain what is audit trail for IT Security in 2026.
Para organizações que gerenciam ambientes educacionais onde o bloqueio de anúncios também serve como uma função de proteção, os princípios abordados em Minimising Student Distractions with Network-Level Ad Blocking são diretamente aplicáveis.
Tem dúvidas sobre a sua configuração específica?
A nossa equipa trabalha com operadores de espaços, gestores de TI e engenheiros de rede em 80.000 locais. Agende uma chamada de 20 minutos e mostraremos como outros profissionais na sua situação o resolveram.
Guia de Implementação
A implantação de uma arquitetura robusta de filtro DNS exige um planejamento cuidadoso para evitar a interrupção de serviços legítimos de visitantes. A implementação deve seguir uma abordagem em fases.
Fase 1: Avaliação de Linha de Base e Visibilidade
Antes de implementar qualquer bloqueio, estabeleça uma linha de base dos padrões de tráfego atuais. Utilize o WiFi Analytics para identificar os domínios e categorias que mais consomem largura de banda em um período representativo de 7 a 14 dias. Essa fase de auditoria é crítica para compreender o perfil de tráfego específico do seu local de atendimento e para construir o caso de negócios para o investimento. As principais métricas a serem capturadas incluem:
| Métrica | Linha de Base Alvo | Notas |
|---|---|---|
| Os 20 principais domínios DNS por volume de consulta | Lista completa | Identificar domínios de telemetria e anúncios |
| Utilização de WAN por categoria | Divisão em % | Quantificar a carga fantasma |
| Pico de contagem de dispositivos simultâneos | Número | Dimensionar a infraestrutura do resolvedor |
Fase 2: Implantação de RPZ em Etapas
Comece implantando a RPZ em modo apenas de log. Isso permite verificar a precisão de suas listas de bloqueio sem impactar a experiência do usuário. Foque primeiro em categorias de alta confiança:
- Malware Conhecido e Domínios C2: Benefício de segurança imediato com risco quase zero de falsos positivos. Use feeds de inteligência de ameaças de provedores confiáveis.
- Redes de Anúncios Programáticos de Alta Banda: Foque nas principais plataformas de troca de anúncios em vídeo. Elas são bem documentadas e têm pouca probabilidade de hospedar conteúdo legítimo.
- Endpoints de Telemetria Agressivos: Bloqueie domínios de rastreamento não essenciais. Mantenha uma lista de permissões cuidadosa para domínios necessários para os fluxos de autenticação do Captive Portal.
Assim que o modo apenas de log confirmar taxas de falsos positivos aceitáveis (meta < 0.5% das consultas), mude para o modo de aplicação.
Fase 3: Modelagem de Tráfego e Integração de QoS
Para o tráfego que não pode ser totalmente bloqueado (ex.: atualizações de OS da Apple, Microsoft e Google), implemente políticas de Quality of Service (QoS). Limite a taxa dos servidores de atualização a um teto definido - normalmente 10-15% da capacidade total da WAN - garantindo que o tráfego interativo dos convidados (navegação na web, VoIP, videoconferência) receba prioridade na fila. Isso é particularmente importante para ambientes de Saúde, onde a equipe clínica pode compartilhar um segmento de rede com os convidados.
Para orientações sobre a otimização de ambientes de rede mais amplos, incluindo implantações de escritórios e de uso misto, consulte Office WiFi: Optimize Your Modern Office Wi-Fi Network.
Melhores Práticas
Mantenha Listas de Permissões Explícitas para Serviços Críticos. Certifique-se de que os domínios essenciais para a autenticação do Captive Portal, gateways de pagamento (conformidade PCI-DSS) e operações principais do local sejam explicitamente permitidos. Uma lista de bloqueio mal configurada que interrompa o fluxo de login gerará uma carga de suporte imediata e significativa.
Comunique a Política de Forma Transparente. Seus Termos de Serviço devem declarar que o tráfego de rede é gerenciado para garantir uma experiência de alta qualidade para todos os usuários. Essa é uma melhor prática legal sob a GDPR e uma medida razoável para alinhar as expectativas dos convidados.
Automatize as Atualizações das Listas de Bloqueio. O cenário das redes de anúncios e domínios de telemetria muda constantemente. Os feeds de inteligência de ameaças e as listas de RPZ devem ser atualizados dinamicamente - de preferência em um ciclo inferior a 24 horas - para permanecerem eficazes.
Aborde a Evasão de DNS Proativamente. Implemente regras de firewall para interceptar e redirecionar todo o tráfego de saída da porta 53 (UDP e TCP) para o resolvedor local. Isso evita que os clientes ignorem a filtragem configurando manualmente servidores DNS externos.
Planeje para DNS over HTTPS (DoH). À medida que a adoção de DoH aumenta, os clientes podem rotear consultas DNS via HTTPS para contornar totalmente os resolvedores locais. Avalie se deve bloquear provedores de DoH conhecidos (ex.: dns.google, cloudflare-dns.com) ou implantar um proxy DoH transparente que aplique a política local.
Alinhe-se com IEEE 802.1X e WPA3. Certifique-se de que sua arquitetura de filtragem DNS seja compatível com sua estrutura de autenticação. Em ambientes que usam IEEE 802.1X com autenticação baseada em RADIUS, as políticas de filtragem DNS podem ser aplicadas por VLAN ou por grupo de usuários, permitindo um controle granular.
Solução de problemas e mitigação de riscos
Modos de falha comuns
| Modo de falha | Sintoma | Mitigação |
|---|---|---|
| Bloqueio excessivo (colisão de CDN) | Páginas web quebradas, imagens ausentes | Listas de bloqueio granulares; processo rápido de lista de permissões |
| Evasão de DNS (resolvedores codificados) | Filtragem burlada por aplicativos específicos | Regras de redirecionamento de firewall para a porta 53 |
| Desvio de DoH | Filtragem burlada por navegadores modernos | Bloquear provedores de DoH conhecidos ou implantar proxy DoH |
| Gargalo de desempenho do resolvedor | Aumento da latência de DNS em todos os clientes | Dimensionar a infraestrutura do resolvedor; implementar anycast |
| Quebra do Captive Portal | Visitantes não conseguem se autenticar | Lista de permissões explícita para domínios do portal e endpoints de detecção de SO |
| Listas de bloqueio desatualizadas | Novos domínios de anúncios não bloqueados | Automatizar atualizações de feeds; monitorar logs de consulta para novos domínios de alto volume |
Resposta a incidentes de segurança
Se um dispositivo de visitante for identificado se comunicando com um domínio C2 de malware conhecido (visível nos logs de consulta DNS), a RPZ bloqueará automaticamente comunicações futuras. Certifique-se de que seu processo de resposta a incidentes inclua um fluxo de trabalho para revisar esses eventos, pois eles podem indicar um dispositivo comprometido que requer isolamento da VLAN de visitantes.
Retorno sobre o investimento (ROI) e impacto nos negócios
A implementação da filtragem DNS em nível de rede proporciona resultados de negócios mensuráveis e quantificáveis em várias dimensões.
Recuperação de largura de banda e adiamento de CapEx. Os locais de eventos normalmente recuperam de 20 a 40% de sua largura de banda WAN total. Isso se traduz diretamente em economia de custos, adiando a necessidade de atualizações caras de circuitos. Para um local que atualmente paga por uma linha dedicada de 500 Mbps, recuperar 30% da capacidade equivale a obter 150 Mbps de taxa de transferência efetiva sem custo adicional.
Melhoria na satisfação dos visitantes e NPS. Ao eliminar o congestionamento em segundo plano, a velocidade e a confiabilidade percebidas do WiFi de visitantes melhoram drasticamente. A latência reduzida e a taxa de transferência consistente levam a pontuações de Net Promoter Scores mais altas e a menos escalonamentos de suporte operacional.
Melhoria na postura de segurança e conformidade. O bloqueio de domínios de malware e phishing na camada de DNS reduz significativamente o risco de uma violação de segurança originada da rede de visitantes. Isso apoia diretamente a conformidade com os requisitos de segmentação de rede PCI-DSS e a obrigação do GDPR de implementar medidas técnicas de segurança apropriadas.
Eficiência operacional. A filtragem DNS automatizada reduz a carga de trabalho manual das equipes de operações de rede. Em vez de responder de forma reativa a eventos de congestionamento, a rede gerencia proativamente seu próprio perfil de tráfego.
| Resultado | Intervalo típico | Método de medição |
|---|---|---|
| Largura de banda recuperada | 20-40% da capacidade WAN | Monitoramento de utilização da WAN antes/depois |
| Taxa de bloqueio de consultas DNS | 15-35% de todas as consultas | Logs de consulta do resolvedor |
| Melhoria na satisfação dos convidados | +8-15 pontos de NPS | Pesquisas pós-estadia/pós-visita |
| Diferimento de CapEx | 1-3 anos na atualização de circuito | Modelagem de custos |
| Redução de incidentes de segurança | 40-60% menos detecções C2 | Correlação de SIEM |
Ao tratar a rede não apenas como um tubo, mas como um gateway inteligente e filtrado, os líderes de TI podem oferecer uma experiência de conectividade superior, segura e econômica - que acompanha o crescimento do local sem investimentos proporcionais em infraestrutura.
Definições principais
Response Policy Zone (RPZ)
Um mecanismo em servidores DNS que permite a modificação das respostas DNS com base em uma política definida. Quando um domínio consultado corresponde a uma entrada na RPZ, o resolvedor pode retornar uma resposta sintética (por exemplo, NXDOMAIN ou um IP de sinkhole) em vez da resposta real.
O principal mecanismo técnico para implementar a filtragem de DNS em toda a rede. As equipes de TI configuram as RPZs em seus resolvedores internos para bloquear redes de anúncios, domínios de malware e endpoints de telemetria sem a necessidade de software no lado do cliente.
Deep Packet Inspection (DPI)
Uma forma de filtragem de pacotes de rede que examina o payload de dados de um pacote à medida que ele passa por um ponto de inspeção, buscando inconformidades com o protocolo, conteúdo específico ou critérios definidos.
Tradicionalmente usado para classificação e modelagem de tráfego. Cada vez mais limitado pela adoção generalizada da criptografia de ponta a ponta TLS 1.3, que torna os payloads opacos. A filtragem de DNS é a alternativa preferida para ambientes com tráfego criptografado.
NXDOMAIN
Um código de resposta DNS (RCODE 3) que indica que o nome de domínio consultado não existe no namespace do DNS.
Retornado por um resolvedor DNS de filtragem para bloquear intencionalmente uma conexão a um domínio indesejado. O aplicativo cliente recebe essa resposta e abandona a tentativa de conexão, evitando que qualquer largura de banda seja consumida.
DNS over HTTPS (DoH)
Um protocolo para realizar a resolução de DNS por meio do protocolo HTTPS (RFC 8484), criptografando consultas e respostas DNS entre o cliente e um resolvedor compatível com DoH.
Pode burlar a filtragem de DNS da rede local se os clientes estiverem configurados para usar provedores DoH externos. Os administradores de rede devem implementar regras de firewall ou tráfego DoH de proxy para impor as políticas de RPZ locais.
Quality of Service (QoS)
Um conjunto de mecanismos de rede que controlam a priorização de tráfego, limitação de taxa e enfileiramento para garantir o desempenho de aplicativos críticos.
Usado em conjunto com a filtragem de DNS para gerenciar o tráfego legítimo, mas de alta largura de banda (por exemplo, atualizações de SO) que não pode ser bloqueado. O QoS garante que o tráfego interativo dos visitantes receba prioridade sobre as transferências em lote em segundo plano.
Telemetry
A coleta e transmissão automatizada de dados operacionais de dispositivos para servidores remotos para fins de monitoramento, análise e diagnóstico.
No contexto de WiFi para visitantes, a telemetria de dispositivos originada de sistemas operacionais móveis e aplicativos pode consumir silenciosamente de 15% a 20% da largura de banda disponível. É um alvo primário para a filtragem de DNS em implantações de redes públicas.
DNS Sinkholing
Uma técnica na qual um servidor DNS é configurado para retornar um endereço IP falso (geralmente um endereço nulo local) para domínios específicos, redirecionando o tráfego para longe do seu destino pretendido.
Usado para neutralizar o tráfego C2 de malware e bloquear agressivamente redes de anúncios de alta largura de banda. Mais definitivo do que as respostas NXDOMAIN, pois permite que o servidor de sinkhole registre as tentativas de conexão para análise de segurança.
Airtime Fairness
Um recurso de rede sem fio que aloca acesso igual ao meio sem fio para todos os clientes conectados, independentemente de suas taxas de dados individuais.
Crítico em ambientes de alta densidade. Sem airtime fairness, um único dispositivo lento (por exemplo, um cliente 802.11g mais antigo) pode consumir o tempo de transmissão de forma desproporcional, degradando a taxa de transferência de todos os outros clientes. O tráfego de telemetria em segundo plano de muitos dispositivos agrava esse efeito.
Phantom Load
Largura de banda consumida por processos em segundo plano automatizados nos dispositivos conectados antes que ocorra qualquer atividade deliberada do usuário.
O termo coletivo para telemetria, pré-busca de redes de anúncios e tráfego de atualização de SO. Compreender e quantificar a carga fantasma é o primeiro passo em qualquer diagnóstico de congestionamento de WiFi para visitantes.
Exemplos práticos
Um resort de 400 quartos está enfrentando um congestionamento severo de rede todas as noites, entre 19:00 e 22:00. O link WAN de 1 Gbps fica saturado, e os hóspedes reclamam de lentidão em streaming e queda de chamadas VoIP. O Diretor de TI precisa identificar a causa raiz e implementar uma solução sem fazer o upgrade do circuito.
Passo 1 - Análise de Tráfego: Implante um analisador de fluxo de rede (NetFlow/IPFIX) no roteador principal e execute-o por 5 dias durante os períodos de pico e fora de pico. Correlacione os dados com os logs de consultas DNS do resolvedor existente. A análise revela que 35% do tráfego noturno é destinado a redes de anúncios de vídeo programáticos conhecidas (DoubleClick, AppNexus) e servidores de atualização automática de aplicativos (Apple Software Update, Google Play). O tráfego legítimo de navegação dos hóspedes representa apenas 52% do tráfego total.
Passo 2 - Implantação de Filtragem de DNS: Configure o firewall principal para redirecionar todas as consultas DNS da VLAN de visitantes (porta UDP/TCP 53) para um resolvedor local com suporte a RPZ. Importe uma blocklist selecionada abrangendo as redes de anúncios e domínios de telemetria identificados. Execute no modo apenas registro (log-only) por 48 horas para validar as taxas de falso positivo.
Passo 3 - Aplicação de Políticas: Após validar uma taxa de falso positivo inferior a 0,3%, alterne para o modo de aplicação. Simultaneamente, implemente uma política de QoS que limite a taxa dos servidores de atualização da Apple e do Google a um teto combinado de 80 Mbps durante a janela das 18:00 às 23:00.
Passo 4 - Validação: Monitore a utilização da WAN nos 7 dias seguintes. A utilização de pico cai de 98% para 61%, resolvendo as reclamações dos hóspedes. O hotel adia um upgrade de circuito planejado por um período estimado de 18 meses.
Um grande centro de conferências está sediando um evento de tecnologia com 5.000 participantes. Durante a apresentação principal, a rede WiFi torna-se completamente inutilizável. A análise pós-incidente mostra que milhares de dispositivos tentaram baixar simultaneamente uma grande atualização do iOS que foi lançada naquela manhã.
Mitigação Imediata (Dia do Evento): A equipe de operações de rede identifica o pico de tráfego por meio do monitoramento de consultas DNS em tempo real. Eles imediatamente redirecionam para um "sinkhole" os domínios específicos de atualização de software da Apple (mesu.apple.com, appldnld.apple.com, updates.cdn-apple.com) na camada de DNS. Em 4 minutos, a utilização da WAN cai de 99% para 68%, e a rede se estabiliza.
Solução de Curto Prazo (Mesmo Evento): Uma política de QoS é aplicada para limitar a taxa de todo o tráfego restante de atualização a 50 Mbps durante o evento.
Estratégia de Longo Prazo (Pós-Evento): A equipe de rede implementa uma política de QoS dinâmica que é ativada automaticamente quando a utilização total da WAN excede 75%, limitando os servidores de atualização conhecidos a 10% da capacidade total. Uma lista de verificação pré-evento é criada, incluindo o redirecionamento temporário para sinkholes dos principais domínios de atualização durante as 2 horas antes e depois de sessões de grande destaque. A equipe também assina os canais de notificação de lançamento de atualizações da Apple e da Microsoft para antecipar futuros eventos de pico de tráfego.
Questões práticas
Q1. Você é o Gerente de TI de uma rede nacional de varejo. Após implantar uma solução de filtragem de DNS em 50 lojas, vários gerentes de loja relatam que a página de login do Captive Portal não está carregando para os visitantes. A equipe de suporte está recebendo um alto volume de chamadas. Qual é a causa mais provável e qual é a etapa de remediação imediata?
Dica: Considere a cadeia de dependência completa de um fluxo de autenticação moderno de Captive Portal, incluindo os mecanismos de detecção de Captive Portal no nível do sistema operacional.
Ver resposta modelo
A causa mais provável é o bloqueio excessivo. O filtro de DNS está bloqueando um domínio necessário para o funcionamento do Captive Portal. Os sistemas operacionais móveis modernos usam domínios específicos para detectar Captive Portals (por exemplo, captive.apple.com para iOS, connectivitycheck.gstatic.com para Android). Se estes estiverem bloqueados, o sistema operacional não acionará o navegador do Captive Portal, e o visitante não verá nenhuma solicitação de login. Além disso, o próprio portal pode depender de uma CDN ou de um provedor de autenticação de terceiros (por exemplo, login social via Facebook ou Google) cujos domínios foram bloqueados inadvertidamente.
Remediação imediata: revise os logs de consulta de DNS em busca de respostas NXDOMAIN originadas da sub-rede de visitantes durante a fase de autenticação. Identifique todos os domínios bloqueados que são consultados antes de um login bem-sucedido. Adicione esses domínios à lista de permissões global. Implemente um modelo padrão de lista de permissões para implantações de Captive Portal que inclua todos os principais endpoints de detecção de sistemas operacionais e domínios comuns de provedores de autenticação.
Q2. Um arquiteto de rede de estádio percebe que, apesar de implementar uma filtragem de DNS agressiva, a utilização da WAN permanece criticamente alta durante os jogos. Uma investigação mais aprofundada revela um volume alto e sustentado de tráfego UDP na porta 443 que não se correlaciona com nenhum domínio bloqueado nos logs de DNS. O que está acontecendo e como isso deve ser resolvido?
Dica: Considere os protocolos de transporte modernos e como eles interagem com os controles na camada de DNS.
Ver resposta modelo
O alto volume de tráfego UDP 443 indica o uso de QUIC (HTTP/3). O QUIC é um protocolo de transporte baseado em UDP usado por grandes plataformas (Google, Meta, YouTube) que ignora os proxies tradicionais baseados em TCP e os mecanismos de DPI. Mais criticamente, os clientes que usam QUIC também podem estar usando DNS sobre HTTPS (DoH) para resolver domínios, ignorando completamente o resolvedor local de RPZ e tornando a filtragem de DNS ineficaz para esses clientes.
Para resolver isso: Primeiro, implemente regras de firewall para bloquear o tráfego DoH de saída para provedores públicos de DoH conhecidos (Google, Cloudflare, NextDNS) na porta TCP/UDP 443 por IP de destino, forçando os clientes a recorrerem ao resolvedor local. Segundo, avalie o bloqueio total do tráfego UDP 443 de saída (ou limite sua taxa de forma agressiva) para forçar os clientes QUIC a recorrerem ao HTTP/2 baseado em TCP, que está sujeito às políticas de gerenciamento de tráfego existentes. Terceiro, analise se um proxy DoH transparente pode ser implantado para interceptar e inspecionar consultas DoH enquanto aplica as políticas locais de RPZ.
Q3. Você está projetando uma política de QoS para a rede WiFi de visitantes de um grande hospital público. A rede é compartilhada entre dispositivos de entretenimento de pacientes, dispositivos pessoais de visitantes e um pequeno número de funcionários clínicos usando softphones VoIP em seus celulares pessoais. Priorize os seguintes tipos de tráfego: VoIP (SIP/RTP), Navegação Web de Visitantes (HTTP/HTTPS), Atualizações do Windows/iOS e Streaming de Vídeo (Netflix/YouTube).
Dica: Considere tanto a sensibilidade à latência quanto o impacto comercial/clínico de cada tipo de tráfego. Considere também o contexto regulatório de um ambiente de saúde.
Ver resposta modelo
Prioridade 1 - VoIP (SIP/RTP): Strict Priority Queuing (Expedited Forwarding, DSCP EF). O VoIP é altamente sensível à latência (meta < 150ms unidirecional) e ao jitter (meta < 30ms). A perda de pacotes acima de 1% causa degradação audível. Em um contexto clínico, uma chamada caída pode ter implicações na segurança do paciente.
Prioridade 2 - Navegação Web de Visitantes (HTTP/HTTPS): Assured Forwarding (AF31). Este é o principal caso de uso esperado tanto para pacientes quanto para visitantes. Requer uma capacidade de resposta razoável, mas é tolerante à latência moderada.
Prioridade 3 - Streaming de Vídeo (Netflix/YouTube): Taxa limitada por cliente (ex: limite de 3 a 5 Mbps) com Assured Forwarding (AF21). Embora seja importante para a experiência do paciente durante estadias longas, o streaming sem limites saturará o link. Um limite por cliente garante o acesso equitativo. Considere políticas de horário que flexibilizem os limites fora do horário de pico.
Prioridade 4 - Atualizações de SO/Apps (Classe Scavenger, DSCP CS1): Menor prioridade, fila de melhor esforço (best-effort), com um limite de taxa agregado (ex: 50 Mbps no total para todo o tráfego de atualização). Estas são tarefas em segundo plano sem sensibilidade à latência. Elas só devem consumir capacidade sobressalente. Em um ambiente de saúde, considere também se a rede de visitantes está totalmente isolada dos sistemas clínicos - se não estiver, o gerenciamento de tráfego de atualização torna-se uma preocupação de segurança, além de largura de banda.
Continue a ler esta série
Um Guia Passo a Passo para Diagnosticar Problemas de Roaming WiFi
Este guia abrangente oferece aos líderes de TI corporativa e arquitetos de rede uma metodologia autoritativa e passo a passo para diagnosticar e resolver problemas de roaming WiFi. Combinando análises técnicas profundas dos padrões IEEE 802.11k/v/r com estudos de caso reais e análise de pacotes, esta referência capacita as equipes a eliminar o problema do "cliente pegajoso" (sticky client) e entregar conectividade móvel contínua. O guia cobre todo o fluxo de diagnóstico, desde vistorias de local de RF (RF site surveys) e auditorias de configuração de controladoras até análise de captura de pacotes over-the-air e validação pós-correção.
Por que o WiFi do seu estádio trava (e como resolver isso)
Este guia técnico autoritativo examina a causa raiz do congestionamento do WiFi em estádios - a atividade simultânea em segundo plano de 50.000 dispositivos carregando anúncios programáticos e telemetria - e fornece um projeto de arquitetura detalhado para implantar a filtragem de DNS na borda como a principal estratégia de mitigação. Projetado para Diretores de TI, CTOs e Arquitetos de Rede, ele oferece orientações práticas de implementação, estudos de caso reais e estruturas de ROI mensuráveis para ajudar os operadores de locais a recuperar largura de banda e fornecer conectividade de alto desempenho em escala.
Resolvendo o Erro de Conectado, mas Sem Internet no WiFi de Visitantes
Este guia de referência técnica autoritativo explica como os timeouts de DNS causados por redes congestionadas acionam o erro "Conectado, Sem Internet" no WiFi de visitantes. Ele fornece aos arquitetos de rede e gerentes de TI etapas práticas de implementação para implantar filtros de DNS corporativos para resolver esses gargalos e melhorar a experiência de entrada de visitantes.
Tem dúvidas sobre a sua configuração específica?
A nossa equipa trabalha com operadores de espaços, gestores de TI e engenheiros de rede em 80.000 locais. Agende uma chamada de 20 minutos e mostraremos como outros profissionais na sua situação o resolveram.