Sie verbinden sich mit einer Gäste-SSID, der Laptop meldet "verbunden", das Smartphone öffnet nichts, Windows meldet eingeschränkte Konnektivität und dem Helpdesk wird die Schuld für ein "defektes Portal" gegeben. Meistens ist die Portalseite nicht das erste Problem. Die Captive Portal Erkennung ist es.
Dieser Unterschied ist heute wichtiger als noch vor wenigen Jahren. In gemischten britischen Infrastrukturen beeinflusst der Erkennungsworkflow die Benutzererfahrung, das Verhalten der Endpunktsicherheit, die Protokollierung und die Frage, ob Zero-Trust-Tools während des Onboardings stabil bleiben. Wenn Sie dies nur als "das Ding, das die Landingpage aufruft" betrachten, verpassen Sie die Fehler, die Benutzer blockieren.
Was die Captive Portal Erkennung tatsächlich tut
Ein Captive Portal beginnt nicht mit der Portal-Seite. Es beginnt damit, dass der Client entscheidet, ob das Netzwerk unbeschränkten Internetzugang hat.
Wenn ein Gerät eine Verbindung mit dem WiFi herstellt, sendet das Betriebssystem in der Regel eine HTTP-Anfrage im Hintergrund an einen vom Hersteller kontrollierten Endpunkt. Wenn die Antwort mit dem übereinstimmt, was der Client erwartet, geht das Gerät von einem offenen Internetzugang aus und verhält sich ruhig. Wenn die Antwort umgeleitet, geändert oder blockiert wird, entscheidet das Betriebssystem, dass wahrscheinlich ein Portal existiert, und öffnet einen Login-Flow.
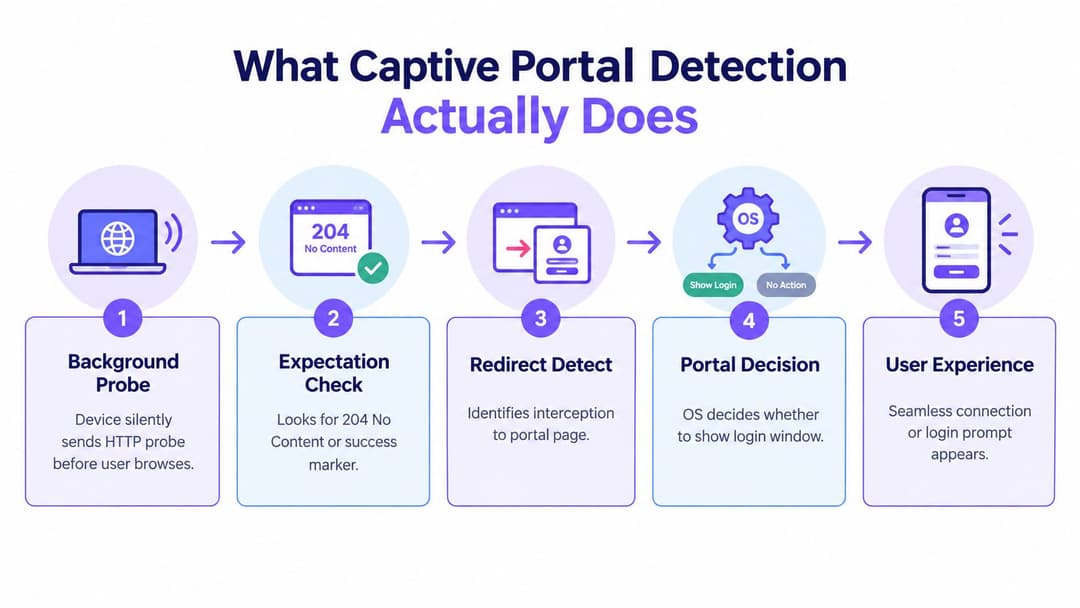
Die Erkennung ist das Tor, nicht der Login
Das ist der Teil, den viele Teams vermischen:
- Erkennung entscheidet, ob dem Benutzer überhaupt ein Portal angezeigt werden soll.
- Authentifizierung entscheidet, ob dieser Benutzer zugelassen wird.
- Autorisierung entscheidet, was dieser Benutzer danach erreichen kann.
Wenn die Erkennung fehlschlägt, kann das Portal vollkommen intakt sein, aber niemand wird es jemals sehen. Wenn die Erkennung erfolgreich ist, aber die Authentifizierung fehlschlägt, sehen die Benutzer die Seite, haben aber trotzdem keinen Zugriff. Das sind unterschiedliche Fehler, die unterschiedliche Behebungen erfordern.
Ein nützliches mentales Modell besteht darin, die Erkennung des Captive Portal als eine vom Betriebssystem gesteuerte Konnektivitätsentscheidung zu betrachten. Nicht der Browser führt die Aktion an. Das Betriebssystem tut es.
Warum dies in realen Netzwerken wichtig ist
Dies ist kein Nischen-Sonderfall. Eine Hotspot-Studie ergab, dass 484 Netzwerke den ersten Test zur Captive Portal Erkennung erreichten und 390 verschiedene Netzwerke eine Form von Captive Portal nutzten. Dies zeigt, dass die Portal-Erkennung bereits im realen Betrieb und nicht nur in Laborumgebungen aktiv war (Studienzusammenfassung).
Diese Skalierung ist wichtig, da jedes dieser Netzwerke darauf angewiesen ist, dass Clients die Probe-Antworten korrekt interpretieren. In der Praxis bedeutet dies, dass das Benutzererlebnis an einem sehr kleinen Austausch hängt: einem Statuscode, einem Response-Body oder einem Redirect.
Praktische Regel: Wenn Benutzer sagen "Das Portal wurde nicht angezeigt", überprüfen Sie den Pfad für den Verbindungstest, bevor Sie die Portal-Seite untersuchen.
Warum sich das Problem verändert hat
Die Fehlerbehebung bei älteren Hotspots konzentrierte sich darauf, das Laden der Splash-Page sicherzustellen. Das ist immer noch Teil der Aufgabe, aber moderne Netzwerke verfügen über eine weitere Ebene. Sicherheits-Agents, VPN-Clients und Onboarding-Tools reagieren ebenfalls, wenn sie vermuten, dass ein Captive Portal existiert. Mozilla dokumentiert, dass Firefox dedizierte Portal-Endpunkte überprüft, bevor eine Anmeldeseite geöffnet wird, während Cloudflare anmerkt, dass sein Client mehrere OS-spezifische Portal-Anfragen senden und die System-Firewall bis zum Abschluss des Onboardings vollständig öffnen kann. Dadurch wird die Erkennung zu einem Problem der Zuverlässigkeit und der Endpunktsicherheit, nicht nur zu einem Anmeldeproblem (Mozilla captive portal support article).
Deshalb stellen erfahrene Teams heute zwei Fragen statt nur einer. Erstens: Kann das Netzwerk das Portal zuverlässig auslösen? Zweitens: Sollte dieser Standort überhaupt noch auf diesen Workflow als primäre Zugriffsmethode setzen?
Kern-Sonden und Heuristiken hinter einer zuverlässigen Erkennung
Ein Client verbindet sich mit dem WiFi, erhält DHCP, zeigt eine gute Signalstärke und meldet dennoch "Kein Internet" oder öffnet das Anmeldefenster überhaupt nicht. In fast allen Fällen liegt das Problem im Probe-Pfad, nicht auf der Portalseite selbst.
Was Clients tatsächlich überprüfen
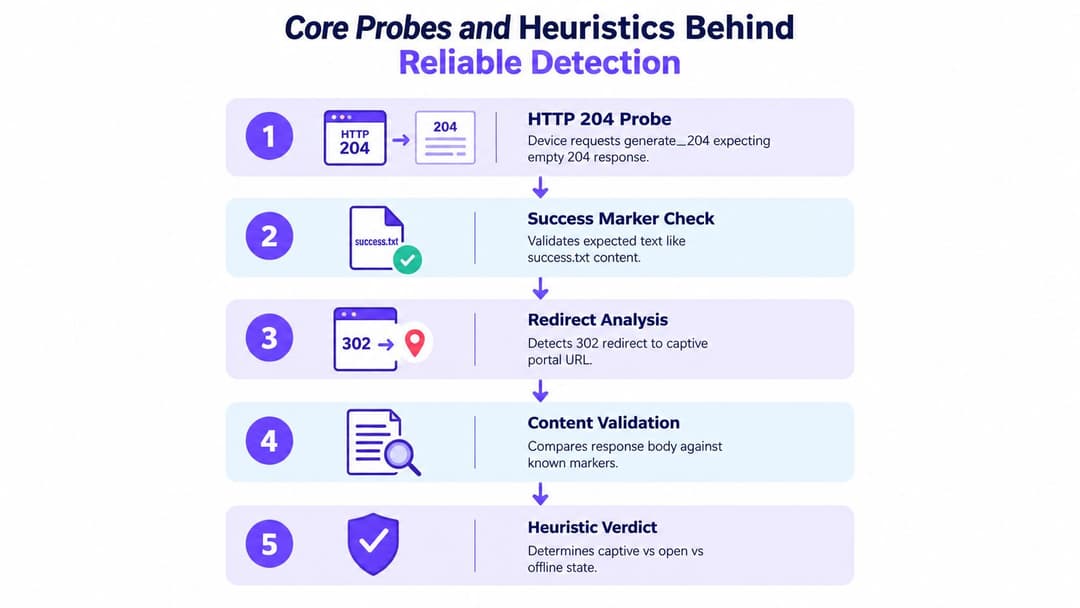
Die Captive Portal-Erkennung ist eine kleine Entscheidungs-Engine, die in das Betriebssystem oder den Client-Agenten integriert ist. Das Gerät sendet eine bekannte Anfrage an einen bekannten Endpunkt, vergleicht die Antwort mit einem erwarteten Ergebnis und entscheidet dann, ob das Netzwerk online, gesperrt oder fehlerhaft ist. Der Benutzer sieht möglicherweise nur einen Pop-up-Browser, aber die Arbeit fand bereits einige Pakete früher statt.
Häufige Probe-Ziele sind Apples captive.apple.com, Googles connectivitycheck.gstatic.com und clients3.google.com/generate_204, Microsofts msftconnecttest.com/connecttest.txt sowie Firefox's detectportal.firefox.com. Der Auslöser ist nicht der Hostname allein. Es ist die Kombination aus Statuscode, Headern, Body-Inhalt, Weiterleitungsverhalten und Timing, wie in der DrayTek Hotspot-Portal-Übersicht beschrieben.
Die Logik sieht in der Regel so aus:
- Client sendet einen Probe-Request
- Netzwerk lässt ihn durch oder fängt ihn ab
- Client gleicht die Antwort mit seinem erwarteten Muster ab
- Client klassifiziert den Netzwerkstatus
- Betriebssystem oder Agent entscheidet, ob ein Captive-Flow gestartet, der Benutzer gewarnt oder nichts unternommen wird
Dieser letzte Schritt ist wichtiger, als viele Teams erwarten. Sicherheits-Agenten, VPN-Clients und Onboarding-Tools reagieren oft auf dieselbe Entscheidung. Eine fehlerhafte Probe-Antwort kann den Zugriff blockieren, Sicherheitsprüfungen verzögern oder den Endpunkt in einem seltsamen, halb-verbundenen Zustand hinterlassen.
Was die Erkennung am häufigsten stört
Die häufigsten Fehlermuster sind langweilig, wiederholbar und bei einem schnellen Browsertest leicht zu übersehen.
- Falscher HTTP-Status: Android-Prüfungen erwarten oft
204 No Content. Wenn Sie eine gebrandete200 OK-Seite zurückgeben, stuft der Client das Netzwerk möglicherweise als Captive, fehlerhaft oder instabil ein. - Falscher Body-Inhalt: Windows und andere Stacks suchen oft nach exakten Klartext-Markern. Proxy-Banner, umgeschriebenes HTML oder Content-Injection-Features können diese Übereinstimmung verhindern.
- Fehler bei der Weiterleitung: Eine eindeutige Weiterleitung zum Portal ist in Ordnung. Weiterleitungsketten, Schleifen oder Weiterleitungen, die zwischen HTTP und HTTPS wechseln, führen oft zu unbemerkten Fehlern.
- DNS-Interferenz: DNS-Hijacking, Split-Horizon-DNS oder rekursive Resolver, die inkonsistent antworten, können Prüfungen an Orte senden, die der Client nicht erwartet hat.
- TLS-Interzeption: HTTPS-Filterung und Zertifikatssubstitution führen regelmäßig zu Beschwerden über "Verbunden, kein Internet", weil der Client dem Prüfergebnis nicht mehr vertraut.
- Timing- und Erreichbarkeitsprobleme: Langsames Upstream-DNS, blockierte CDNs für Portal-Assets oder fehlende Freigabelisten für Identitätsanbieter können dazu führen, dass die Erkennung zwischen den Zuständen hin- und herwechselt.
Ein praktischer Schritt bei der Einführung ist es, zuerst die Freigabeliste für die Vorauthentifizierung zu erstellen und diese separat zu testen. Tools wie der Walled Garden Generator für Captive Portal Domains und Abhängigkeiten von Purple helfen dabei, Probe-Hosts, Portal-Assets, Identitätsweiterleitungen und Post-Auth-Ziele zu erfassen, die eine unterschiedliche Behandlung erfordern.
Ein unklarer Fehler füllt die Ticket-Warteschlange. Ein eindeutiger Fehler ist einfacher zu diagnostizieren.
Warum die Heuristiken anfällig sind
Diese Prüfungen sind anfällig, da sie so konzipiert wurden, um den Netzwerkstatus aus einem minimalen Austausch abzuleiten - oft bevor das Gerät vollständigen Zugriff hat. Kleine Änderungen bei der Inhaltsfilterung, der SSL-Inspektion, bei Reverse-Proxies oder Firewall-Richtlinien können das Ergebnis verändern, ohne dass jemand das Portal selbst anfasst.
Ich sehe dies am häufigsten bei Enterprise-Gäste- und Onboarding-SSIDs, bei denen mehrere Teams für verschiedene Teile des Pfads zuständig sind. Das Wireless-Team sieht, dass die Zuordnung erfolgreich war. Das Firewall-Team sieht eine erlaubte Redirect-Richtlinie. Das Security-Team sieht, dass die HTTPS-Inspektion wie gewünscht funktioniert. Der Endpunkt sieht lediglich eine Probe-Antwort, die nicht mehr mit dem übereinstimmt, was er angefordert hat.
Aus diesem Grund sollte die Captive Portal-Erkennung als Zuverlässigkeits- und Endpunktsicherheits-Control behandelt werden, nicht nur als Komfortfunktion, die eine Anmeldeseite öffnet. Wenn die Erkennung unzuverlässig ist, schlägt das Onboarding der Benutzer fehl, Security-Agenten können die Erreichbarkeit falsch interpretieren und Support-Teams beheben am Ende Fehler auf der falschen Ebene.
Es erklärt auch, warum einige Infrastrukturen aufhören sollten, sich auf Captive-Workflows als primäre Zugriffsmethode zu verlassen. Für den BYOD-Gastzugang, Kurzzeitbesucher und ältere Onboarding-Verfahren hat die Portal-Erkennung immer noch ihre Berechtigung. Für verwaltete Benutzer in größeren britischen Enterprise-Infrastrukturen liefert Passpoint oder OpenRoaming oft ein besseres Ergebnis, da Zugriffsentscheidungen nicht mehr auf fehleranfälligen HTTP-Heuristiken beruhen, sondern von Anfang an in den authentifizierten Netzwerkzugriff verlagert werden.
Wie ein optimaler Zustand aussieht
Eine solide Bereitstellung weist einige konsistente Merkmale auf:
- Die Handhabung von Prüfungen erfolgt gezielt: Jede große Client-Familie erhält im Pre-Auth-Zustand das Antwortmuster, das sie erwartet.
- Pre-Auth-Pfade sind eng eingegrenzt: Nur die erforderlichen Prüfdomänen, Portal-Komponenten, Identitäts-Endpunkte und Update-Pfade sind erreichbar.
- Sicherheitskontrollen erkennen Prüf-Traffic: Proxies, Filter und TLS-Inspektionsrichtlinien schreiben diese Prüfungen nicht versehentlich um und fangen sie nicht ab.
- Zustandsänderungen erfolgen nach der Authentifizierung schnell: Sobald der Benutzer zugelassen ist, kann der Client die Verbindung erneut prüfen und den Captive-Status aufheben, ohne das WiFi aus- und wieder einzuschalten.
- Betriebsteams können auf Paketebene testen: Sie können das Client-Ergebnis anhand von DNS-, HTTP- und Weiterleitungs-Traces vorhersagen, nicht anhand eines Browser-Screenshots.
Wenn das Team allein anhand des unverschlüsselten Austauschs erklären kann, warum ein Gerät das Netzwerk als "Captive", "offen" oder "fehlerhaft" eingestuft hat, ist das Erkennungsdesign in der Regel in einem guten Zustand.
Wie verschiedene Betriebssysteme die Erkennung unterschiedlich handhaben
Montagmorgen, die Gast-SSID sieht gut aus. Clients verbinden sich, beziehen DHCP und zeigen ein gutes Signal. Dann teilen sich die Support-Tickets nach Gerätetyp auf. iPhones verbinden sich, zeigen aber nie eine Anmeldeseite, Android-Telefone melden sofort, dass eine Anmeldung erforderlich ist, und Windows-Laptops verbleiben so lange auf "Kein Internet", bis die Benutzer dem WiFi die Schuld geben. Deshalb gehört die Portal-Erkennung in das Runbook für Zuverlässigkeit und nicht nur in das Konzept für den Gastzugang.
Die Unterschiede sind auf dem Papier gering und in der Produktion teuer. Jede Plattform testet die Konnektivität auf ihre eigene Weise, und jede reagiert empfindlich auf leicht unterschiedliche Fehlermodi. In gemischten Umgebungen überschneiden sich diese Eigenheiten zudem mit Endpunktkontrollen wie Web-Filterung, TLS-Prüfung, VPN-Agenten und browserspezifischen Prüfungen. Ein Portal, das nur "im Browser funktioniert", funktioniert nicht richtig.
Erwartungen der OS-Sonden im Vergleich
| Client-Familie | Probe-Endpunkt | Erwartetes Erfolgssignal |
|---|---|---|
| Apple | captive.apple.com |
HTTP-Antwort, die die erwartete Erfolgsseite enthält |
| Android und Google-Stack | connectivitycheck.gstatic.com oder clients3.google.com/generate_204 |
204 No Content |
| Windows | msftconnecttest.com/connecttest.txt |
Erwarteter Microsoft-Verbindungstest-Klartext |
| Firefox | detectportal.firefox.com |
Erwartete Portal-Erkennungs-Antwort, die von Firefox verwendet wird |
Apple scheitert oft lautlos
Apple bietet in der Regel das reibungsloseste Benutzererlebnis, wenn der Pre-Auth-Pfad korrekt konfiguriert ist. Wenn er fehlerhaft ist, kann der Fehler fast lautlos auftreten. Das Gerät verbindet sich mit der SSID, erhält eine Adresse und sieht im Controller normal aus, aber der Captive-Assistent öffnet sich nie.
In der Praxis deutet das auf zwei häufige Ursachen hin. Die erste ist das Abfangen von Probes, das nicht dem entspricht, was Apple als Captive einstuft. Die zweite ist die Inhaltsänderung durch eine vorgelagerte Sicherheitskontrolle. Eine Blockseite, eine Header-Injektion oder eine SSL-Verarbeitungsrichtlinie kann die Antwort so verändern, dass das Gerät dem Ergebnis nicht mehr vertraut. Support-Teams suchen dann nach Fehlern bei HF oder DHCP, obwohl das Problem bei der HTTP-Integrität liegt.
Android ist einfacher zu testen und weniger nachsichtig
Das 204 No Content-Modell von Android ist kompromisslos. Das hilft bei der Diagnose, da das erwartete Verhalten eindeutig ist, bedeutet aber auch, dass sich kleine Fehler schnell bemerkbar machen. Wenn Sie eine Weiterleitung, einen HTML-Body oder eine gefilterte Antwort zurückgeben, wo Android nichts erwartet hat, stuft der Client das WiFi-Netzwerk unter Umständen als Captive Portal oder beeinträchtigt ein.
Diese Striktheit ist nützlich. Wenn Android auf derselben SSID instabil ist, auf der Apple einwandfrei funktioniert, beginnen Sie mit der Untersuchung des Proxy-Verhaltens, der Inhaltsfilterung und der Weiterleitungslogik, bevor Sie die Funkschnittstelle analysieren.
Windows offenbart Timing- und Richtlinienprobleme
Windows neigt dazu, Unklarheiten deutlicher als Apple aufzuzeigen. Benutzer sehen eine eingeschränkte Konnektivität, lange Verzögerungen, bevor das Portal erscheint, oder eine Verbindung, die aufgebaut zu sein scheint, aber beim Anwendungsdatenverkehr auf seltsame Weise fehlschlägt. In Enterprise-Infrastrukturen überschneidet sich dies oft mit Sicherheits-Tools. Always-on-VPN-Clients, Webschutzmodule und Host-Firewalls können dieselben Prüfungen beeinflussen, die Windows für den Konnektivitätsstatus verwendet.
Microsoft dokumentiert das aktuelle NCSI-Verhalten und die Endpunkte in seinen eigenen Richtlinien, was die richtige Referenz für aktuelle Windows-Clients ist. Die operative Lehre ist einfacher: Wenn NCSI abgefangen, gefiltert oder zu langsam beantwortet wird, merken es die Benutzer, bevor sie es verstehen.
Firefox kann vom Host-Betriebssystem abweichen
Firefox verdient auf Desktops besondere Aufmerksamkeit, da der Browser eine eigene Portal-Logik ausführt. Der Laptop zeigt möglicherweise eine normale Konnektivität an, während sich Firefox weiterhin so verhält, als ob der Zugriff eingeschränkt wäre - oder umgekehrt. Das ist nicht nur eine Eigenheit des Browsers. Es führt zu realem Support-Aufwand, da das Betriebssystem, der Browser und der Endpunkt-Agent jeweils eine unterschiedliche Sicht auf dasselbe Netzwerk haben können.
Praxishinweis: Wenn Benutzer melden, dass das "WiFi verbunden, aber Firefox blockiert ist", überprüfen Sie das Ergebnis der Betriebssystem-Untersuchung, das Ergebnis der Browser-Untersuchung und jeden Secure Web Gateway-Agenten auf dem Endgerät. Eine falsche Annahme in dieser Phase kann das Ticket an das falsche Team weiterleiten.
Gemischte Infrastrukturen erfordern gerätespezifisches Triage-Management
Nutzen Sie das Symptom, um den ersten Test auszuwählen.
- iPhone verbindet sich, aber es erscheint kein Anmeldefenster: Überprüfen Sie das Handling der Apple-Probes und stellen Sie sicher, dass der zurückgegebene Body intakt ist.
- Android meldet sofort, dass eine Anmeldung erforderlich ist: Bestätigen Sie, ob die Weiterleitung beabsichtigt ist und ob ein Gerät Inhalte anstelle von
204empfängt. - Windows meldet kein Internet, Portal erscheint verzögert: Überprüfen Sie die NCSI-Erreichbarkeit, das Redirect-Timing, die DNS-Antwort und lokale Sicherheits-Agents.
- Firefox verhält sich auf demselben Laptop anders als Chrome: Trennen Sie die Erkennung auf Browser-Ebene vom OS-Verbindungsstatus und der Endpunkt-Filterung.
An dieser Stelle ist auch die Design-Entscheidung entscheidend. Für Gäste, Besucher und BYOD-Zugänge lohnt es sich nach wie vor, die Portalerkennung fehlerfrei zu halten, da dieser Workflow erwartet wird und der Client-Mix unvorhersehbar ist. Für verwaltete Benutzer in größeren Netzwerken ist das wiederholte Auftreten von Portal-Grenzfällen meist ein Zeichen dafür, die Abhängigkeit von Captive-Logiken zu reduzieren und zu Passpoint oder OpenRoaming zu wechseln, wo die Zugriffskontrolle direkt beim Netzwerkeintritt erfolgt und nicht über fehleranfällige HTTP-Tests nach der Verbindung.
Praktische Erkennung mit curl, Python und Geräte-Agents
Der schnellste Weg, um Rätselraten zu beenden, ist das direkte Testen des Pfads für den Verbindungstest. Sie benötigen nicht für jeden Fall Paketaufzeichnungen. Beginnen Sie mit reproduzierbaren HTTP-Prüfungen und bestätigen Sie dann das Verhalten auf echten Endpunkten.
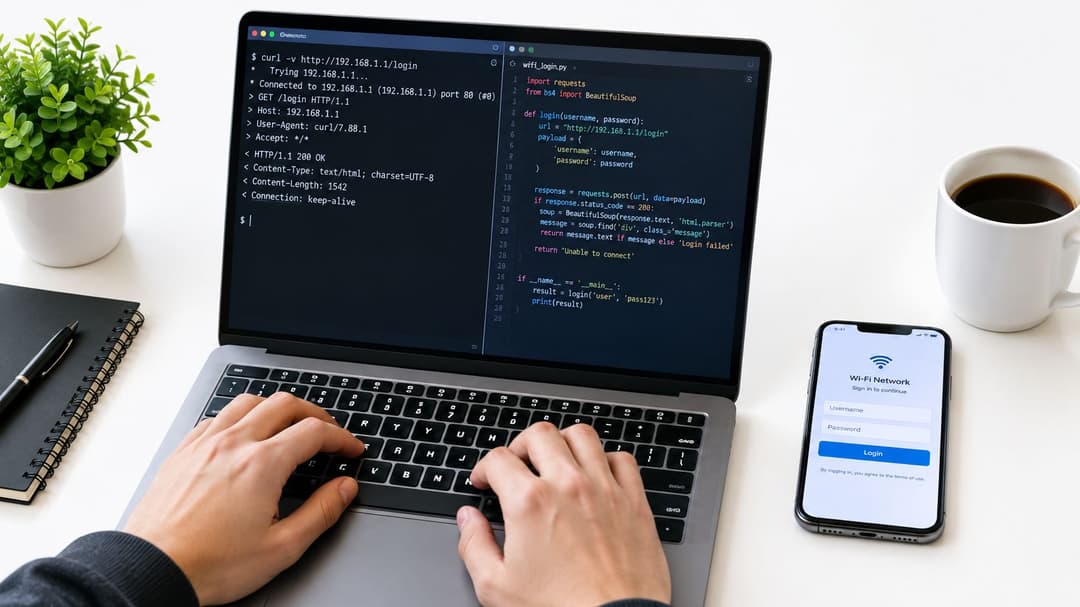
Starten Sie mit curl
Verwenden Sie curl, um Statuscodes, Header und Weiterleitungen aus demselben Netzwerksegment wie der Client zu untersuchen.
Für eine Sonde im Google-Stil:
- Nur Status prüfen: Rufen Sie den
generate_204-Endpunkt auf und prüfen Sie, ob das Ergebnis204oder eine Weiterleitung ist. - Weiterleitungen genau verfolgen: Führen Sie dieselbe Anfrage mit aktivierter Weiterleitungsverfolgung aus und prüfen Sie, ob sie einmal auf dem Portal landet oder in einer Schleife endet.
- Header prüfen: Wenn Content-Filtering-Systeme Banner, Kategorie-Header oder umgeschriebene Inhalte hinzufügen, kann die Erkennung fehlschlagen, selbst wenn das Portal online ist.
Für Text-Sonden im Windows-Stil:
- Rufen Sie den Body genau so ab, wie er zurückgegeben wird
- Vergleichen Sie die Klartextausgabe
- Suchen Sie nach Ersetzungen oder Wrapper-Seiten
Für Überprüfungen im Apple-Stil:
- Die erwartete Erfolgsseite anfordern
- Bestätigen, dass der Body dem entspricht, was der Client bei offenem Netzwerk erwartet
- Bestätigen, dass das Abfangen beabsichtigt ist, wenn der Client nicht authentifiziert ist
Eine schnelle Plausibilitätsprüfung mit einem HTTP-Header-Prüfer hilft, wenn Proxys oder Sicherheitsebenen die Antworten verändern.
Nutzen Sie ein kleines Python-Prüfskript
Ein kurzes Skript reicht aus, um die Prüfungen zu automatisieren, die Ihr Service Desk die ganze Woche über wiederholt. Halten Sie es einfach:
- Definieren Sie die Probe-URLs für die von Ihnen unterstützten Client-Familien.
- Senden Sie HTTP-Anfragen ohne Browser-Verhalten.
- Erfassen Sie Status, finale URL, Anzahl der Weiterleitungen und einen Ausschnitt des Response-Bodys.
- Vergleichen Sie die Ergebnisse mit den erwarteten Werten für offene Netzwerke.
- Kennzeichnen Sie unklare Ergebnisse wie einen
200-Status mit unerwartetem Inhalt oder wiederholten Weiterleitungen.
Dieses Skript muss Benutzer nicht anmelden. Seine Aufgabe ist es, eine einzige Frage zu beantworten: Hat das Netzwerk den Verbindungstest so präsentiert, dass die erwartete Client-Entscheidung ausgelöst wird?
Geräte-Agents erfordern Zurückhaltung
Beim Testen verwalteter Geräte können Teams unbeabsichtigte Nebeneffekte verursachen. Wenn Sie aggressive, skriptbasierte Tests auf Laptops erzwingen, auf denen bereits VPN-Clients, DNS-Schutz oder Zero-Trust-Agenten ausgeführt werden, können Sie genau den Onboarding-Status auslösen, den Sie eigentlich vermeiden möchten.
Nutzen Sie leichtgewichtige Agents mit Sicherheitsbarrieren:
- Führen Sie Probes bei Assoziierungsereignissen aus, nicht kontinuierlich.
- Vermeiden Sie weitreichende Firewall-Änderungen auf der Endpunktseite.
- Trennen Sie Onboarding-Tests für Gäste nach Möglichkeit von der produktiven VPN-Durchsetzung.
- Protokollieren Sie Entscheidungen zuerst lokal und exportieren Sie dann Zusammenfassungen.
Praxistipp: Testen Sie wie ein Client, nicht wie ein Angreifer. Ziel ist es, die Entscheidungen des Betriebssystems zu bestätigen, nicht jeden Redirect-Pfad per Brute-Force zu erzwingen.
Worauf Sie bei den Ergebnissen achten sollten
Gute Tests verraten Ihnen mehr als nur „aktiv“ oder „inaktiv“.
- Korrekte offene Antwort: Der Probe-Test gibt den erwarteten Code oder Marker zurück.
- Erwartete Captive-Antwort: Ein nicht authentifizierter Client wird einmalig zum Portal weitergeleitet.
- Dauerschleife (Looping): Dieselbe Anfrage wird wiederholt zurückgewiesen.
- Gefiltertes Ergebnis: Die Antwort existiert, aber der Inhalt wurde modifiziert.
- Toter Pfad (Dead path): Timeout oder unerreichbarer Endpunkt.
Wenn Sie diese Ergebnisse von einem Laptop im Gast-VLAN und von einem verwalteten Unternehmens-Endpunkt aus erfassen können, finden Sie die Ursache des Problems meistens, bevor der erste Benutzer-Screenshot in Ihrem Posteingang landet.
Integration der Erkennung mit Enterprise WiFi und Identitätsplattformen
Im Enterprise WiFi sollte die Erkennung von Captive Portalen nicht im Mittelpunkt des Designs stehen. Sie sollte eine kontrollierte Kompatibilitätsebene sein.
Das ist die Umstellung, an der viele Unternehmen noch arbeiten. Der Gastzugang, das Onboarding von Auftragnehmern und das öffentliche WiFi benötigen möglicherweise weiterhin Portal-Logik. Der Zugang für Mitarbeiter und bekannte Benutzer sollte nach Möglichkeit nicht davon abhängen.
Platzieren Sie die Sonden-Verarbeitung an der richtigen Stelle
Unabhängig davon, ob Sie Meraki, Aruba, Ruckus, Mist oder UniFi einsetzen, gilt dieselbe Designregel. Verarbeiten Sie nicht authentifizierte Probes vorhersehbar am Controller, Gateway oder am Cloud-Edge, wo Ihre Gast-Richtlinie bereits hinterlegt ist.
Das bedeutet:
- Erlauben Sie die richtigen Pfade vor der Authentifizierung: Probe-Endpunkte, Portal-Assets und alle Identitätsweiterleitungen, die vor dem vollständigen Zugriff geladen werden müssen.
- Halten Sie die Richtlinie für nicht authentifizierte Benutzer eng: ausreichend für das Onboarding, kein breites Internet.
- Trennen Sie die Logik für Gäste und Mitarbeiter: Lassen Sie das Abfangen durch das Portal nicht auf zertifikatsbasierte oder verwaltete Unternehmens-SSIDs zugreifen.
Wenn Sie den passwortbasierten Zugriff durch Identitäts-Workflows ersetzen möchten, ist identitätsbasiertes Networking das relevante Modell. Es verlagert den Zugriff bekannter Benutzer weg von Captive-Portal-Prozessen hin zu einer authentifizierten, richtliniengesteuerten Konnektivität.
Protokollierung ist im Vereinigten Königreich wichtig
Im britischen öffentlichen Sektor und im Enterprise-Kontext erfordert der Wireless-Sicherheitsstandard SS-019, dass Gast-Captive Portal-Authentifizierungen protokolliert, fehlgeschlagene Portal-Versuche untersucht, Konfigurationsänderungen mit der Identität des Administrators protokolliert und Schwellenwerte für die Traffic-Überwachung so festgelegt werden, dass bösartige Aktivitäten einzelnen Zugangsdaten zugeordnet werden können. Er weist auch auf Anomalien hin, wie ungewöhnlich hohe Geräteanzahlen an einem Access Point, abnormal hohen Traffic von einem Client und viele fehlgeschlagene Beitrittsversuche in kurzer Zeit (UK wireless security standard SS-019).
Das ändert die Art und Weise, wie ich die Erkennung implementieren würde. Protokollieren Sie nicht nur "Portal aufgerufen". Protokollieren Sie die Kette:
- Assoziierung und Client-Identität
- Probe-getriggerte Captive-Entscheidung
- Portal-Erfolg oder -Fehlerschlag
- Richtlinienänderung nach der Authentifizierung
- Telemetrie, die das Ereignis mit dem AP- und Client-Verhalten verknüpft
Verhindern Sie, dass Zero-Trust-Clients mit dem Portal in Konflikt geraten
Schlechte Designs scheitern an dieser Stelle. Einige Endpunktsicherheits-Tools behandeln Captive-Zustände als Ausnahme und lockern die Kontrollen vorübergehend. Wenn das Netzwerk fehlerhafte Captive-Erkennungen verursacht, können diese Clients ständig zwischen Onboarding-Logik und normaler Durchsetzung hin- und herwechseln.
Ein sicheres Muster ist:
- Bekannte Geräte nutzen zuerst die Enterprise-Authentifizierung
- Gäste und unbekannte Geräte fallen in einen eingeschränkten Onboarding-Pfad
- Die Portal-Erkennung bleibt als Fallback verfügbar
- VPN- und Zero-Trust-Teams validieren das Verhalten auf repräsentativen Client-Builds vor dem Rollout
Eine Plattform-Option in diesem Bereich ist Purple, die das Onboarding von Gäste-WiFi und identitätsbasierte Zugriffsmuster auf Netzwerkhardware von Drittanbietern unterstützt. Das ist nützlich, wenn Sie Portal-Unterstützung für Gäste benötigen, aber die Abhängigkeit von Portalen für wiederkehrende oder verwaltete Benutzer verringern wollen.
Tests, Fehlerbehebung und Überwachung, die die Erkennung zuverlässig halten
Die Erkennung von Captive Portalen kann fehlschlagen. Deshalb reicht eine einmalige Abnahmeprüfung nicht aus.
Die Annahme, die ich infrage stellen würde, ist folgende: Wenn die Portalseite während der Inbetriebnahme geladen wird, ist die Arbeit erledigt. Das ist sie nicht. Ein zuverlässiger Betrieb hängt davon ab, dass der Workflow der Untersuchung über Betriebssystem-Updates, Filteränderungen, Identitätsintegrationen und Änderungen der Endgerätesicherheit hinweg intakt bleibt.
Eine praktische Verifizierungsroutine
Verwenden Sie jedes Mal eine kurze Checkliste, wenn Sie den Gastzugang, die DNS-Richtlinie, die Filterung oder das Controller-Verhalten anpassen:
- Validierung der Prüf-Endpunkte: Bestätigen Sie, dass jede große Client-Familie den erwarteten Antworttyp erhält.
- Sinnhaftigkeit von Weiterleitungen: Prüfen Sie auf Single-Hop-Weiterleitungen statt Schleifen.
- Filterprüfung: Stellen Sie sicher, dass Webfilter oder Proxy-Ebenen keine Body-Inhalte oder Header umschreiben.
- DNS-Verhalten: Bestätigen Sie, dass nicht authentifizierte Clients das auflösen, was sie für das Onboarding benötigen, und nicht mehr.
- Wiederherstellung nach der Authentifizierung: Überprüfen Sie, ob Clients die Konnektivität nach der Authentifizierung sauber neu bewerten.
- Plattformübergreifende Stichproben: Testen Sie auf Windows, macOS, iOS und Android mit repräsentativen verwalteten und nicht verwalteten Geräten.
Überwachen Sie die richtigen Signale
Für den Betrieb in Großbritannien sollte die Erkennungszuverlässigkeit zusammen mit der Sicherheits-Telemetrie überwacht werden, nicht separat. SS-019 ist hier nützlich, da es Teams in Richtung Überprüfbarkeit und Anomalie-Überwachung lenkt, statt nur den Erfolg der Anmeldung zu verfolgen.
Ich würde auf Folgendes achten:
- Häufung von fehlgeschlagenen Verbindungsversuchen
- Unerwartete Client-Dichte auf einem einzelnen AP
- Wiederholte Portal-Fehler bei derselben Client-Klasse
- Diskrepanzen zwischen erfolgreicher Assoziierung und internetfähigen Sitzungen
- Abrupte Änderungen nach Endpunkt- oder Browser-Updates
"Verbunden" ist kein aussagekräftiger Erfolgsstatus für Gast-WiFi. Nutzbare Konnektivität ist es.
Wann man die Erkennung beibehalten und wann man sie ausmustern sollte
Dies ist die strategische Frage, die viele Teams vermeiden. Einige Infrastrukturen benötigen nach wie vor ein Captive Portal für die Erfassung von Gastidentitäten, die Zustimmung zu Nutzungsbedingungen oder Arbeitsabläufe für den öffentlichen Zugriff. Das ist in Ordnung. Behalten Sie es bei, aber behandeln Sie die Erkennung als einen sorgfältig getesteten Fallback-Pfad.
Für wiederkehrende Besucher, Mitarbeiter und verwaltete Benutzer wird das Business-Szenario für den Verzicht auf Captive Portals immer überzeugender. Die Abdeckung von OpenRoaming und Passpoint zeigt, dass diese Ansätze "endlich liefern" und ein automatisches, sicheres Onboarding ohne wiederholte Captive Portal-Anmeldungen ermöglichen. Ein Branchenbericht zeigt, dass 38% der Befragten bereits ein OpenRoaming- oder Passpoint-konformes Netzwerk bereitgestellt haben, während 32% Bereitstellungen für 2026 und 18% für 2027 planen, wie in diesem Bericht prognostiziert (Berichterstattung von Networking+ zur Ausrichtung des Mobilfunks in Großbritannien).
Das bedeutet nicht, dass Portale morgen verschwinden. Es bedeutet, dass viele Netzwerke aufhören sollten, sie als primäre User Journey zu konzipieren. In einer modernen UK-Enterprise-Infrastruktur gehört die Captive Portal-Erkennung oft in dieselbe Kategorie wie andere Legacy-Kompatibilitätsfunktionen. An einigen Stellen notwendig. An vielen anderen Stellen lohnt es sich, sie zu minimieren.
Wenn Sie versuchen, Reibungsverluste am Portal zu reduzieren, ohne die Kontrolle zu verlieren, bietet Purple eine Gast-WiFi-Authentifizierung, identitätsbasierten Zugriff sowie Unterstützung für Ansätze wie OpenRoaming und Passpoint, die Ihre Abhängigkeit von der Captive Portal Erkennung verringern können. Wenn sich Ihre Infrastruktur in diese Richtung entwickelt, lohnt es sich zu sehen, wie Purple in Ihren bestehenden Netzwerk-Stack und Ihre Onboarding-Richtlinien passt.