
Pourquoi notre WiFi invité est-il si lent ? Diagnostiquer la congestion du réseau
Ce guide diagnostique les facteurs cachés de la congestion du WiFi invité - la télémétrie en arrière-plan, les réseaux publicitaires programmatiques et les mises à jour automatiques du système d'exploitation - qui consomment collectivement jusqu'à 40 % de la bande passante du WiFi public avant même qu'un invité n'ouvre un navigateur. Il fournit un cadre de mise en œuvre progressif et indépendant des fournisseurs pour le filtrage DNS et les politiques de QoS qui récupèrent cette bande passante, améliorent l'expérience des invités et génèrent un ROI mesurable. Destiné aux directeurs informatiques et aux directeurs des opérations dans les secteurs de l'hôtellerie, du commerce de détail, de l'événementiel et du secteur public.
Video overview
Écouter ce guide
Voir la transcription du podcast
Fait partie de notre série principale : Guide du WiFi invité →
Synthèse
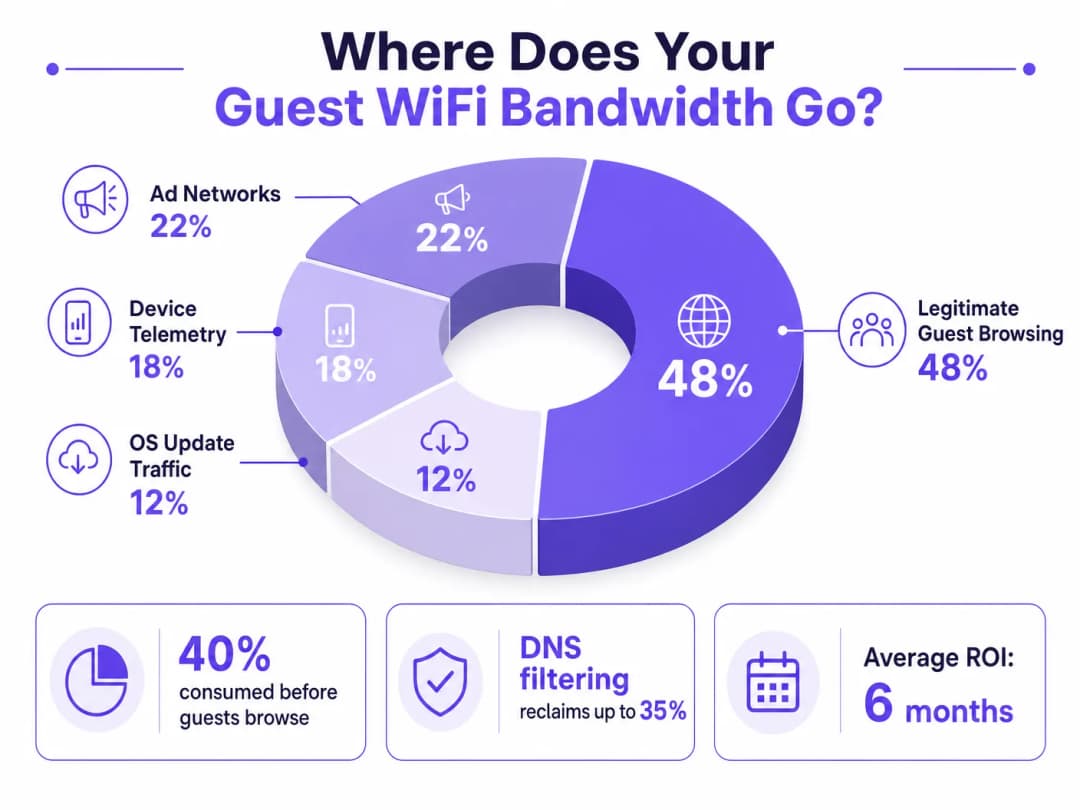
Pour les directeurs informatiques et les responsables des opérations qui gèrent des sites à haute densité, garantir une expérience de WiFi invité fiable est un combat permanent contre la congestion du réseau. Alors que les approches traditionnelles se concentrent sur l'augmentation de la bande passante globale ou le déploiement de points d'accès supplémentaires, la cause profonde des débits lents ne réside pas souvent dans le trafic utilisateur légitime, mais dans la couche cachée des données de fond. Dans les environnements modernes - des complexes hôteliers d'envergure (Hospitality) aux espaces de vente à forte fréquentation (Retail) - jusqu'à 40 % de la bande passante du WiFi public est consommée par la télémétrie des appareils, les réseaux publicitaires programmatiques et les mises à jour automatiques du système d'exploitation avant même qu'un invité n'ouvre un navigateur.
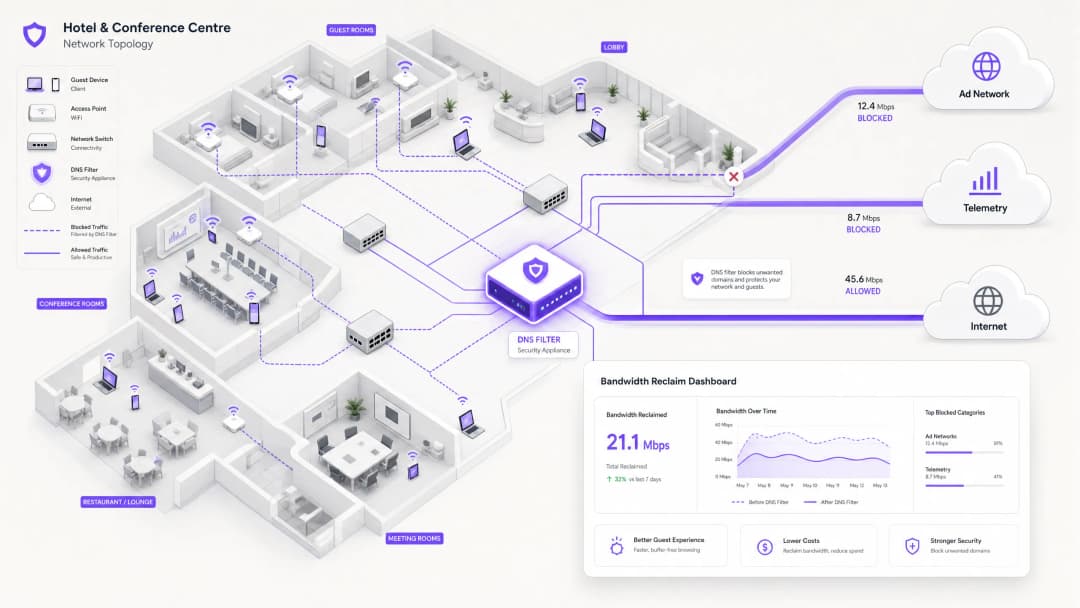
Ce guide de référence technique fournit une méthodologie définitive pour diagnostiquer cette congestion et mettre en œuvre une atténuation stratégique. En déployant un filtrage DNS au niveau du réseau et des zones de politique de réponse (RPZ), les architectes réseau d'entreprise peuvent récupérer une bande passante importante, réduire la latence et améliorer considérablement l'expérience de l'utilisateur final sans engager de dépenses d'investissement dans des mises à niveau d'infrastructure. Nous explorerons l'architecture technique de ces solutions, des études de cas d'implémentation concrètes et le ROI mesurable de la récupération de votre réseau.
Analyse technique approfondie
L'anatomie de la congestion en arrière-plan
Lorsqu'un appareil invité s'authentifie sur un réseau public, il lance immédiatement une multitude de connexions en arrière-plan. Ces connexions sont principalement générées par trois catégories de trafic qui, cumulées, constituent ce que les ingénieurs réseau appellent la charge fantôme - de la bande passante consommée par le réseau avant même qu'une quelconque activité délibérée de l'invité ne commence.
1. Télémétrie et analyses des appareils
Les systèmes d'exploitation modernes (iOS, Android, Windows) et les applications installées transmettent en permanence des données d'utilisation, des mesures de localisation, des rapports de plantage et des analyses comportementales vers des serveurs distants. Dans un environnement dense tel qu'un pôle de Transport ou un centre de conférence, des milliers d'appareils transmettant simultanément des charges utiles de télémétrie faibles mais fréquentes peuvent saturer le temps d'antenne sans fil disponible et surcharger les tables NAT. Un seul appareil iOS peut générer plus de 200 requêtes DNS d'arrière-plan distinctes au cours des 60 premières secondes de connexion à un réseau non mesuré.
2. Réseaux publicitaires programmatiques
De nombreuses applications gratuites s'appuient sur des écosystèmes de publicité programmatique. Dès qu'un appareil détecte une connexion WiFi non mesurée, ces applications commencent à pré-télécharger des publicités vidéo, des bannières d'affichage haute résolution et des scripts de suivi à partir des plateformes d'échange publicitaire. Ce trafic est à la fois gourmand en bande passante et sensible à la latence, et il entrera agressivement en concurrence pour le temps d'antenne avec la navigation légitime des invités. L'analyse des réseaux de lieux publics montre systématiquement que le trafic publicitaire programmatique représente 15 à 22 % de l'utilisation totale du WAN pendant les heures de pointe.
3. Mises à jour automatisées du système d'exploitation et des applications
Sans un lissage du trafic approprié, les appareils tenteront de télécharger d'importants correctifs de système d'exploitation et des mises à jour d'applications dès qu'ils détecteront une connexion WiFi non mesurée. Une seule mise à jour majeure d'iOS peut représenter 3 à 5 Go. Dans un environnement de 500 appareils, le déclenchement d'une mise à jour simultanée - fréquente lors de la sortie d'une nouvelle version du système d'exploitation - peut saturer même une liaison WAN de 1 Gbps en quelques minutes.
Pourquoi les approches traditionnelles échouent
La réponse conventionnelle à la congestion du WiFi invité consiste à augmenter la bande passante WAN ou à déployer des points d'accès supplémentaires. Bien que ces deux mesures aient leur utilité, aucune ne traite la charge fantôme. Augmenter la bande passante offre simplement plus de capacité à consommer pour le trafic d'arrière-plan. Le Deep Packet Inspection (DPI), l'autre outil traditionnel, est de moins en moins efficace : l'adoption généralisée de TLS 1.3 et du chiffrement de bout en bout signifie que la majorité des charges utiles de trafic sont opaques pour les moteurs d'inspection. Vous ne pouvez pas limiter ce que vous ne pouvez pas classifier.
Pour une discussion plus large sur la façon dont les fréquences sans fil interagissent avec les déploiements à haute densité, consultez notre guide sur Fréquences WiFi : un guide des fréquences WiFi en 2026.
Le filtrage DNS : La contre-mesure efficace
La solution moderne et évolutive réside dans le filtrage DNS en périphérie du réseau. Plutôt que d'inspecter le contenu du trafic, le filtrage DNS opère au niveau de la couche de résolution - empêchant ainsi l'établissement des connexions dès le départ.
Lorsqu'un appareil demande l'accès à un réseau publicitaire ou à un domaine de télémétrie connu, le résolveur DNS vérifie la requête par rapport à une Zone de Politique de Réponse (RPZ). Si le domaine figure sur la liste de blocage, le résolveur renvoie une réponse NXDOMAIN (domaine inexistant), ou redirige le trafic vers une adresse IP nulle locale. La connexion est interrompue avant que la liaison TCP n'ait lieu, préservant à la fois le temps d'antenne sans fil et la bande passante WAN. Cette approche est peu exigeante en ressources informatiques, évolue de manière linéaire avec la capacité du résolveur, et n'est pas affectée par le chiffrement des données.

La dimension de sécurité
Le filtrage DNS offre un avantage secondaire majeur : la sécurité. En bloquant les domaines de commande et de contrôle (C2) de logiciels malveillants connus, les infrastructures de phishing et les réseaux de diffusion de kits d'exploitation au niveau de la couche DNS, le réseau WiFi invités devient nettement plus facile à défendre. Cela est directement lié aux obligations de conformité dans le cadre de référentiels tels que PCI-DSS (qui exige la segmentation et la surveillance du réseau pour les environnements de données de titulaires de cartes) et le GDPR (qui impose des mesures techniques appropriées pour protéger les données personnelles). Pour une analyse détaillée des exigences en matière de piste d'audit dans ce contexte, voir Explain what is audit trail for IT Security in 2026.
Pour les organisations qui gèrent des environnements éducatifs où le blocage des publicités sert également de fonction de protection des mineurs, les principes abordés dans Minimising Student Distractions with Network-Level Ad Blocking sont directement applicables.
Vous avez des questions sur votre configuration spécifique ?
Notre équipe collabore avec des exploitants de sites, des responsables informatiques et des ingénieurs réseau au sein de 80 000 sites. Réservez un appel de 20 minutes et nous vous montrerons comment d'autres professionnels comme vous ont résolu ce problème.
Guide d'implémentation
Le déploiement d'une architecture de filtrage DNS robuste nécessite une planification minutieuse afin d'éviter d'interrompre les services légitimes pour les invités. L'implémentation doit suivre une approche progressive.
Phase 1 : Évaluation de référence et visibilité
Avant de mettre en place des blocages, établissez une référence des profils de trafic actuels. Utilisez WiFi Analytics pour identifier les domaines et les catégories les plus gourmands en bande passante sur une période représentative de 7 à 14 jours. Cette phase d'audit est essentielle pour comprendre le profil de trafic spécifique de votre établissement et pour justifier l'investissement. Les indicateurs clés à recueillir sont les suivants :
| Indicateur | Référence cible | Notes |
|---|---|---|
| Top 20 des domaines DNS par volume de requêtes | Liste complète | Identifier les domaines de télémétrie et de publicité |
| Utilisation du WAN par catégorie | % de répartition | Quantifier la charge fantôme |
| Nombre maximal d'appareils simultanés | Nombre | Dimensionner l'infrastructure du résolveur |
| Taux d'échec des requêtes DNS | < 0,1% | Établir un point de référence avant le déploiement |
Phase 2 : Déploiement progressif de la RPZ
Commencez par déployer la RPZ en mode journalisation uniquement. Cela vous permet de vérifier l'exactitude de vos listes de blocage sans impact sur l'expérience utilisateur. Concentrez-vous d'abord sur les catégories à haut niveau de confiance :
- Malwares connus et domaines C2 : Bénéfice de sécurité immédiat avec un risque quasi nul de faux positifs. Utilisez des flux de renseignements sur les menaces provenant de fournisseurs réputés.
- Réseaux publicitaires programmatiques à large bande passante : Ciblez les principales plateformes d'échange de publicités vidéo. Celles-ci sont bien documentées et peu susceptibles d'héberger du contenu légitime.
- Points de terminaison de télémétrie agressifs : Bloquez les domaines de suivi non essentiels. Maintenez une liste d'autorisation rigoureuse pour les domaines requis pour les flux d'authentification du Captive Portal.
Une fois que le mode journalisation uniquement confirme des taux de faux positifs acceptables (cible < 0,5% des requêtes), passez au mode application.
Phase 3 : Façonnage du trafic et intégration de la QoS
Pour le trafic qui ne peut pas être bloqué d'emblée (par exemple, les mises à jour logicielles de Apple, Microsoft et Google), mettez en œuvre des politiques de Quality of Service (QoS). Limitez le débit des serveurs de mise à jour à un plafond défini - généralement 10 à 15 % de la capacité WAN totale - afin de garantir que le trafic invité interactif (navigation web, VoIP, visioconférence) bénéficie d'une file d'attente prioritaire. Ceci est particulièrement important pour les environnements de Santé où le personnel clinique peut partager un segment de réseau avec les invités.
Pour obtenir des conseils sur l'optimisation des environnements réseau plus larges, y compris les déploiements de bureaux et d'activités mixtes, consultez WiFi de bureau : Optimiser votre réseau WiFi de bureau moderne.
Bonnes pratiques
Maintenez des listes d'autorisation explicites pour les services critiques. Assurez-vous que les domaines essentiels pour l'authentification du Captive Portal, les passerelles de paiement (conformité PCI-DSS) et les opérations commerciales de base soient explicitement autorisés. Une liste de blocage mal configurée qui interrompt le flux de connexion générera immédiatement une charge d'assistance importante.
Communiquez la politique de manière transparente. Vos Conditions d'utilisation doivent stipuler que le trafic réseau est géré afin de garantir une expérience de haute qualité pour tous les utilisateurs. Il s'agit à la fois d'une bonne pratique juridique au regard du GDPR et d'une mesure raisonnable pour définir les attentes des invités.
Automatisez les mises à jour des listes de blocage. Le paysage des réseaux publicitaires et des domaines de télémétrie évolue constamment. Les flux de renseignements sur les menaces et les listes RPZ doivent être mis à jour de manière dynamique - idéalement sur un cycle de moins de 24 heures - pour rester efficaces.
Gérez l'évitement du DNS de manière proactive. Mettez en œuvre des règles de pare-feu pour intercepter et rediriger tout le trafic sortant du port 53 (UDP et TCP) vers le résolveur local. Cela empêche les clients de contourner le filtrage en codant en dur des serveurs DNS externes.
Planifiez pour le DNS over HTTPS (DoH). À mesure que l'adoption du DoH progresse, les clients peuvent acheminer les requêtes DNS via HTTPS pour contourner complètement les résolveurs locaux. Évaluez s'il convient de bloquer les fournisseurs de DoH connus (par exemple, dns.google, cloudflare-dns.com) ou de déployer un proxy DoH transparent qui applique la politique locale.
Aligner avec IEEE 802.1X et WPA3. Assurez-vous que votre architecture de filtrage DNS est compatible avec votre framework d'authentification. Dans les environnements utilisant IEEE 802.1X avec une authentification basée sur RADIUS, les politiques de filtrage DNS peuvent être appliquées par VLAN ou par groupe d'utilisateurs, permettant ainsi un contrôle granulaire.
Résolution des pannes et atténuation des risques
Modes de défaillance courants
| Mode de défaillance | Symptôme | Atténuation |
|---|---|---|
| Blocage excessif (collision CDN) | Pages web brisées, images manquantes | Listes de blocage granulaires ; processus d'autorisation rapide |
| Contournement DNS (résolveurs codés en dur) | Filtrage contourné par des applications spécifiques | Règles de redirection du pare-feu pour le port 53 |
| Contournement DoH | Filtrage contourné par les navigateurs modernes | Bloquer les fournisseurs DoH connus ou déployer un proxy DoH |
| Goulot d'étranglement des performances du résolveur | Augmentation de la latence DNS pour tous les clients | Mettre à l'échelle l'infrastructure des résolveurs ; implémenter l'Anycast |
| Panne du Captive Portal | Les invités ne peuvent pas s'authentifier | Liste d'autorisation explicite pour les domaines du portail et les points de terminaison de détection d'OS |
| Listes de blocage obsolètes | Nouveaux domaines publicitaires non bloqués | Automatiser les mises à jour des flux ; surveiller les journaux de requêtes pour les nouveaux domaines à volume élevé |
Réponse aux incidents de sécurité
Si un appareil invité est identifié comme communiquant avec un domaine C2 de malware connu (visible dans les journaux de requêtes DNS), la RPZ bloquera automatiquement toute communication ultérieure. Assurez-vous que votre processus de réponse aux incidents comprend un flux de travail pour examiner ces événements, car ils peuvent indiquer un appareil compromis nécessitant une isolation du VLAN invité.
ROI et impact commercial
La mise en œuvre du filtrage DNS au niveau du réseau offre des résultats commerciaux mesurables et quantifiables dans de multiples dimensions.
Récupération de bande passante et report de CapEx. Les sites récupèrent généralement 20 à 40 % de leur bande passante WAN totale. Cela se traduit directement par des économies de coûts en reportant le besoin de mises à niveau de circuits coûteuses. Pour un site payant actuellement pour une ligne louée de 500 Mbps, récupérer 30 % de la capacité équivaut à obtenir 150 Mbps de débit effectif à coût nul.
Amélioration de la satisfaction des invités et du NPS. En éliminant la congestion en arrière-plan, la vitesse et la fiabilité perçues du WiFi invité s'améliorent considérablement. La réduction de la latence et un débit constant entraînent des Net Promoter Scores plus élevés et moins d'escalades vers le support opérationnel.
Posture de sécurité et de conformité renforcée. Le blocage des domaines de malwares et de phishing au niveau de la couche DNS réduit considérablement le risque d'une faille de sécurité provenant du réseau invité. Cela soutient directement la conformité avec les exigences de segmentation réseau du PCI DSS et l'obligation du GDPR de mettre en œuvre des mesures de sécurité techniques appropriées.
Efficacité opérationnelle. Le filtrage DNS automatisé réduit la charge de travail manuelle des équipes d'exploitation réseau. Plutôt que de réagir aux événements de congestion, le réseau gère de manière proactive son propre profil de trafic.
| Résultat | Plage typique | Méthode de mesure |
|---|---|---|
| Bande passante récupérée | 20 à 40 % de la capacité WAN | Surveillance de l'utilisation du WAN avant/après |
| Taux de blocage des requêtes DNS | 15 à 35 % de toutes les requêtes | Journaux de requêtes du résolveur |
| Amélioration de la satisfaction des invités | +8 à 15 points NPS | Enquêtes post-séjour/post-visite |
| Report du CapEx | 1 à 3 ans sur la mise à niveau du circuit | Modélisation des coûts |
| Réduction des incidents de sécurité | 40 à 60 % de détections C2 en moins | Corrélation SIEM |
En traitant le réseau non pas seulement comme un simple canal, mais comme une passerelle intelligente et filtrée, les responsables informatiques peuvent offrir une expérience de connectivité supérieure, sécurisée et rentable - qui s'adapte à la croissance du site sans investissement d'infrastructure proportionnel.
Définitions clés
Response Policy Zone (RPZ)
Un mécanisme dans les serveurs DNS qui permet de modifier les réponses DNS en fonction d'une politique définie. Lorsqu'un domaine interrogé correspond à une entrée dans la RPZ, le résolveur peut renvoyer une réponse synthétique (par exemple, NXDOMAIN ou une IP de sinkhole) au lieu de la réponse réelle.
Le principal mécanisme technique pour mettre en œuvre le filtrage DNS à l'échelle du réseau. Les équipes IT configurent les RPZ sur leurs résolveurs internes pour bloquer les réseaux publicitaires, les domaines malveillants et les points de terminaison de télémétrie sans nécessiter de logiciel côté client.
Inspection approfondie des paquets (DPI)
Une forme de filtrage des paquets réseau qui examine la charge utile des données d'un paquet lorsqu'il passe par un point d'inspection, à la recherche de non-conformités aux protocoles, de contenus spécifiques ou de critères définis.
Traditionnellement utilisé pour la classification et le façonnage du trafic. De plus en plus limité par l'adoption généralisée du chiffrement de bout en bout TLS 1.3, qui rend les charges utiles opaques. Le filtrage DNS est l'alternative privilégiée pour les environnements de trafic chiffré.
NXDOMAIN
Un code de réponse DNS (RCODE 3) indiquant que le nom de domaine interrogé n'existe pas dans l'espace de noms DNS.
Renvoyé par un résolveur DNS de filtrage pour bloquer intentionnellement une connexion vers un domaine indésirable. L'application cliente reçoit cette réponse et abandonne la tentative de connexion, empêchant ainsi toute consommation de bande passante.
DNS over HTTPS (DoH)
Un protocole pour effectuer une résolution DNS via le protocole HTTPS (RFC 8484), chiffrant les requêtes et les réponses DNS entre le client et un résolveur compatible DoH.
Peut contourner le filtrage DNS du réseau local si les clients sont configurés pour utiliser des fournisseurs DoH externes. Les administrateurs réseau doivent implémenter des règles de pare-feu ou acheminer le trafic DoH via un proxy pour appliquer les politiques RPZ locales.
Qualité de Service (QoS)
Un ensemble de mécanismes réseau qui contrôlent la priorisation du trafic, la limitation du débit et la mise en file d'attente afin de garantir les performances des applications critiques.
Utilisé en complément du filtrage DNS pour gérer le trafic légitime mais gourmand en bande passante (par exemple, les mises à jour d'OS) qui ne peut pas être bloqué. La QoS garantit que le trafic interactif des invités est prioritaire sur les transferts de masse en arrière-plan.
Télémétrie
La collecte et la transmission automatisées de données opérationnelles depuis des appareils vers des serveurs distants à des fins de surveillance, d'analyse et de diagnostic.
Dans le contexte du WiFi invité, la télémétrie des appareils provenant des systèmes d'exploitation mobiles et des applications peut consommer silencieusement 15 à 20 % de la bande passante disponible. C'est une cible prioritaire pour le filtrage DNS dans les déploiements de réseaux publics.
DNS Sinkholing
Une technique dans laquelle un serveur DNS est configuré pour renvoyer une fausse adresse IP (généralement une adresse nulle locale) pour des domaines spécifiques, redirigeant ainsi le trafic loin de sa destination prévue.
Utilisé pour neutraliser le trafic C2 des logiciels malveillants et bloquer de manière agressive les réseaux publicitaires gourmands en bande passante. Plus définitif que les réponses NXDOMAIN, car il permet au serveur sinkhole d'enregistrer les tentatives de connexion pour une analyse de sécurité.
Équité du temps d'antenne
Une fonctionnalité de réseau sans fil qui attribue un accès égal au support sans fil à tous les clients connectés, quels que soient leurs débits de données individuels.
Crucial dans les environnements à forte densité. Sans équité du temps d'antenne, un seul appareil lent (par exemple, un client 802.11g plus ancien) peut consommer le temps d'antenne de manière disproportionnée, dégradant le débit pour tous les autres clients. Le trafic de télémétrie en arrière-plan provenant de nombreux appareils exacerbe cet effet.
Charge fantôme
Bande passante consommée par des processus automatisés en arrière-plan sur les appareils connectés avant toute activité volontaire de l'utilisateur.
Le terme collectif désignant la télémétrie, le pré-chargement des réseaux publicitaires et le trafic de mise à jour des OS. Comprendre et quantifier la charge fantôme est la première étape de tout diagnostic de congestion du WiFi invité.
Exemples concrets
Un hôtel de type resort de 400 chambres subit une grave congestion du réseau tous les soirs entre 19h00 et 22h00. La liaison WAN de 1 Gbps est saturée et les clients se plaignent de la lenteur du streaming et de coupures lors des appels VoIP. Le directeur informatique doit identifier la cause profonde et mettre en œuvre une solution sans augmenter le débit du circuit.
Étape 1 - Analyse du trafic : Déployer un analyseur de flux réseau (NetFlow/IPFIX) sur le routeur central et l'exécuter pendant 5 jours sur les périodes de pointe et creuses. Corréler avec les journaux de requêtes DNS du résolveur existant. L'analyse révèle que 35 % du trafic du soir est destiné à des réseaux publicitaires vidéo programmatiques connus (DoubleClick, AppNexus) et à des serveurs de mise à jour automatique d'applications (Apple Software Update, Google Play). La navigation légitime des invités ne représente que 52 % du trafic total.
Étape 2 - Déploiement du filtrage DNS : Configurer le pare-feu central pour rediriger toutes les requêtes DNS du VLAN invité (port UDP/TCP 53) vers un résolveur local compatible RPZ. Importer une liste de blocage contenant les réseaux publicitaires et les domaines de télémétrie identifiés. Exécuter en mode journalisation uniquement pendant 48 heures pour valider les taux de faux positifs.
Étape 3 - Application des politiques : Après avoir validé un taux de faux positifs inférieur à 0,3 %, passer en mode d'application. Simultanément, mettre en œuvre une politique de QoS qui limite le débit des serveurs de mise à jour Apple et Google à un plafond combiné de 80 Mbps pendant la tranche horaire de 18h00 à 23h00.
Étape 4 - Validation : Surveiller l'utilisation du WAN au cours des 7 jours suivants. L'utilisation maximale passe de 98 % à 61 %, résolvant ainsi les plaintes des invités. L'hôtel reporte une mise à niveau planifiée du circuit d'environ 18 mois.
Un grand centre de conférences accueille un sommet technologique avec 5 000 participants. Pendant le discours d'ouverture, le réseau WiFi devient complètement inutilisable. L'analyse post-incident montre que des milliers d'appareils ont tenté simultanément de télécharger une mise à jour majeure d'iOS publiée le matin même.
Atténuation immédiate (jour de l'événement) : L'équipe des opérations réseau identifie la surcharge grâce à la surveillance en temps réel des requêtes DNS. Elle bloque immédiatement (via redirection sinkhole) les domaines spécifiques de mise à jour logicielle Apple (mesu.apple.com, appldnld.apple.com, updates.cdn-apple.com) au niveau de la couche DNS. En l'espace de 4 minutes, l'utilisation du WAN chute de 99 % à 68 % et le réseau se stabilise.
Solution à court terme (même événement) : Une politique de QoS est appliquée pour limiter le débit de l'ensemble du trafic de mise à jour restant à 50 Mbps pour la durée de l'événement.
Stratégie à long terme (après l'événement) : L'équipe réseau met en œuvre une politique de QoS dynamique qui s'active automatiquement lorsque l'utilisation totale du WAN dépasse 75 %, limitant les serveurs de mise à jour connus à 10 % de la capacité totale. Une liste de contrôle pré-événement est créée, incluant des redirections sinkhole temporaires des principaux domaines de mise à jour pendant les 2 heures précédant et suivant les sessions à forte affluence. L'équipe s'abonne également aux flux de notification de sortie des mises à jour d'Apple et de Microsoft afin d'anticiper les futurs pics d'activité.
Questions d'entraînement
Q1. Vous êtes le responsable informatique d'une chaîne nationale de vente au détail. Après avoir déployé une solution de filtrage DNS dans 50 magasins, plusieurs directeurs de magasin signalent que la page de connexion du Captive Portal ne se charge pas pour les invités. L'équipe d'assistance reçoit un volume d'appels très élevé. Quelle est la cause la plus probable et quelle est la mesure corrective immédiate ?
Conseil : Prenez en compte l'ensemble de la chaîne de dépendance d'un flux d'authentification de Captive Portal moderne, y compris les mécanismes de détection de Captive Portal au niveau du système d'exploitation.
Voir la réponse type
La cause la plus probable est un blocage excessif. Le filtre DNS bloque un domaine requis pour le bon fonctionnement du Captive Portal. Les systèmes d'exploitation mobiles modernes utilisent des domaines spécifiques pour détecter les Captive Portals (par exemple, captive.apple.com pour iOS, connectivitycheck.gstatic.com pour Android). Si ces domaines sont bloqués, le système d'exploitation ne déclenchera pas le navigateur du Captive Portal, et l'invité ne verra aucune invite de connexion. De plus, le portail lui-même peut dépendre d'un CDN ou d'un fournisseur d'authentification tiers (par exemple, connexion via les réseaux sociaux avec Facebook ou Google) dont les domaines sont bloqués par inadvertance.
Correction immédiate : examinez les journaux de requêtes DNS pour identifier les réponses NXDOMAIN provenant du sous-réseau invité pendant la phase d'authentification. Identifiez tous les domaines bloqués qui font l'objet d'une requête avant une connexion réussie. Ajoutez ces domaines à la liste d'autorisation globale. Implémentez un modèle standard de liste d'autorisation pour les déploiements de Captive Portal qui inclut tous les principaux points de terminaison de détection des systèmes d'exploitation et les domaines des fournisseurs d'authentification courants.
Q2. L'architecte réseau d'un stade constate que, malgré la mise en œuvre d'un filtrage DNS agressif, l'utilisation du réseau étendu (WAN) reste extrêmement élevée pendant les matchs. Une enquête plus approfondie révèle un volume élevé et soutenu de trafic sur le port UDP 443 qui ne correspond à aucun domaine bloqué dans les journaux DNS. Que se passe-t-il et comment résoudre ce problème ?
Conseil : Prenez en compte les protocoles de transport modernes et la manière dont ils interagissent avec les contrôles au niveau de la couche DNS.
Voir la réponse type
Le volume élevé de trafic UDP 443 indique l'utilisation de QUIC (HTTP/3). QUIC est un protocole de transport basé sur UDP utilisé par les grandes plateformes (Google, Meta, YouTube) qui contourne les proxys traditionnels basés sur TCP et les moteurs DPI. Plus important encore, les clients utilisant QUIC peuvent également utiliser le DNS sur HTTPS (DoH) pour résoudre les domaines, contournant ainsi complètement le résolveur RPZ local et rendant le filtrage DNS inefficace pour ces clients.
Pour y remédier : tout d'abord, mettez en place des règles de pare-feu pour bloquer le trafic DoH sortant vers les fournisseurs de DoH publics connus (Google, Cloudflare, NextDNS) sur le port TCP/UDP 443 par IP de destination, forçant ainsi les clients à se rabattre sur le résolveur local. Deuxièmement, évaluez la possibilité de bloquer complètement le trafic UDP 443 sortant (ou de limiter son débit de manière agressive) pour forcer les clients QUIC à se rabattre sur HTTP/2 basé sur TCP, qui est soumis aux politiques de gestion du trafic existantes. Troisièmement, examinez si un proxy DoH transparent peut être déployé pour intercepter et inspecter les requêtes DoH tout en appliquant les politiques RPZ locales.
Q3. Vous concevez une politique de QoS pour le réseau WiFi invité d'un grand hôpital public. Le réseau est partagé entre les appareils de divertissement des patients, les appareils personnels des visiteurs et un petit nombre de membres du personnel clinique utilisant des softphones VoIP sur leurs mobiles personnels. Hiérarchisez les types de trafic suivants : VoIP (SIP/RTP), navigation Web des invités (HTTP/HTTPS), mises à jour Windows/iOS et streaming vidéo (Netflix/YouTube).
Conseil : Prenez en compte à la fois la sensibilité à la latence et l'impact commercial ou clinique de chaque type de trafic. Considérez également le contexte réglementaire d'un environnement de santé.
Voir la réponse type
Priorité 1 - VoIP (SIP/RTP) : File d'attente à priorité stricte (Expedited Forwarding, DSCP EF). La VoIP est extrêmement sensible à la latence (cible < 150 ms aller simple) et à la gigue (cible < 30 ms). Une perte de paquets supérieure à 1 % entraîne une dégradation audible. Dans un contexte clinique, un appel interrompu pourrait avoir des répercussions sur la sécurité des patients.
Priorité 2 - Navigation Web invité (HTTP/HTTPS) : Assured Forwarding (AF31). Il s'agit du principal cas d'utilisation attendu pour les patients et les visiteurs. Il requiert une réactivité raisonnable mais tolère une latence modérée.
Priorité 3 - Streaming vidéo (Netflix/YouTube) : Débit limité par client (par exemple, un plafond de 3 à 5 Mbps) avec Assured Forwarding (AF21). Bien qu'il soit important pour l'expérience des patients lors de longs séjours, un streaming sans restriction saturera la liaison. Un plafond par client garantit un accès équitable. Envisagez des politiques horaires qui assouplissent les limites pendant les heures creuses.
Priorité 4 - Mises à jour d'OS/applications (classe Scavenger, DSCP CS1) : Priorité la plus basse, file d'attente au mieux (best-effort), avec une limite de débit globale (par exemple, 50 Mbps au total pour tout le trafic de mise à jour). Il s'agit de tâches d'arrière-plan sans sensibilité à la latence. Elles ne doivent consommer que la capacité excédentaire. Dans un environnement de santé, déterminez également si le réseau WiFi invité est totalement isolé des systèmes cliniques - si ce n'est pas le cas, la gestion du trafic de mise à jour devient un enjeu de sécurité autant que de bande passante.
Continuer la lecture de cette série
Guide étape par étape pour diagnostiquer les problèmes de roaming WiFi
Ce guide complet fournit aux responsables informatiques et architectes réseau d'entreprise une méthodologie faisant autorité, étape par étape, pour diagnostiquer et résoudre les problèmes de roaming WiFi. En combinant des analyses techniques approfondies des normes IEEE 802.11k/v/r avec des études de cas réels et des analyses de paquets, ce document de référence permet aux équipes d'éliminer le problème du « client collant » et d'offrir une connectivité mobile fluide. Il couvre l'ensemble du flux de diagnostic, depuis les audits de couverture radio (RF) et de configuration des contrôleurs jusqu'à l'analyse des captures de paquets à l'antenne (OTA) et la validation post-résolution.
Pourquoi le WiFi de votre stade est saturé (et comment y remédier)
Ce guide technique de référence analyse la cause principale de la saturation du WiFi dans les stades - l'activité d'arrière-plan simultanée de 50 000 appareils chargeant des publicités programmatiques et des données de télémétrie - et fournit un schéma d'architecture détaillé pour déployer le filtrage DNS à la périphérie comme principale stratégie d'atténuation. Conçu pour les directeurs informatiques, les CTO et les architectes réseau, il offre des conseils de mise en œuvre concrets, des études de cas réels et des modèles de calcul du ROI pour aider les exploitants de sites à récupérer de la bande passante et à offrir une connectivité haute performance à grande échelle.
Résoudre l'erreur connecté mais pas d'accès internet sur un WiFi invité
Ce guide de référence technique explique comment les expirations DNS causées par des réseaux saturés déclenchent l'erreur "Connecté, pas d'Internet" sur le WiFi invité. Il fournit aux architectes réseau et aux responsables IT des étapes concrètes pour déployer des filtres DNS d'entreprise afin de résoudre ces goulots d'étranglement et d'améliorer l'intégration des invités.
Vous avez des questions sur votre configuration spécifique ?
Notre équipe collabore avec des exploitants de sites, des responsables informatiques et des ingénieurs réseau au sein de 80 000 sites. Réservez un appel de 20 minutes et nous vous montrerons comment d'autres professionnels comme vous ont résolu ce problème.