Liga-se a um SSID de convidados, o portátil indica que está ligado, o telemóvel não abre nada, o Windows reporta conectividade limitada e o suporte técnico é culpado por um “portal avariado”. Na maioria das vezes, a página do portal não é o primeiro problema. A deteção de Captive Portal é.
Essa distinção importa mais agora do que há uns anos. Em infraestruturas mistas no Reino Unido, o fluxo de trabalho de deteção afeta a experiência do utilizador, o comportamento de segurança do endpoint, o registo de logs e a estabilidade das ferramentas zero-trust durante a integração. Se encarar isto apenas como "aquilo que faz aparecer a splash page", irá perder as falhas que deixam os utilizadores sem ligação.
O que a Deteção de Captive Portal Realmente Faz
Um Captive Portal não começa com a página do portal. Começa com a decisão do cliente sobre se a rede tem acesso irrestrito à Internet.
Quando um dispositivo se junta ao WiFi, o sistema operativo envia normalmente um pedido HTTP em segundo plano para um endpoint controlado pelo fabricante. Se a resposta corresponder ao que o cliente espera, o dispositivo assume que tem acesso aberto à internet e permanece em silêncio. Se a resposta for redirecionada, modificada ou bloqueada, o SO decide que provavelmente existe um portal e abre um fluxo de início de sessão.
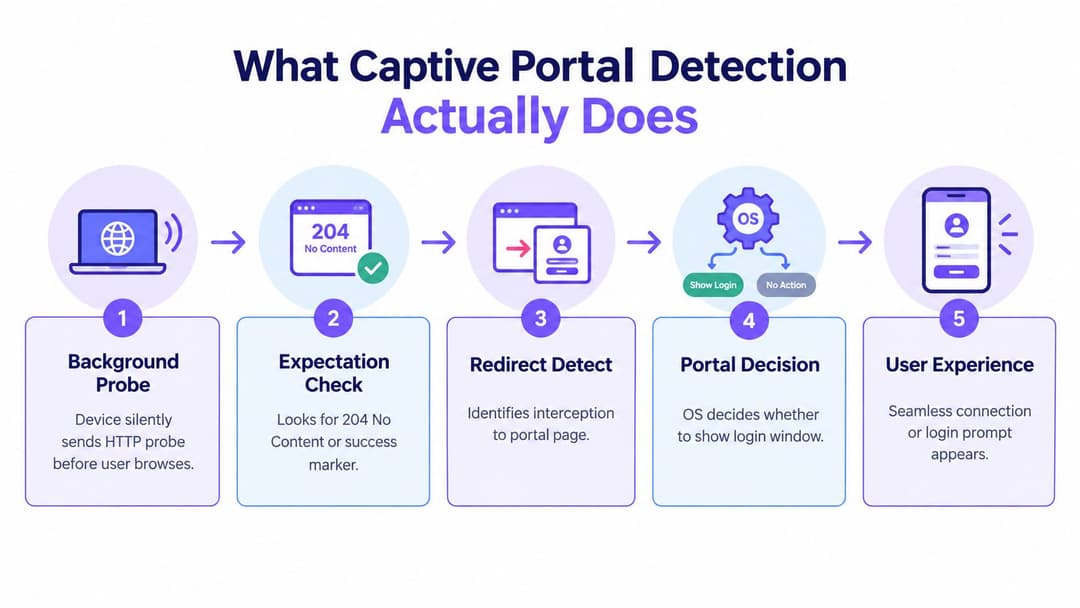
A deteção é a porta de entrada, não o início de sessão
Esta é a parte que muitas equipas confundem:
- Deteção decide se o utilizador deve de todo ver um portal.
- Autenticação decide se esse utilizador tem permissão para passar.
- Autorização decide o que esse utilizador pode aceder depois.
Se a deteção falhar, o portal pode estar perfeitamente operacional e ninguém o verá. Se a deteção for bem-sucedida mas a autenticação falhar, os utilizadores verão a página e continuarão sem acesso. São falhas diferentes, com resoluções diferentes.
Um modelo mental útil é tratar a deteção de Captive Portal como um veredicto de conectividade impulsionado pelo sistema operativo. O navegador não está a liderar. O sistema operativo está.
Por que razão isto é importante em redes reais
Isto não é um caso isolado de nicho. Um estudo sobre hotspots descobriu que 484 redes alcançaram o primeiro teste de deteção de Captive Portal, e 390 redes distintas estavam a usar alguma forma de Captive Portal, mostrando que a deteção de portal já estava ativa à escala real de implementação e não apenas em ambientes laboratoriais (resumo do estudo).
Essa escala importa porque cada uma dessas redes dependia de os clientes interpretarem corretamente as respostas aos testes de deteção. Na prática, isto significa que a experiência do utilizador depende de uma troca muito pequena: um código de estado, um corpo de resposta ou um redirecionamento.
Regra prática: Se os utilizadores disserem que “o portal não apareceu”, inspecione o caminho do teste antes de inspecionar a página do portal.
Por que razão o problema mudou
A resolução de problemas em hotspots mais antigos focava-se em fazer carregar a página de boas-vindas. Isso ainda faz parte do trabalho, mas as infraestruturas modernas têm outra camada. Os agentes de segurança, os clientes VPN e as ferramentas de onboarding também reagem quando consideram que existe um Captive Portal. A Mozilla documenta que o Firefox verifica endpoints de portal dedicados antes de abrir uma página de início de sessão, enquanto a Cloudflare refere que o seu cliente pode enviar múltiplos pedidos de portal específicos do SO e pode abrir totalmente a firewall do sistema até que o onboarding seja concluído, o que transforma a deteção num problema de fiabilidade e segurança de endpoint, e não apenas num problema de início de sessão (Mozilla captive portal support article).
É por isso que as equipas maduras fazem agora duas perguntas, e não apenas uma. Primeiro, a rede consegue acionar o portal de forma consistente? Segundo, deverá esta infraestrutura ainda depender desse fluxo de trabalho como principal método de acesso?
Sondas Principais e Heurísticas por Trás de uma Deteção Fiável
Um cliente junta-se ao WiFi, obtém DHCP, mostra bom sinal e, mesmo assim, reporta "Sem Internet" ou nunca abre a janela de início de sessão. Em quase todos os casos, o problema reside no caminho do teste de deteção, não na página do portal.
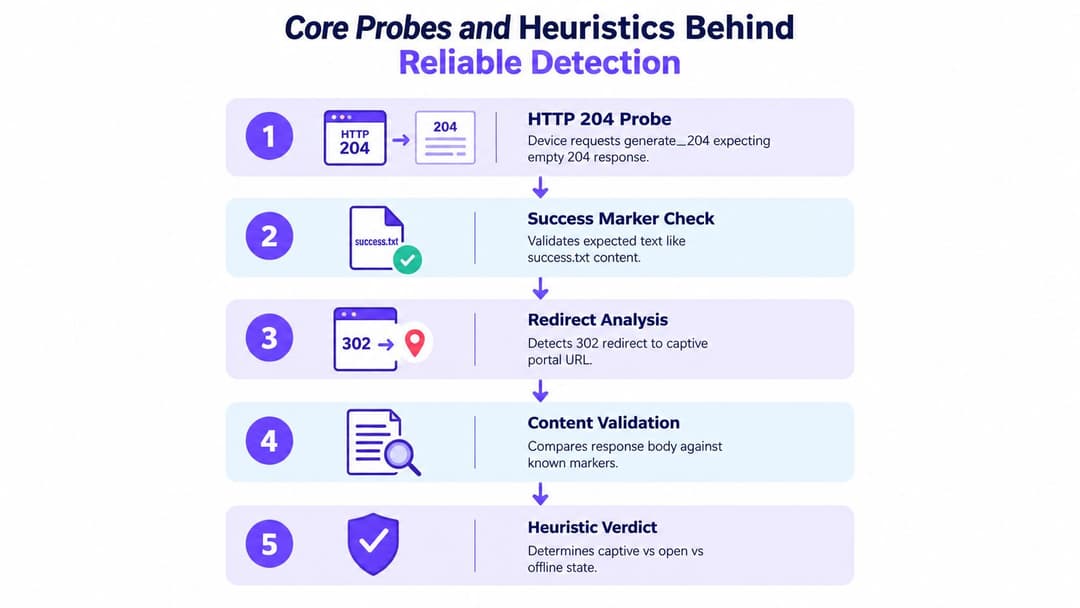
O que os clientes estão realmente a verificar
A deteção de Captive Portal é um pequeno motor de decisão integrado no SO ou no agente do cliente. O dispositivo envia um pedido conhecido para um endpoint conhecido, compara a resposta com um resultado esperado e, em seguida, decide se a rede está online, cativa ou avariada. O utilizador pode apenas ver um browser pop-up, mas o trabalho aconteceu alguns pacotes antes.
Os alvos de sondagem comuns incluem o captive.apple.com da Apple, o connectivitycheck.gstatic.com e o clients3.google.com/generate_204 da Google, o msftconnecttest.com/connecttest.txt da Microsoft, e o detectportal.firefox.com do Firefox. O gatilho não é apenas o nome de anfitrião. É a combinação do código de estado, cabeçalhos, conteúdo do corpo, comportamento de redirecionamento e temporização, como observado na visão geral do portal hotspot da DrayTek.
A lógica assemelha-se normalmente a isto:
- O cliente envia um teste (probe)
- A rede permite a passagem ou interceta-o
- O cliente compara a resposta com o seu padrão esperado
- O cliente classifica o estado da rede
- O SO ou o agente decide se deve iniciar um fluxo de Captive Portal, avisar o utilizador ou permanecer silencioso
Esse último passo importa mais do que muitas equipas esperam. Agentes de segurança, clientes VPN e ferramentas de integração baseiam-se frequentemente no mesmo veredicto. Uma resposta de teste incorreta pode quebrar o acesso, atrasar verificações de postura de segurança ou deixar o endpoint num estado estranho de meia ligação.
O que quebra a deteção com mais frequência
Os modos de falha comuns são aborrecidos, repetíveis e fáceis de perder durante um teste rápido de navegador.
- Estado HTTP incorreto: As verificações da família Android esperam frequentemente um
204 No Content. Retornar uma página de marca com200 OKpode fazer com que o cliente classifique a rede como cativa, avariada ou instável. - Conteúdo do corpo incorreto: O Windows e outras pilhas podem procurar marcadores de texto simples exatos. Banners de proxy, HTML reescrito ou funcionalidades de injeção de conteúdo podem quebrar essa correspondência.
- Erros de redirecionamento: Um redirecionamento claro para o portal é aceitável. Redirecionamentos em cadeia, loops ou redirecionamentos que alternam entre HTTP e HTTPS causam frequentemente falhas silenciosas.
- Interferência de DNS: Sequestro de DNS, split-horizon DNS ou resolvedores recursivos que respondem de forma inconsistente podem enviar sondagens para onde o cliente não esperava.
- Interceção TLS: A filtragem HTTPS e a substituição de certificados causam regularmente reclamações de "ligado, sem internet" porque o cliente já não confia no resultado da sondagem.
- Problemas de temporização e acessibilidade: DNS upstream lento, CDNs bloqueados para recursos do portal ou a falta de listas de permissão para fornecedores de identidade podem fazer com que a deteção oscile entre estados.
Uma verificação prática de implementação consiste em criar primeiro a lista de permissões de pré-autenticação e testá-la separadamente. Ferramentas como o gerador de walled garden do Purple para domínios de Captive Portal e dependências ajudam a identificar hosts de teste, recursos do portal, redirecionamentos de identidade e destinos pós-autenticação que necessitam de um tratamento diferente.
Uma falha ambígua aumenta a fila de tickets. Uma falha clara é mais fácil de diagnosticar.
Por que razão as heurísticas são frágeis
Estas verificações são frágeis porque foram concebidas para inferir o estado da rede a partir de uma troca mínima, frequentemente antes de o dispositivo ter acesso total. Pequenas alterações na filtragem de conteúdos, inspeção SSL, reverse proxies ou políticas de firewall podem alterar o resultado sem que ninguém toque no portal em si.
Vejo isto com mais frequência em SSIDs de convidados e de integração empresarial, onde várias equipas são proprietárias de diferentes partes do caminho. A equipa de rede sem fios vê a associação ser bem-sucedida. A equipa de firewall vê uma política de redirecionamento permitida. A equipa de segurança vê a inspeção HTTPS a funcionar como pretendido. O endpoint apenas vê uma resposta de sonda que já não corresponde ao que solicitou.
É por isso que a deteção de Captive Portal deve ser tratada como um controlo de fiabilidade e de segurança do endpoint, e não apenas como uma funcionalidade de conveniência que abre uma página de início de sessão. Se a deteção for pouco fiável, os utilizadores não conseguem efetuar a integração, os agentes de segurança podem interpretar incorretamente a acessibilidade e as equipas de suporte acabam por resolver problemas na camada errada.
Isto também explica por que razão algumas infraestruturas devem deixar de depender de fluxos de trabalho captive como o método de acesso principal. Para acesso de convidados BYOD, visitantes de curta duração e integração de sistemas legados, a deteção de portal ainda tem o seu lugar. Para utilizadores geridos em grandes infraestruturas empresariais do Reino Unido, o Passpoint ou o OpenRoaming oferecem frequentemente um melhor resultado porque as decisões de acesso deixam de depender de heurísticas HTTP frágeis e passam para um acesso de rede autenticado desde o início.
Como deve ser um bom funcionamento
Uma implementação sólida apresenta alguns traços consistentes:
- O processamento de sondagens é deliberado: cada grande família de clientes obtém o padrão de resposta que espera no estado de pré-autenticação.
- Os caminhos de pré-autenticação são estritamente delimitados: apenas os domínios de sondagem necessários, componentes do portal, endpoints de identidade e caminhos de atualização estão acessíveis.
- Os controlos de segurança reconhecem o tráfego de sondagem: proxies, filtros e políticas de inspeção TLS não reescrevem nem interceptam estas verificações por acidente.
- As alterações de estado são rápidas após a autenticação: uma vez permitida a entrada do utilizador, o cliente pode voltar a verificar a conectividade e limpar o veredicto cativo sem desligar e ligar o WiFi.
- As equipas de operações podem testar ao nível do pacote: conseguem prever o resultado do cliente a partir de rastreios de DNS, HTTP e redirecionamento, e não a partir de uma captura de ecrã do browser.
Se a equipa conseguir explicar por que razão um dispositivo marcou a rede como cativa, aberta ou interrompida apenas a partir da troca de dados brutos, o design de deteção está geralmente em boa forma.
Como os Principais Sistemas Operativos Gerem a Deteção de Forma Diferente
Segunda-feira de manhã, o SSID de convidados parece saudável. Os clientes associam-se, obtêm DHCP e mostram um bom sinal. Depois, os pedidos de suporte dividem-se por tipo de dispositivo. Os iPhones ligam-se mas nunca mostram uma página de início de sessão, os telemóveis Android declaram imediatamente que é necessário iniciar sessão e os portáteis Windows ficam em "Sem Internet" tempo suficiente para os utilizadores culparem o WiFi. É por isso que a deteção de portal deve constar no manual de fiabilidade, e não apenas no design de acesso de convidados.
As diferenças são pequenas no papel e dispendiosas em produção. Cada plataforma testa a conectividade à sua maneira e cada uma reage mal a modos de falha ligeiramente diferentes. Em ambientes mistos, essas peculiaridades também se sobrepõem aos controlos de endpoint, tais como filtragem web, inspeção TLS, agentes VPN e verificações específicas do navegador. Um portal que apenas "funciona num navegador" não está a funcionar corretamente.
Comparativo de Expectativas de Sondas de SO
| Família de Cliente | Endpoint de Sonda | Sinal de Sucesso Esperado |
|---|---|---|
| Apple | captive.apple.com |
Resposta HTTP contendo a página de sucesso esperada |
| Android e stack Google | connectivitycheck.gstatic.com ou clients3.google.com/generate_204 |
204 No Content |
| Windows | msftconnecttest.com/connecttest.txt |
Texto simples do Microsoft Connect Test esperado |
| Firefox | detectportal.firefox.com |
Resposta de deteção de portal esperada utilizada pelo Firefox |
A Apple falha frequentemente de forma silenciosa
A Apple costuma oferecer a experiência de utilizador mais limpa quando o caminho de pré-autenticação está configurado corretamente. Quando está incorreto, a falha pode ser quase silenciosa. O dispositivo junta-se ao SSID, obtém um endereço e parece normal no controlador, mas o assistente cativo nunca se abre.
Na prática, isso aponta para duas causas comuns. A primeira é a interceção de testes (probes) que não corresponde ao que a Apple trata como captive. A segunda é a modificação de conteúdo por um controlo de segurança upstream. Uma página de bloqueio, injeção de cabeçalho ou política de processamento SSL pode alterar a resposta o suficiente para que o dispositivo já não confie no resultado. As equipas de suporte acabam por investigar problemas de RF ou DHCP quando o problema é a integridade HTTP.
O Android é mais fácil de testar e menos tolerante
O modelo 204 No Content do Android é direto. Isso ajuda durante o diagnóstico porque o comportamento esperado é claro, mas também significa que pequenos erros se revelam rapidamente. Devolva um redirecionamento, um corpo HTML ou uma resposta filtrada onde o Android não esperava nada, e o cliente poderá marcar a rede como cativa ou limitada.
Esse rigor é útil. Se o Android estiver instável no mesmo SSID onde a Apple parece funcionar bem, comece por analisar o comportamento do proxy, a filtragem de conteúdo e a lógica de redirecionamento antes de olhar para a camada sem fios.
O Windows expõe problemas de temporização e de políticas
O Windows tende a expor a ambiguidade de forma mais aberta do que a Apple. Os utilizadores deparam-se com conectividade limitada, longos atrasos antes do portal aparecer ou uma ligação que parece estabelecida mas que falha no tráfego de aplicações de formas estranhas. Em ambientes empresariais, isso intersecta-se frequentemente com ferramentas de segurança. Clientes VPN sempre ativos, módulos de proteção web e firewalls do anfitrião podem influenciar as mesmas verificações que o Windows utiliza para o estado da conectividade.
A Microsoft documenta o comportamento atual do NCSI e os respetivos endpoints nas suas próprias diretrizes, que são a referência correta para os clientes Windows atuais. A lição operacional é mais simples. Se o NCSI estiver a ser intercetado, filtrado ou respondido de forma demasiado lenta, os utilizadores vão sentir o impacto antes de o compreenderem.
O Firefox pode divergir do SO anfitrião
O Firefox merece atenção separada nos computadores porque executa a sua própria lógica de portal. O portátil pode apresentar uma conectividade normal enquanto o Firefox ainda se comporta como se o acesso estivesse restrito, ou o inverso. Isso não é apenas uma peculiaridade do navegador. Cria ruído real no suporte porque o sistema operativo, o navegador e o agente de endpoint podem ter, cada um, uma visão diferente da mesma rede.
Nota de campo: Quando os utilizadores reportam "O WiFi está ligado mas o Firefox está bloqueado," verifique o resultado do diagnóstico do sistema operativo, o resultado do diagnóstico do browser e qualquer agente de secure web gateway no endpoint. Uma suposição incorreta nesta fase pode enviar o ticket para a equipa errada.
Ambientes mistos necessitam de triagem com deteção de dispositivos
Utilize o sintoma para escolher o primeiro teste.
- O iPhone liga-se mas a página de início de sessão não aparece: verifique o processamento de sondas da Apple e confirme se o corpo retornado está intacto.
- O Android reporta imediatamente que é necessário iniciar sessão: confirme se o redirecionamento é deliberado e se algum dispositivo está a receber conteúdo em vez de
204. - O Windows indica sem internet, o portal aparece tarde: inspecione a acessibilidade do NCSI, o tempo de redirecionamento, a resposta de DNS e os agentes de segurança locais.
- O Firefox comporta-se de forma diferente do Chrome no mesmo portátil: separe a deteção ao nível do navegador do estado de conectividade do SO e da filtragem de endpoints.
É também aqui que a decisão de design é importante. Para o acesso de convidados, visitantes e BYOD, manter a deteção do portal funcional continua a valer a pena porque o fluxo de trabalho é esperado e a combinação de clientes é imprevisível. Para utilizadores geridos em grandes infraestruturas empresariais no Reino Unido, os casos extremos repetidos do portal são geralmente um sinal para reduzir a dependência da lógica cativa e avançar para o Passpoint ou OpenRoaming, onde o controlo de acesso ocorre na entrada da rede em vez de através de testes HTTP pós-associação frágeis.
Deteção Prática com curl, Python e Agentes de Dispositivo
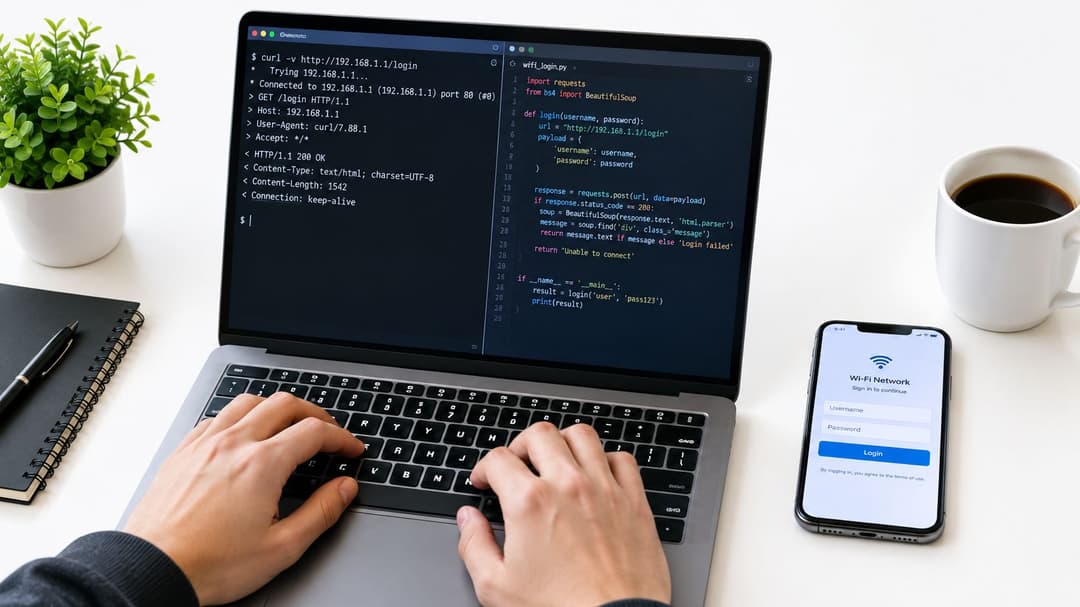
A forma mais rápida de parar de adivinhar é testar o caminho do teste diretamente. Não precisa de capturas de pacotes para todos os casos. Comece com verificações HTTP repetíveis e, em seguida, confirme o comportamento em dispositivos reais.
Comece com o curl
Utilize o curl para inspecionar códigos de estado, cabeçalhos e redirecionamentos a partir do mesmo segmento de rede do cliente.
Para uma sonda do tipo Google:
- Verificar apenas o estado: solicitar o ponto final
generate_204e confirmar se o resultado é204ou um redirecionamento. - Seguir os redirecionamentos com cuidado: executar o mesmo pedido com o seguimento de redirecionamentos ativado e verificar se aterriza uma vez no portal ou se entra em ciclo.
- Inspecionar cabeçalhos: se os dispositivos de filtragem de conteúdo adicionarem banners, cabeçalhos de categoria ou conteúdo rescrito, a deteção pode falhar mesmo quando o portal está ativo.
Para sondas de texto do tipo Windows:
- Obtenha o corpo exatamente como foi retornado
- Compare o output de texto simples
- Procure substituições ou páginas de wrapper
Para verificações do tipo Apple:
- Solicitar a página de sucesso esperada
- Confirmar se o corpo é o que o cliente espera quando a rede está aberta
- Confirmar se a interceção é deliberada quando o cliente não está autenticado
Uma verificação rápida de integridade com um verificador de cabeçalho HTTP ajuda quando proxies ou camadas de segurança estão a alterar as respostas.
Utilize um pequeno verificador em Python
Um script curto é suficiente para automatizar as verificações que o seu suporte técnico repete durante toda a semana. Mantenha-o simples:
- Definir os URLs de sondagem para as famílias de clientes que suporta.
- Enviar pedidos HTTP sem comportamento de navegador.
- Registar o estado, o URL final, a contagem de redirecionamentos e o snippet do corpo da resposta.
- Comparar os resultados com os valores esperados para redes abertas.
- Sinalizar resultados ambíguos, como um
200com conteúdo inesperado ou redirecionamentos repetidos.
Esse script não precisa de autenticar os utilizadores. O seu trabalho é responder a uma pergunta. A rede apresentou o teste de uma forma que desencadeasse a decisão esperada do cliente?
Os agentes de dispositivo precisam de moderação
Os testes com dispositivos geridos são onde as equipas podem criar danos colaterais. Se forçar testes programados agressivos em portáteis que já executam clientes VPN, proteção de DNS ou agentes de zero-trust, poderá acionar o próprio estado de integração que está a tentar evitar.
Utilize agentes leves com salvaguardas:
- Executar sondas em eventos de associação, não continuamente.
- Evitar alterações amplas de firewall do lado do endpoint.
- Separar os testes de integração de convidados da aplicação de VPN de produção, sempre que possível.
- Registar os veredictos localmente primeiro e, em seguida, exportar os resumos.
Conselho operacional: Teste como um cliente, não como um atacante. O objetivo é confirmar as decisões do SO, não forçar sistematicamente cada caminho de redirecionamento.
O que procurar nos resultados
Os bons testes dizem-lhe mais do que apenas "ativo" ou "inativo".
- Resposta aberta correta: a sonda devolve o código ou marcador esperado.
- Resposta captive esperada: o cliente não autenticado é redirecionado uma vez para o portal.
- Looping: o mesmo pedido falha repetidamente.
- Resultado filtrado: a resposta existe, mas o conteúdo foi modificado.
- Caminho morto: tempo limite esgotado ou endpoint inacessível.
Se conseguir reunir esses resultados a partir de um portátil na VLAN de convidados e de um dispositivo gerido pela empresa, normalmente descobrirá onde reside o problema antes que a primeira captura de ecrã do utilizador chegue à sua caixa de entrada.
Integrar a Deteção com WiFi Empresarial e Plataformas de Identidade
Em redes WiFi empresariais, a deteção de Captive Portal não deve ser o centro do design. Deve ser uma camada de compatibilidade controlada.
Essa é a mudança que muitas infraestruturas ainda estão a processar. O acesso de convidados, a integração de prestadores de serviços externos e o WiFi público podem ainda necessitar de lógica de portal. O acesso de funcionários e utilizadores conhecidos normalmente não deve depender disso, se o puder evitar.
Coloque o processamento de sondas no local correto
Quer utilize Meraki, Aruba, Ruckus, Mist ou UniFi, a mesma regra de design aplica-se. Trate os testes não autenticados de forma previsível no controlador, gateway ou extremidade da nuvem onde a sua política de convidados já reside.
Isto significa:
- Permita os caminhos corretos de pré-autenticação: endpoints de teste (probe), recursos do portal e quaisquer redirecionamentos de identidade que devam ser carregados antes do acesso total.
- Mantenha a política não autenticada restrita: o suficiente para o onboarding, não para a internet em geral.
- Separe a lógica de convidados e de funcionários: não permita que a interceção do portal afete SSIDs corporativos geridos ou baseados em certificados.
Se está a substituir o acesso baseado em palavra-passe por fluxos de trabalho de identidade, o identity-based networking é o modelo relevante. Este modelo desloca o acesso de utilizadores conhecidos dos fluxos cativos para uma conectividade autenticada e orientada por políticas.
O registo de logs é importante no Reino Unido
No contexto do setor público e das empresas no Reino Unido, a norma de segurança sem fios SS-019 exige que as autenticações de Captive Portal de convidados sejam registadas, que as tentativas falhadas de portal sejam investigadas, que as alterações de configuração sejam registadas com a identidade do operador, e que os limiares de monitorização de tráfego sejam definidos para que a atividade maliciosa possa ser atribuída a credenciais individuais. Também sinaliza anomalias como contagens de dispositivos invulgarmente elevadas num único ponto de acesso, tráfego anormalmente elevado de um cliente e muitas tentativas falhadas de ligação num curto período (UK wireless security standard SS-019).
Isso muda a forma como eu implementaria a deteção. Não registe apenas “portal atingido”. Registe a cadeia:
- Associação e identidade do cliente
- Veredicto cativo acionado por sonda
- Sucesso ou falha do portal
- Alteração de política após autenticação
- Telemetria que associa o evento ao comportamento do AP e do cliente
Evite que os clientes de zero-trust entrem em conflito com o portal
Os designs incorretos desmoronam-se aqui. Algumas ferramentas de segurança de endpoint tratam os estados cativos como excecionais e relaxam temporariamente os controlos. Se a rede causar falsas deteções de Captive Portal, esses clientes podem oscilar entre a lógica de integração e a aplicação normal de políticas.
Um padrão mais seguro é:
- Os dispositivos conhecidos utilizam primeiro a autenticação enterprise
- Os dispositivos de convidados e desconhecidos entram num caminho de integração restrito
- A deteção do portal permanece disponível como alternativa
- As equipas de VPN e zero-trust validam o comportamento em compilações de clientes representativas antes do lançamento
Uma opção de plataforma nesse espaço é a Purple, que suporta a ativação de WiFi de convidados e padrões de acesso baseados em identidade em hardware de rede de terceiros. Isto é útil quando necessita de suporte de portal para convidados, mas deseja reduzir a dependência de portais para utilizadores recorrentes ou geridos.
Testar a Resolução de Problemas e a Monitorização que Mantém a Deteção Fiável
A deteção de Captive Portal falha. É por isso que os testes de aceitação pontuais não são suficientes.
A suposição que eu desafiaria é esta: se a página do portal carrega durante a colocação em funcionamento, o trabalho está concluído. Não está. O funcionamento fiável depende de manter o fluxo de trabalho de diagnóstico intacto face a atualizações do SO, alterações de filtragem, integrações de identidade e alterações na segurança dos endpoints.
Uma rotina de verificação prática
Utilize uma pequena lista de verificação sempre que alterar o acesso de convidados, a política de DNS, a filtragem ou o comportamento do controlador:
- Validação de endpoints de sondagem: confirme que cada grande família de clientes obtém o tipo de resposta que espera.
- Sanidade do redirecionamento: verifique se existem redirecionamentos de salto único em vez de loops.
- Inspeção de filtragem: certifique-se de que os filtros web ou camadas de proxy não estão a reescrever o conteúdo do corpo ou os cabeçalhos.
- Comportamento do DNS: confirme que os clientes não autenticados resolvem o que precisam para o registo e nada mais.
- Recuperação pós-autenticação: verifique se os clientes reavaliam a conectividade de forma limpa após a autenticação.
- Verificações pontuais em várias plataformas: teste em Windows, macOS, iOS e Android com dispositivos representativos geridos e não geridos.
Monitorize os sinais corretos
Para as operações no Reino Unido, a fiabilidade da deteção deve ser monitorizada juntamente com a telemetria de segurança, e não de forma isolada. O SS-019 é útil aqui porque empurra as equipas para a auditabilidade e monitorização de anomalias, e não apenas para o registo de sucessos de início de sessão.
Eu estaria atento a:
- Picos de tentativas falhadas de ligação
- Densidade inesperada de clientes num único AP
- Falhas repetidas do portal com a mesma classe de cliente
- Incompatibilidades entre o sucesso da associação e sessões utilizáveis na internet
- Alterações acentuadas após atualizações de endpoints ou de navegadores
“Ligado” não é um estado de sucesso significativo para redes WiFi de convidados. A conectividade utilizável é.
Quando manter a deteção e quando desativá-la
Esta é a questão estratégica que muitas equipas evitam. Algumas infraestruturas ainda precisam de um Captive Portal para recolha de identidade de convidados, aceitação de termos ou fluxos de trabalho de acesso público. Tudo bem. Mantenha-o, mas trate a deteção como um caminho de contingência cuidadosamente testado.
Para visitantes frequentes, funcionários e utilizadores geridos, o argumento comercial para afastar-se dos portais cativos é cada vez mais forte. A cobertura do OpenRoaming e Passpoint no Reino Unido indica que estas abordagens estão "finalmente a proporcionar" uma integração automática e segura sem inícios de sessão repetidos no Captive Portal, e um relatório do setor no Reino Unido refere que 38% dos inquiridos já tinham implementado uma rede compatível com OpenRoaming ou Passpoint, com 32% a planear implementações em 2026 e 18% em 2027, conforme projetado nesse relatório (cobertura da Networking+ sobre a direção do sem-fios no Reino Unido).
Isso não significa que os portais desapareçam amanhã. Significa que muitas redes devem deixar de conceber a sua arquitetura em torno deles como a principal jornada do utilizador. Numa infraestrutura empresarial moderna no Reino Unido, a deteção de Captive Portal pertence frequentemente à mesma categoria de outras funcionalidades de compatibilidade herdadas. Necessária em alguns locais. Que vale a pena minimizar em muitos outros.
Se está a tentar reduzir o atrito do portal sem perder o controlo, a Purple oferece autenticação de convidados WiFi, acesso baseado em identidade e suporte para abordagens como OpenRoaming e Passpoint que podem diminuir a sua dependência da deteção de Captive Portal. Se essa é a direção que a sua infraestrutura está a tomar, vale a pena ver como a Purple se enquadra na sua stack de rede existente e nas políticas de integração.