Vous rejoignez un SSID invité, l'ordinateur portable indique qu'il est connecté, le téléphone n'ouvre rien, Windows signale une connectivité limitée et le centre d'assistance est accusé d'avoir un "portail en panne". La plupart du temps, la page du portail n'est pas le premier problème. C'est la détection du Captive Portal qui l'est.
Cette distinction importe plus aujourd'hui qu'il y a quelques années. Dans les parcs mixtes au Royaume-Uni, le flux de travail de détection affecte l'expérience utilisateur, le comportement de sécurité des terminaux, la journalisation et la stabilité des outils zero-trust lors de l'intégration. Si vous ne le considérez que comme "l'élément qui fait apparaître la page d'accueil", vous manquerez les défaillances qui bloquent les utilisateurs.
Ce que fait réellement la détection de Captive Portal
Un Captive Portal ne commence pas par la page du portail. Il commence par la décision du client de déterminer si le réseau dispose d'un accès Internet illimité.
Lorsqu'un appareil rejoint le WiFi, le système d'exploitation envoie généralement une requête HTTP en arrière-plan vers un point de terminaison contrôlé par le fournisseur. Si la réponse correspond à ce que ce client attend, l'appareil suppose un accès internet ouvert et reste silencieux. Si la réponse est redirigée, modifiée ou bloquée, l'OS décide qu'un portail existe probablement et ouvre un flux de connexion.
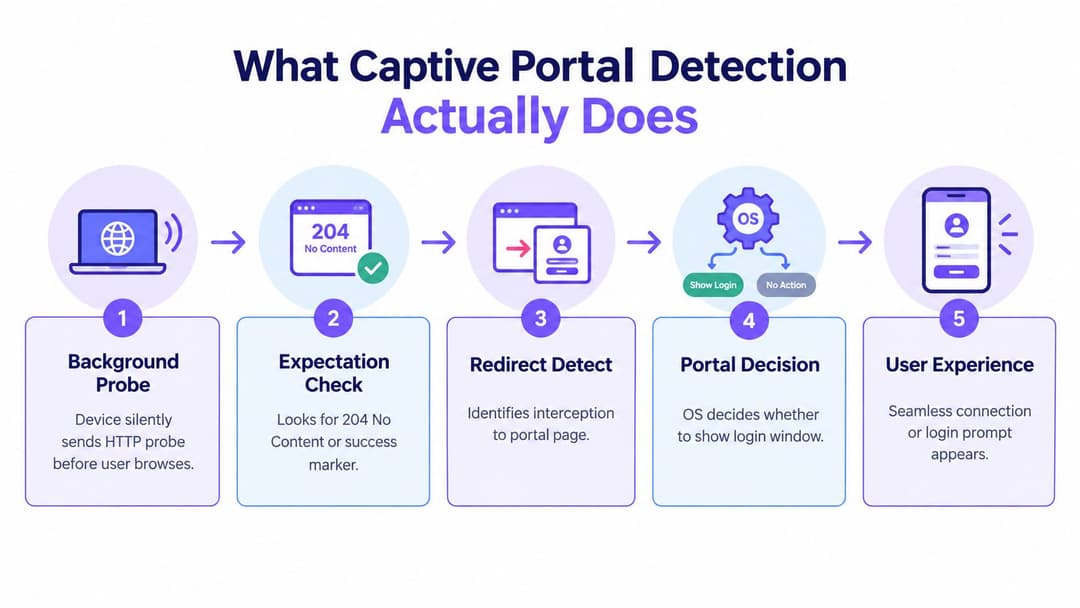
La détection est la porte d'entrée, pas la connexion
C'est la partie que de nombreuses équipes ont tendance à confondre :
- La détection détermine si l'utilisateur doit voir un portail.
- L'authentification détermine si cet utilisateur est autorisé à se connecter.
- L'autorisation détermine ce que cet utilisateur peut atteindre par la suite.
Si la détection échoue, le portail peut être en parfait état de fonctionnement, mais personne ne le verra jamais. Si la détection réussit mais que l'authentification échoue, les utilisateurs verront la page mais n'auront toujours pas d'accès. Ce sont des pannes distinctes qui nécessitent des solutions différentes.
Un modèle conceptuel utile consiste à traiter la détection du Captive Portal comme un verdict de connectivité dicté par l'OS. Ce n'est pas le navigateur qui pilote, c'est le système d'exploitation.
Pourquoi cela compte dans les réseaux réels
Il ne s'agit pas d'un cas marginal. Une étude sur les points d'accès a révélé que 484 réseaux ont atteint le premier test de détection de Captive Portal, et que 390 réseaux distincts utilisaient une forme de Captive Portal, montrant que la détection de portail était déjà active à une échelle de déploiement réelle et pas seulement dans des configurations de laboratoire (résumé de l'étude).
Cette échelle est cruciale car chacun de ces réseaux dépend de la capacité des clients à interpréter correctement les réponses de sonde. En pratique, cela signifie que l'expérience utilisateur repose sur un échange très limité : un code d'état, un corps de réponse ou une redirection.
Règle pratique : Si les utilisateurs disent que « le portail n'est pas apparu », inspectez le chemin de la sonde avant d'inspecter la page du portail.
Pourquoi le problème a changé
Le dépannage des anciens hotspots consistait principalement à faire charger la page d'accueil. Cela fait toujours partie du travail, mais les parcs informatiques modernes comportent une autre couche. Les agents de sécurité, les clients VPN et les outils d'intégration réagissent également lorsqu'ils détectent l'existence d'un Captive Portal. Mozilla indique que Firefox vérifie des points de terminaison de portail dédiés avant d'ouvrir une page de connexion, tandis que Cloudflare note que son client peut envoyer plusieurs requêtes de portail spécifiques au système d'exploitation et peut ouvrir complètement le pare-feu du système jusqu'à ce que l'intégration soit terminée, ce qui transforme la détection en un enjeu de fiabilité et de sécurité des terminaux, et pas seulement en un problème de connexion (Mozilla captive portal support article).
C'est pourquoi les équipes matures posent désormais deux questions, et non plus une seule. Premièrement, le réseau peut-il déclencher le portail de manière cohérente ? Deuxièmement, ce parc d'équipements doit-il encore dépendre de ce flux de travail comme méthode d'accès principale ?
Sondes de base et heuristiques pour une détection fiable
Un client rejoint le WiFi, obtient une adresse DHCP, affiche un bon signal, et indique pourtant "Pas de connexion Internet" ou n'ouvre jamais la fenêtre de connexion. Dans presque tous les cas, le problème se situe sur le chemin de la sonde, et non sur la page du portail.
Ce que les clients vérifient réellement
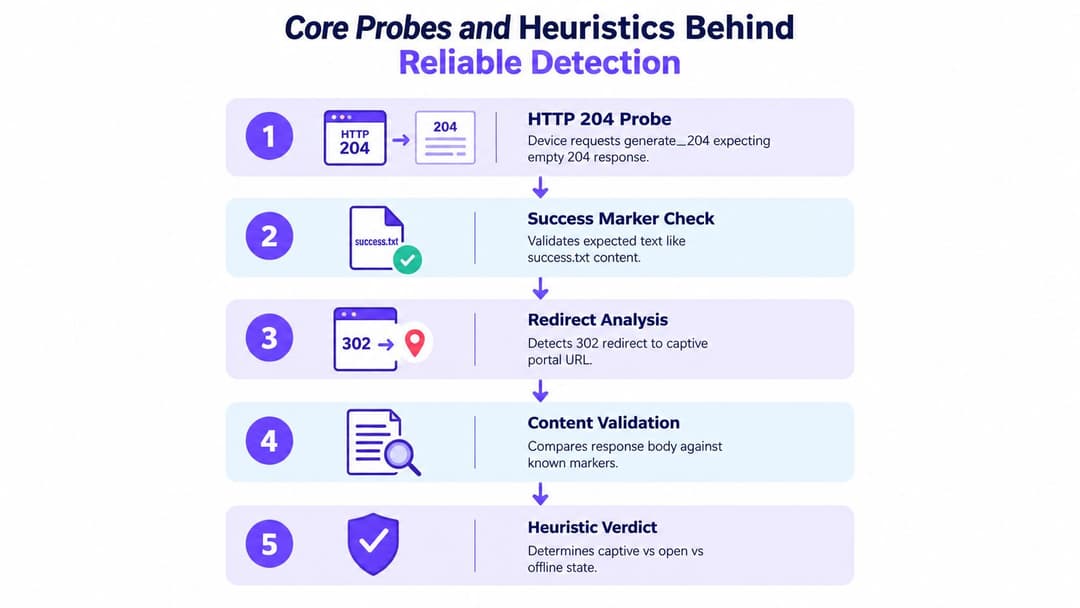
La détection de Captive Portal est un petit moteur de décision intégré à l'OS ou à l'agent client. L'appareil envoie une requête connue à un point de terminaison connu, compare la réponse avec un résultat attendu, puis décide si le réseau est en ligne, captif ou en panne. L'utilisateur ne voit parfois qu'un navigateur contextuel, mais le travail s'est fait quelques paquets plus tôt.
Les cibles de sondage courantes incluent captive.apple.com d'Apple, connectivitycheck.gstatic.com et clients3.google.com/generate_204 de Google, msftconnecttest.com/connecttest.txt de Microsoft, et detectportal.firefox.com de Firefox. Le déclencheur n'est pas uniquement le nom d'hôte. C'est la combinaison du code d'état, des en-têtes, du contenu du corps, du comportement de redirection et du timing, comme le souligne l'aperçu du portail hotspot DrayTek.
La logique ressemble généralement à ceci :
- Le client envoie une sonde
- Le réseau la laisse passer ou l'intercepte
- Le client compare la réponse avec son modèle attendu
- Le client classifie l'état du réseau
- Le système d'exploitation ou l'agent décide de lancer un flux captif, d'avertir l'utilisateur ou de rester silencieux
Cette dernière étape est plus importante que ce que de nombreuses équipes imaginent. Les agents de sécurité, les clients VPN et les outils d'intégration se basent souvent sur ce même verdict. Une mauvaise réponse de sonde peut couper l'accès, retarder les contrôles de conformité ou laisser le terminal dans un état de connexion hybride anormal.
Ce qui perturbe le plus souvent la détection
Les modes de défaillance courants sont banals, répétitifs et faciles à manquer lors d'un test rapide sur navigateur.
- Mauvais statut HTTP : les vérifications de la famille Android s'attendent souvent à un code
204 No Content. Renvoyez une page personnalisée avec un code200 OKet le client risque de classer le réseau comme captif, défectueux ou instable. - Contenu de corps incorrect : Windows et d'autres systèmes peuvent rechercher des marqueurs de texte brut exacts. Les bannières de proxy, l'HTML réécrit ou les fonctionnalités d'injection de contenu peuvent perturber cette correspondance.
- Erreurs de redirection : une seule redirection claire vers le portail convient. Les redirections en chaîne, les boucles ou les redirections qui alternent entre HTTP et HTTPS provoquent souvent des échecs silencieux.
- Interférence DNS : le détournement de DNS, le DNS split-horizon ou les résolveurs récursifs qui répondent de manière incohérente peuvent envoyer des requêtes de test là où le client ne s'y attendait pas.
- Interception TLS : le filtrage HTTPS et la substitution de certificats entraînent régulièrement des plaintes de type "connecté, pas d'internet" car le client ne fait plus confiance au résultat du test.
- Problèmes de synchronisation et d'accessibilité : un DNS amont lent, des CDN bloqués pour les ressources du portail ou l'absence de listes d'autorisation pour les fournisseurs d'identité peuvent faire osciller la détection entre différents états.
Un contrôle de déploiement pratique consiste à créer d'abord la liste d'autorisation de pré-authentification et à la tester séparément. Des outils tels que le générateur de walled garden Purple pour les domaines et dépendances de Captive Portal aident à identifier les hôtes de sonde, les ressources du portail, les redirections d'identité et les destinations post-authentification qui nécessitent un traitement différent.
Un échec ambigu remplit la file d'attente des tickets. Un échec net est plus facile à diagnostiquer.
Pourquoi les heuristiques sont fragiles
Ces vérifications sont fragiles car elles ont été conçues pour déduire l'état du réseau à partir d'un échange minime, souvent avant que l'appareil n'ait un accès complet. De légers changements dans le filtrage de contenu, l'inspection SSL, les proxys inverses ou la politique de pare-feu peuvent modifier le résultat sans que personne ne touche au portail lui-même.
Je constate le plus souvent cela sur les SSID d'intégration et d'invités d'entreprise où plusieurs équipes gèrent différentes parties du parcours. L'équipe sans fil voit l'association réussir. L'équipe pare-feu voit une politique de redirection autorisée. L'équipe sécurité voit l'inspection HTTPS fonctionner comme prévu. Le terminal, lui, ne voit qu'une réponse de sonde qui ne correspond plus à ce qu'il a demandé.
C'est pourquoi la détection de Captive Portal doit être traitée comme un contrôle de fiabilité et de sécurité des terminaux, et non comme une simple fonctionnalité de confort qui affiche une page de connexion. Si la détection n'est pas fiable, les utilisateurs ne parviennent pas à se connecter, les agents de sécurité peuvent mal interpréter la connectivité et les équipes d'assistance finissent par dépanner la mauvaise couche.
Cela explique également pourquoi certains parcs informatiques devraient cesser de s'appuyer sur les flux de travail captifs comme méthode d'accès principale. Pour l'accès invité BYOD, les visiteurs de courte durée et l'intégration existante, la détection de portail a toujours sa place. Pour les utilisateurs gérés dans les grands parcs d'entreprises au Royaume-Uni, Passpoint ou OpenRoaming offre souvent un meilleur résultat car les décisions d'accès s'éloignent des heuristiques HTTP fragiles pour s'orienter d'emblée vers un accès réseau authentifié.
À quoi ressemble une bonne configuration
Un déploiement solide présente quelques caractéristiques constantes :
- La gestion des requêtes de test est délibérée : chaque grande famille de clients reçoit le modèle de réponse qu'elle attend dans l'état de pré-authentification.
- Les chemins de pré-authentification sont strictement limités : seuls les domaines de test requis, les composants du portail, les points de terminaison d'identité et les chemins de mise à jour sont accessibles.
- Les contrôles de sécurité reconnaissent le trafic de test : les proxys, les filtres et les politiques d'inspection TLS ne réécrivent ni n'interceptent ces vérifications par accident.
- Les changements d'état sont rapides après l'authentification : une fois l'utilisateur autorisé, le client peut revérifier la connectivité et effacer le verdict de portail captif sans désactiver puis réactiver le WiFi.
- Les équipes opérationnelles peuvent tester au niveau du paquet : elles peuvent prédire le comportement du client à partir des traces DNS, HTTP et de redirection, et non à partir d'une simple capture d'écran de navigateur.
Si l'équipe peut expliquer pourquoi un appareil a marqué le réseau comme captif, ouvert ou défectueux à partir du seul échange brut, la conception de la détection est généralement opérationnelle.
Comment les principaux systèmes d'exploitation gèrent différemment la détection
Lundi matin, le SSID invité semble en bonne santé. Les clients s'associent, obtiennent le DHCP et affichent un bon signal. Ensuite, les tickets d'incident se divisent par type d'appareil. Les iPhones se connectent mais n'affichent jamais de page de connexion, les téléphones Android déclarent immédiatement qu'une connexion est requise, et les ordinateurs portables Windows restent sur "Pas d'Internet" suffisamment longtemps pour que les utilisateurs rejettent la faute sur le WiFi. C'est pourquoi la détection de portail a sa place dans le manuel de fiabilité, et pas seulement dans la conception de l'accès invité.
Les différences sont minimes sur le papier mais coûteuses en production. Chaque plateforme teste la connectivité à sa manière, et chacune réagit mal à des modes de défaillance légèrement différents. Dans les parcs mixtes, ces particularités se superposent également aux contrôles des terminaux tels que le filtrage web, l'inspection TLS, les agents VPN et les vérifications spécifiques aux navigateurs. Un portail qui fonctionne seulement "dans un navigateur" ne fonctionne pas correctement.
Comparaison des attentes des sondes OS
| Famille de client | Point de terminaison de sonde | Signal de réussite attendu |
|---|---|---|
| Apple | captive.apple.com |
Réponse HTTP contenant la page de réussite attendue |
| Android et suite Google | connectivitycheck.gstatic.com ou clients3.google.com/generate_204 |
204 No Content |
| Windows | msftconnecttest.com/connecttest.txt |
Texte brut Microsoft Connect Test attendu |
| Firefox | detectportal.firefox.com |
Réponse de détection de portail attendue par Firefox |
Apple échoue souvent en silence
Apple offre généralement l'expérience utilisateur la plus fluide lorsque le chemin de pré-authentification est correctement configuré. En cas d'erreur, l'échec peut être presque invisible. L'appareil rejoint l'SSID, obtient une adresse et apparaît normalement dans le contrôleur, mais l'assistant de Captive Portal ne s'ouvre jamais.
En pratique, cela pointe vers deux causes courantes. La première est une interception de sonde qui ne correspond pas à ce qu'Apple considère comme captif. La seconde est la modification du contenu par un contrôle de sécurité en amont. Une page de blocage, une injection d'en-tête ou une politique de gestion SSL peuvent altérer la réponse au point que l'appareil ne fait plus confiance au résultat. Les équipes de support recherchent alors des problèmes de RF ou de DHCP alors que le problème réside dans l'intégrité HTTP.
Android est plus facile à tester et moins tolérant
Le modèle 204 No Content d'Android est direct. Cela facilite le diagnostic car le comportement attendu est clair, mais cela signifie également que les petites erreurs apparaissent rapidement. Renvoyez une redirection, un corps HTML ou une réponse filtrée là où Android n'attendait rien, et le client risquera de marquer le réseau comme captif ou altéré.
Cette rigueur est utile. Si Android se montre instable sur le même SSID où Apple semble fonctionner correctement, commencez par analyser le comportement du proxy, le filtrage de contenu et la logique de redirection avant de vous pencher sur la couche sans fil.
Windows expose les problèmes de timing et de stratégie
Windows a tendance à afficher l'ambiguïté de manière plus flagrante qu'Apple. Les utilisateurs constatent une connectivité limitée, de longs retards avant l'apparition du portail, ou une connexion qui semble établie mais qui échoue de manière étrange sur le trafic des applications. Dans les parcs d'entreprises, cela interfère souvent avec les outils de sécurité. Les clients VPN toujours actifs, les modules de protection web et les pare-feux d'hôte peuvent influencer les mêmes vérifications que Windows utilise pour l'état de la connectivité.
Microsoft documente le comportement et les terminaux NCSI actuels dans ses propres guides, ce qui constitue la bonne référence pour les clients Windows actuels. La leçon opérationnelle est plus simple. Si le NCSI est intercepté, filtré ou s'il répond trop lentement, les utilisateurs le ressentiront avant même de le comprendre.
Firefox peut être en désaccord avec l'OS hôte
Firefox mérite une attention particulière sur les ordinateurs de bureau car il exécute sa propre logique de portail. L'ordinateur portable peut afficher une connectivité normale alors que Firefox se comporte toujours comme si l'accès était restreint, ou inversement. Ce n'est pas seulement une particularité du navigateur. Cela génère de réelles demandes de support car le système d'exploitation, le navigateur et l'agent du terminal peuvent avoir chacun une vision différente du même réseau.
Note de terrain : Lorsque des utilisateurs signalent que le "WiFi est connecté mais Firefox est bloqué", vérifiez le résultat de la sonde du système d'exploitation, le résultat de la sonde du navigateur et tout agent de passerelle web sécurisée sur le terminal. Une seule mauvaise hypothèse à ce stade peut envoyer le ticket à la mauvaise équipe.
Les parcs mixtes nécessitent un tri adapté aux appareils
Utilisez le symptôme pour choisir le premier test.
- L'iPhone se connecte mais aucune page de connexion n'apparaît : vérifiez la gestion de la sonde Apple et confirmez que le corps de la réponse renvoyé est intact.
- Android signale immédiatement qu'une connexion est requise : confirmez si la redirection est délibérée et si un appareil reçoit du contenu au lieu d'un code
204. - Windows indique qu'il n'y a pas d'accès Internet, le portail apparaît tardivement : inspectez l'accessibilité NCSI, le timing de la redirection, la réponse DNS et les agents de sécurité locaux.
- Firefox se comporte différemment de Chrome sur le même ordinateur portable : séparez la détection au niveau du navigateur de l'état de connectivité du système d'exploitation et du filtrage des terminaux.
C'est également là que la décision de conception a toute son importance. Pour l'accès des invités, des visiteurs et du BYOD, maintenir une détection de portail efficace en vaut toujours la peine, car le flux de travail est attendu et le parc de clients est imprévisible. Pour les utilisateurs gérés au sein des grands parcs d'entreprises britanniques, les cas limites de portail répétés sont généralement le signe qu'il faut réduire la dépendance à la logique captive et s'orienter vers Passpoint ou OpenRoaming, où le contrôle d'accès s'effectue à l'entrée du réseau plutôt que par des tests HTTP post-association fragiles.
Détection pratique avec curl Python et agents d'appareil
Le moyen le plus rapide d'arrêter de deviner est de tester directement le chemin de la sonde. Vous n'avez pas besoin de captures de paquets pour chaque cas. Commencez par des vérifications HTTP reproductibles, puis confirmez le comportement sur des terminaux réels.
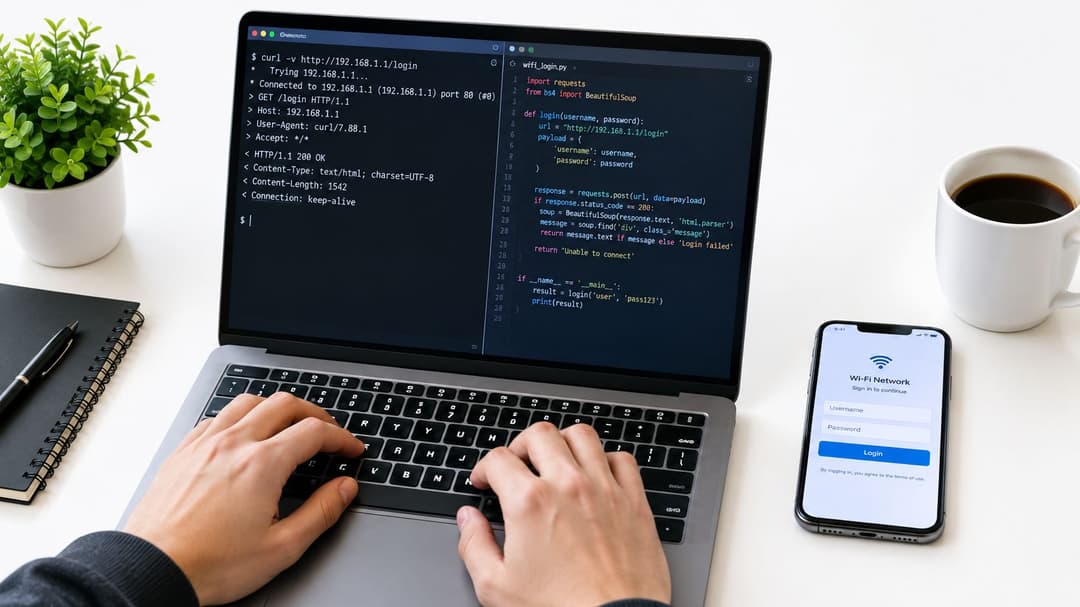
Commencer avec curl
Utilisez curl pour inspecter les codes d'état, les en-têtes et les redirections depuis le même segment réseau que le client.
Pour une sonde de style Google :
- Vérifier uniquement l'état : interroger le point de terminaison
generate_204et confirmer si le résultat est204ou une redirection. - Suivre les redirections avec attention : exécuter la même requête en activant le suivi des redirections et observer si elle aboutit une fois sur le portail ou si elle boucle.
- Inspecter les en-têtes : si les appliances de filtrage de contenu ajoutent des bannières, des en-têtes de catégorie ou du contenu réécrit, la détection peut échouer même lorsque le portail est actif.
Pour les sondes de texte de style Windows :
- Récupérer le corps exactement tel qu'il est renvoyé
- Comparer la sortie en texte brut
- Rechercher des substitutions ou des pages d'habillage
Pour les vérifications de style Apple :
- Demander la page de réussite attendue
- Confirmer que le corps du message correspond à ce que le client attend lorsque le réseau est ouvert
- Confirmer que l'interception est délibérée lorsque le client n'est pas authentifié
Une vérification rapide avec un vérificateur d'en-têtes HTTP est utile lorsque des proxys ou des couches de sécurité modifient les réponses.
Utiliser un petit vérificateur Python
Un court script suffit à automatiser les vérifications que votre centre de services répète toute la semaine. Restez simple :
- Définir les URL de sondage pour les familles de clients que vous prenez en charge.
- Envoyer des requêtes HTTP sans comportement de navigateur.
- Enregistrer l'état, l'URL finale, le nombre de redirections et un extrait du corps de la réponse.
- Comparer les résultats avec les valeurs attendues pour un réseau ouvert.
- Signaler les résultats ambigus tels que
200avec un contenu inattendu ou des redirections répétées.
Ce script n'a pas besoin de connecter les utilisateurs. Son rôle est de répondre à une seule question : le réseau a-t-il présenté la sonde d'une manière qui déclencherait la décision attendue du client ?
Les agents d'appareil doivent rester modérés
Les tests sur les appareils gérés sont l'étape où les équipes peuvent causer des dommages collatéraux. Si vous déployez des tests automatisés agressifs sur des ordinateurs portables qui exécutent déjà des clients VPN, une protection DNS ou des agents zero-trust, vous risquez de déclencher précisément l'état d'intégration que vous essayez d'éviter.
Utilisez des agents légers dotés de garde-fous :
- Exécuter des sondes lors des événements d'association, et non en continu.
- Éviter les modifications globales de pare-feu du côté du terminal.
- Séparer les tests d'intégration des invités de l'application du VPN de production lorsque cela est possible.
- Enregistrer les verdicts localement d'abord, puis exporter les résumés.
Conseil opérationnel : Testez comme un client, pas comme un attaquant. Le but est de confirmer les décisions du système d'exploitation, pas de forcer chaque chemin de redirection.
Ce qu'il faut chercher dans les résultats
Les bons tests vous apportent plus qu'un simple statut "actif" ou "inactif".
- Réponse ouverte correcte : la sonde renvoie le code ou le marqueur attendu.
- Réponse captive attendue : le client non authentifié est redirigé une fois vers le portail.
- Bouclage : la même requête rebondit à plusieurs reprises.
- Résultat filtré : la réponse existe mais le contenu est modifié.
- Chemin mort : expiration du délai ou point de terminaison inaccessible.
Si vous parvenez à rassembler ces résultats depuis un ordinateur portable sur le VLAN invité et depuis un terminal d'entreprise géré, vous identifierez généralement l'origine du problème avant même que la première capture d'écran d'un utilisateur n'arrive dans votre boîte de réception.
Intégration de la détection avec le WiFi d'entreprise et les plateformes d'identité
Dans le WiFi d'entreprise, la détection du Captive Portal ne devrait pas être le centre de la conception. Elle doit être une couche de compatibilité contrôlée.
C'est la transition sur laquelle travaillent encore de nombreux parcs informatiques. L'accès invité, l'intégration des prestataires et le WiFi public peuvent encore nécessiter une logique de portail. L'accès des collaborateurs et des utilisateurs connus ne devrait généralement pas en dépendre si vous pouvez l'éviter.
Placer la gestion des sondes au bon endroit
Que vous utilisiez Meraki, Aruba, Ruckus, Juniper Mist ou UniFi, la même règle de conception s'applique. Gérez les sondes non authentifiées de manière prévisible au niveau du contrôleur, de la passerelle ou de la périphérie cloud où réside déjà votre politique invité.
Cela signifie :
- Autoriser les bons chemins de pré-authentification : les endpoints de sonde, les ressources du portail et toutes les redirections d'identité qui doivent se charger avant l'accès complet.
- Maintenir une politique non authentifiée restreinte : suffisante pour l'intégration, mais pas pour un accès internet général.
- Séparer la logique invités et collaborateurs : ne laissez pas l'interception du portail affecter les SSID d'entreprise managés ou basés sur des certificats.
Si vous remplacez l'accès par mot de passe par des flux de travail d'identité, le réseau basé sur l'identité est le modèle approprié. Il déplace l'accès des utilisateurs connus hors des flux captifs pour l'orienter vers une connectivité authentifiée et basée sur des politiques.
La journalisation est importante au Royaume-Uni
Dans le contexte du secteur public et des entreprises au Royaume-Uni, la norme de sécurité sans fil SS-019 exige que les authentifications sur le Captive Portal invité soient journalisées, que les tentatives de portail échouées soient analysées, que les modifications de configuration soient enregistrées avec l'identité de l'opérateur et que des seuils de surveillance du trafic soient définis afin de pouvoir attribuer une activité malveillante à des identifiants individuels. Elle signale également les anomalies telles qu'un nombre d'appareils anormalement élevé sur un point d'accès, un trafic anormalement élevé provenant d'un seul client et de nombreuses tentatives de connexion échouées sur une courte période (UK wireless security standard SS-019).
Cela change la façon dont j'implémenterais la détection. Ne vous contentez pas d'enregistrer « accès portail ». Enregistrez la chaîne :
- Association et identité du client
- Verdict captif déclenché par sonde
- Succès ou échec du portail
- Changement de politique après authentification
- Télémétrie qui lie l'événement au comportement de l'AP et du client
Empêcher les clients zero-trust de bloquer le portail
C'est ici que les mauvaises configurations se révèlent. Certains outils de sécurité des terminaux considèrent les états de Captive Portal comme exceptionnels et relâchent temporairement les contrôles. Si le réseau provoque de fausses détections de Captive Portal, ces clients peuvent osciller entre la logique d'intégration et l'application normale des règles.
Un modèle plus sûr consiste à :
- Les appareils connus utilisent d'abord l'authentification d'entreprise
- Les appareils invités et inconnus sont orientés vers un parcours d'intégration restreint
- La détection du Captive Portal reste disponible comme solution de secours
- Les équipes VPN et zero-trust valident le comportement sur des versions clientes représentatives avant le déploiement
Une option de plateforme dans ce domaine est Purple, qui prend en charge l'accueil WiFi des invités et les modèles d'accès basés sur l'identité sur du matériel réseau tiers. C'est utile lorsque vous avez besoin de la prise en charge d'un portail pour les invités mais souhaitez réduire la dépendance aux portails pour les utilisateurs réguliers ou gérés.
Tests, dépannage et surveillance pour maintenir la fiabilité de la détection
La détection du Captive Portal peut tomber en panne. C'est pourquoi un test de recette ponctuel ne suffit pas.
L'hypothèse que je contesterais est la suivante : si la page du portail se charge lors de la mise en service, le travail est terminé. Ce n'est pas le cas. Un fonctionnement fiable dépend du maintien de l'intégrité du flux de travail des sondes à travers les mises à jour de l'OS, les modifications de filtrage, les intégrations d'identité et les changements de sécurité des terminaux.
Une routine de vérification pratique
Utilisez une liste de contrôle courte à chaque fois que vous touchez à l'accès invité, à la politique DNS, au filtrage ou au comportement du contrôleur :
- Validation des points de terminaison de test : confirmer que chaque grande famille de clients reçoit le type de réponse attendu.
- Cohérence des redirections : vérifier la présence de redirections à saut unique plutôt que des boucles.
- Inspection du filtrage : s'assurer que les filtres web ou les couches de proxy ne réécrivent pas le contenu du corps ou les en-têtes.
- Comportement DNS : confirmer que les clients non authentifiés résolvent ce dont ils ont besoin pour l'intégration, et rien de plus.
- Restauration post-authentification : vérifier que les clients réévaluent proprement la connectivité après l'authentification.
- Contrôles ponctuels multiplateformes : tester sur Windows, macOS, iOS et Android avec des appareils gérés et non gérés représentatifs.
Surveiller les bons signaux
Pour les opérations au Royaume-Uni, la fiabilité de la détection doit être surveillée aux côtés de la télémétrie de sécurité, et non de manière isolée. La norme SS-019 est utile ici car elle incite les équipes à l'auditabilité et à la surveillance des anomalies, plutôt qu'au simple suivi des connexions réussies.
Je surveillerais :
- Pics de tentatives d'association échouées
- Densité de clients inattendue sur un seul point d'accès
- Échecs répétés du portail pour une même catégorie de clients
- Écarts entre le succès de l'association et les sessions utilisables sur internet
- Changements brusques après les mises à jour des terminaux ou des navigateurs
« Connecté » n'est pas un état de réussite significatif pour le WiFi invité. Une connectivité utilisable l'est.
Quand conserver la détection et quand l'abandonner
C'est la question stratégique que de nombreuses équipes évitent. Certains parcs informatiques ont encore besoin d'un Captive Portal pour la collecte d'identité des invités, l'acceptation des conditions d'utilisation ou les flux d'accès publics. Très bien. Conservez-le, mais traitez la détection comme un chemin de repli soigneusement testé.
Pour les visiteurs réguliers, le personnel et les utilisateurs gérés, l'intérêt commercial de s'éloigner des portails captifs est de plus en plus fort. La couverture au Royaume-Uni de OpenRoaming et Passpoint indique que ces approches "tiennent enfin leurs promesses" en offrant une intégration automatique et sécurisée sans connexions répétées aux portails captifs. Un rapport sectoriel britannique indique que 38 % des personnes interrogées avaient déjà déployé un réseau conforme à OpenRoaming ou Passpoint, avec 32 % prévoyant des déploiements en 2026 et 18 % en 2027, comme projeté dans ce rapport (couverture de Networking+ sur l'orientation du sans-fil au Royaume-Uni).
Cela ne signifie pas que les portails vont disparaître demain. Cela signifie que de nombreux réseaux devraient cesser de concevoir leur architecture autour d'eux comme parcours utilisateur principal. Dans un parc d'entreprise moderne au Royaume-Uni, la détection de Captive Portal appartient souvent à la même catégorie que d'autres fonctionnalités de compatibilité héritées. Nécessaire à certains endroits. Préférable à minimiser dans beaucoup d'autres.
Si vous essayez de réduire les frictions du portail sans perdre le contrôle, Purple propose l'authentification WiFi invité, l'accès basé sur l'identité et la prise en charge d'approches telles que OpenRoaming et Passpoint qui peuvent réduire votre dépendance à la détection de Captive Portal. Si c'est la direction que prend votre parc, il vaut la peine de voir comment Purple s'intègre à votre pile réseau existante et à vos politiques d'intégration.