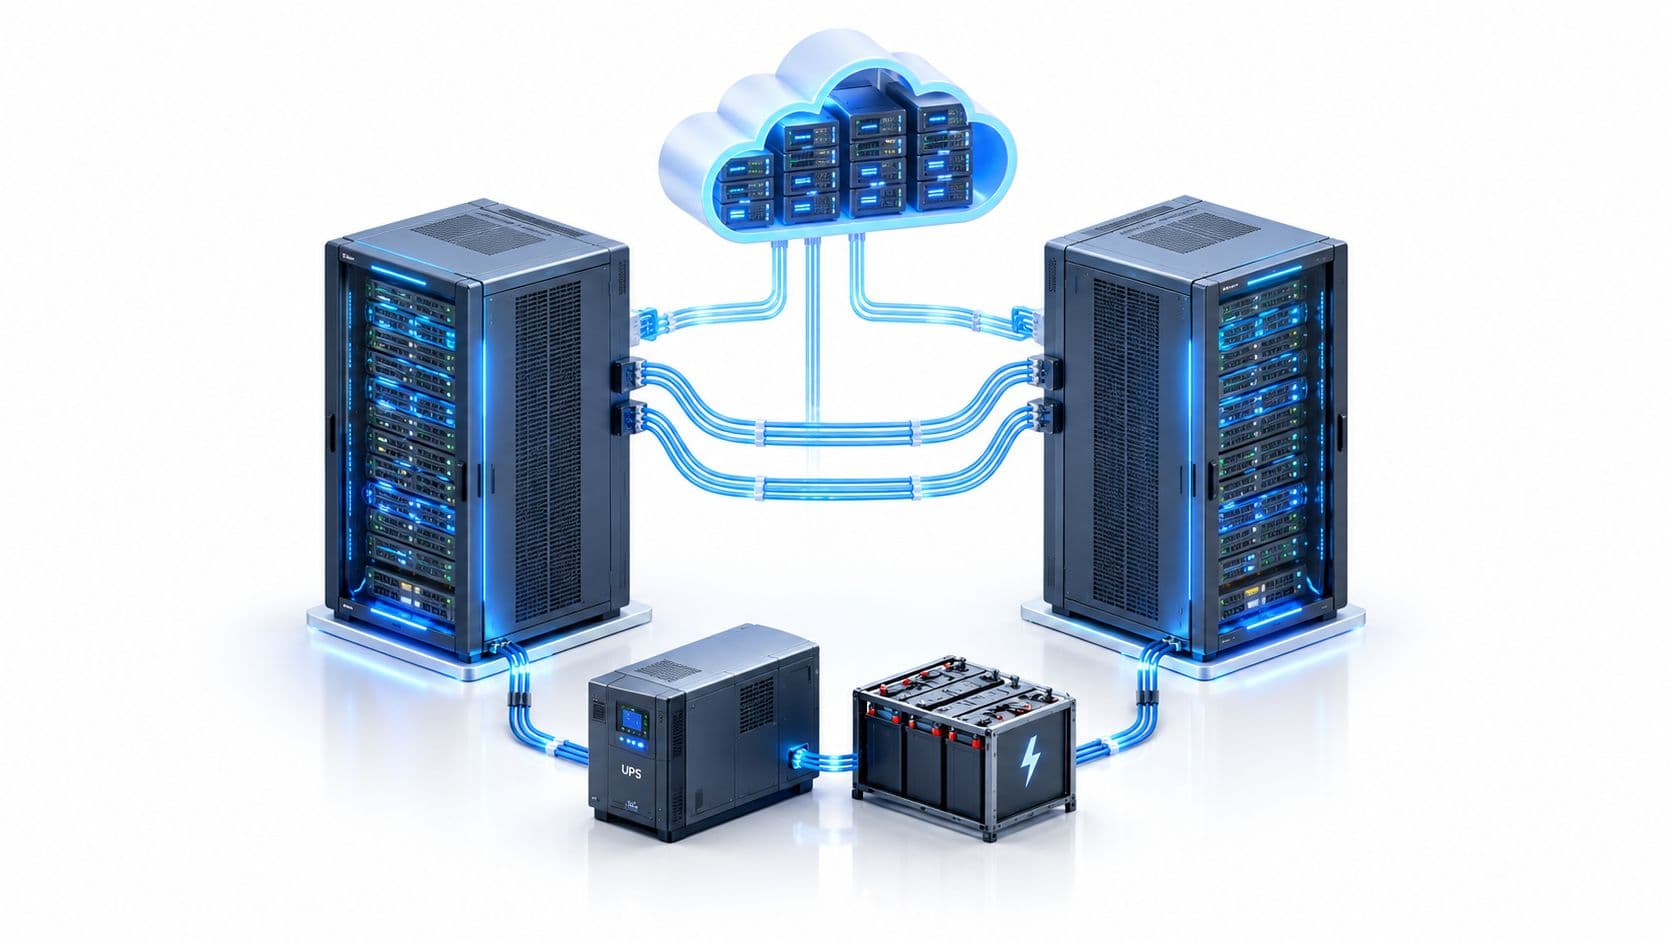
Un hôtel perd l'accès à internet pendant l'enregistrement. Les clients ne peuvent pas s'authentifier au WiFi, les terminaux de paiement par carte commencent à expirer, le personnel perd l'accès aux systèmes cloud et la réception commence à distribuer un mot de passe partagé que personne ne peut révoquer. Le circuit de secours existe, mais la politique de pare-feu n'a jamais été testée. Le second serveur RADIUS est configuré, mais personne ne sait si les points d'accès l'atteindront. L'onduleur signale un bon état car personne n'a vérifié la batterie en charge.
Il ne s'agit pas d'un problème matériel. C'est un échec de planification de la redondance.
La résilience réseau consiste à maintenir la disponibilité de l'authentification, de la connectivité et des services essentiels lorsqu'un composant, une liaison, un site, une alimentation électrique ou une dépendance d'identité tombe en panne. Un commutateur de rechange dans un placard ne crée pas de résilience. Un chemin testé qui maintient le fonctionnement d'un VLAN de paiement, d'une application clinique, d'une connexion d'employé ou d'une session WiFi invité le permet.
Ce que la planification de la redondance signifie réellement pour les réseaux modernes
La planification de la redondance réseau est une discipline de continuité d'activité, et non un exercice d'achat d'équipements. La question n'est pas de savoir si vous possédez deux commutateurs. Il s'agit de savoir si les utilisateurs peuvent toujours se connecter, s'authentifier, résoudre les services et accéder aux applications qui maintiennent l'activité après une défaillance définie.
Cela nécessite une vision claire des domaines de défaillance. Un domaine de défaillance est un composant ou une dépendance qui peut tomber en panne de manière indépendante et entraîner un service avec lui. Les domaines types incluent :
- Infrastructure d'accès, y compris les commutateurs, les points d'accès, les budgets PoE, les liaisons montantes et les contrôleurs WiFi.
- Services d'identité, y compris RADIUS, les intégrations d'annuaires, les certificats, les Captive Portals et les fournisseurs d'identité.
- Services centraux, y compris DHCP, DNS, les fonctions de passerelle et la politique réseau.
- Chemins externes, y compris les circuits WAN, les équipements FAI, les plateformes cloud et les services d'authentification tiers.
- Installations, y compris la distribution d'énergie, les batteries d'onduleurs, la couverture des générateurs et les répartiteurs intermédiaires.
Une architecture peut disposer de routeurs de cœur résilients et tout de même faillir à la périphérie. Si la résolution DNS s'arrête, les utilisateurs peuvent être connectés au WiFi sans pouvoir accéder aux services dont ils ont besoin. Si le serveur RADIUS cesse de répondre, un réseau sans fil en bonne santé peut rejeter chaque connexion de collaborateur ou d'invité. Si le Captive Portal dépend d'un chemin cloud inaccessible, le site peut disposer d'une couverture radio sans pour autant offrir un accès invité utilisable.
Séparez la continuité du service de la redondance des composants
Commencez par les services, pas par les équipements. Notez les services que l'entreprise doit préserver, puis retracez chaque dépendance sous-jacente pour chacun d'eux. L'authentification au WiFi invité, par exemple, peut dépendre des points d'accès, des commutateurs, du PoE, du plan de contrôle sans fil, du DHCP, du DNS, de l'accès WAN, du serveur RADIUS, du fournisseur d'identité et du portail lui-même.
Une référence de planification WiFi utile pour les équipes réseau devrait mener à la même conclusion : l'accès sans fil est un système opérationnel, pas une couche radio greffée sur le LAN.
Les employeurs du Royaume-Uni utilisent une définition légale distincte de la planification des licenciements collectifs. Lorsqu'un employeur envisage de licencier 20 salariés ou plus dans un même établissement sur une période glissante de 90 jours, la consultation collective s'applique, celle-ci devant débuter au moins 30 jours avant le premier licenciement pour 20 à 99 licenciements, ou 45 jours avant le premier licenciement pour 100 ou plus. Le guide de consultation du gouvernement britannique explique que la consultation doit porter sur les motifs des licenciements envisagés, les moyens de les éviter et les moyens d'en réduire le nombre. Il s'agit là d'un cadre de planification RH. La discipline réseau décrite ici concerne la défaillance de service, la cartographie des dépendances et l'architecture de récupération.
Règle pratique : Ne comptez pas les appareils de secours. Comptez les chemins indépendants reliant l'utilisateur au service.
Le reste de ce guide adopte cette approche pratique. Identifiez les risques de défaillance, fixez des objectifs de récupération qui reflètent les contraintes de l'entreprise, sélectionnez une architecture que votre équipe peut exploiter, protégez chaque couche, de l'alimentation à l'identité, et testez le résultat dans des conditions contrôlées. Si un composant n'a jamais failli lors d'un exercice, considérez sa redondance comme une hypothèse et non comme une capacité éprouvée.
Cartographier les risques de défaillance avant de concevoir la solution
La plupart des équipes réseau n'ont pas besoin d'une plateforme de gouvernance pour identifier leurs points de défaillance uniques les plus dangereux. Elles ont besoin d'un registre court qui nomme le risque, le classe de manière cohérente, lui attribue un propriétaire et indique si quelqu'un a contribué à le réduire.
Utilisez trois axes :
- La probabilité, c'est-à-dire la fréquence à laquelle la défaillance se produit dans des parcs comparables ou s'est produite dans votre propre environnement.
- Le rayon d'impact, c'est-à-dire le nombre d'utilisateurs, de sites, de services ou d'activités génératrices de revenus qui deviennent indisponibles.
- La difficulté de récupération, c'est-à-dire la complexité de la restauration avec les compétences, les accès, les pièces de rechange, le support des fournisseurs et la documentation dont vous disposez aujourd'hui.
Attribuez une note à chaque axe sur une échelle locale, puis multipliez les trois valeurs ou appliquez une formule pondérée. La cohérence importe plus que la formule mathématique elle-même. Un circuit WAN unique doit être classé prioritaire par rapport à un écran d'affichage marketing isolé, car sa panne peut affecter simultanément tous les services dépendants.
Construisez le registre autour des dépendances réelles
Incluez les actifs que les équipes négligent souvent. Un premier passage utile devrait contenir :
- Un seul FAI WAN ou circuit desservant l'ensemble du site.
- Un seul service RADIUS ou une seule intégration de fournisseur d'identité.
- Un seul chemin de résolveur DNS.
- Un seul contrôleur sans fil ou dépendance de gestion cloud.
- Une salle de répartiteur intermédiaire (IDF) sans couverture par générateur.
- Des batteries d'onduleur qui signalent leur état mais n'ont jamais été testées sous une charge significative.
- Un Captive Portal sans mode dégradé documenté.
- Une pile de commutateurs dont les liaisons montantes partagent une seule route physique.
- Un service DHCP sans procédure de récupération testée.
Le registre doit également mentionner le responsable du service, le responsable technique, la date de la dernière panne, la mesure d'atténuation actuelle, la date du test et la prochaine action. L'« équipe réseau » n'est pas un responsable en soi. Désignez nommément la personne ou l'équipe chargée d'organiser le changement et de prouver son bon fonctionnement.
Exemple de notation du registre des risques réseau
Le modèle suivant est un outil de travail, pas une affirmation concernant un parc particulier. Utilisez une échelle locale cohérente pour chaque axe et calculez le score final de la même manière pour chaque entrée.
| Scénario de défaillance | Probabilité (1-5) | Rayon d'impact (1-5) | Difficulté de récupération (1-5) | Score de risque |
|---|---|---|---|---|
| Circuit WAN unique | Évaluer localement | Évaluer localement | Évaluer localement | Probabilité × rayon d'impact × difficulté de récupération |
| Service RADIUS unique | Évaluer localement | Évaluer localement | Évaluer localement | Probabilité × rayon d'impact × difficulté de récupération |
| Chemin de résolution DNS unique | Évaluer localement | Évaluer localement | Évaluer localement | Probabilité × rayon d'impact × difficulté de récupération |
| Contrôleur sans fil unique | Évaluer localement | Évaluer localement | Évaluer localement | Probabilité × rayon d'impact × difficulté de récupération |
| Local répartiteurs (IDF) sans générateur | Évaluer localement | Évaluer localement | Évaluer localement | Probabilité × rayon d'impact × difficulté de récupération |
| Batteries d'onduleur non surveillées | Évaluer localement | Évaluer localement | Évaluer localement | Probabilité × rayon d'impact × difficulté de récupération |
N'attendez pas de disposer d'un registre parfait. Une liste d'une page avec des responsables identifiés est plus utile qu'un système de gestion des risques complexe que personne ne met à jour. L'objectif immédiat est la hiérarchisation. Identifiez les pannes susceptibles de paralyser les services critiques, puis utilisez ces résultats pour définir des objectifs de rétablissement et choisir votre architecture.
Les données de gestion officielles du Royaume-Uni montrent pourquoi une planification préalable structurée est essentielle dans un contexte de main-d'œuvre différent mais lié. Les employeurs ont soumis 368 formulaires HR1 couvrant 29 496 licenciements potentiels en janvier 2020, et 326 formulaires couvrant 27 804 licenciements potentiels en février 2020, selon les données de notification de licenciement du gouvernement. La leçon pour les responsables réseau est simple : la planification formelle existe parce que les changements opérationnels à grande échelle sont difficiles à improviser. Il en va de même lorsqu'un réseau multi-site perd une dépendance partagée.
Définir des objectifs de RTO et RPO alignés sur les contraintes réelles de l'entreprise
Le RTO et le RPO ne sont utiles que lorsque les responsables métiers peuvent les comprendre.
L'objectif de temps de récupération, ou RTO, est la durée maximale acceptable pendant laquelle un service peut rester indisponible. L'objectif de point de récupération, ou RPO, est la perte maximale acceptable de données, de configuration ou d'état de session depuis le dernier point de récupération. Pour un réseau, le RPO peut concerner la configuration, la politique, l'état des équipements, les journaux d'événements ou le contexte d'authentification actif, plutôt qu'une transaction de base de données classique.
Traduisez ces deux mesures en conséquences opérationnelles. Demandez ce qui s'arrête en premier lorsque le service échoue. La réception doit-elle faire patienter les clients ? Les caisses cessent-elles d'accepter les paiements ? Les cliniciens perdent-ils l'accès aux dossiers électroniques ? Un gestionnaire immobilier perd-il le contrôle d'accès des locataires ? Le responsable du service doit exprimer la conséquence métier, et non se contenter de répéter un objectif informatique.
Utilisez des niveaux de service plutôt qu'une seule promesse globale
Une cartographie pratique des services permet de séparer les accès critiques des services non urgents.
| Niveau de service | Exemples de services | RTO cible | RPO cible | Implication architecturale |
|---|---|---|---|---|
| Niveau 1 | Authentification WiFi invité, VLAN de paiement, accès aux applications cliniques | Quelques minutes, selon la tolérance de l'entreprise | Perte minimale de politique et d'état d'authentification | Voies indépendantes, basculement rapide, identité résiliente, alimentation testée |
| Niveau 2 | WiFi personnel, systèmes de back-office, synchronisation des données analytiques | Environ une heure, là où l'activité le permet | Configuration et état de service récents | Standby tiède, doubles voies lorsque cela est justifié, récupération documentée |
| Niveau 3 | Divertissement des invités, portails de marketing, rapports non critiques | Plusieurs heures peuvent être acceptables | Une récupération basée sur les sauvegardes peut suffire | Standby à moindre coût ou restauration manuelle |
Il s'agit d'exemples de planification, et non de niveaux de service universels. La finance doit valider l'objectif à l'aide d'un modèle de perte simple : contribution estimée au chiffre d'affaires horaire, perturbation opérationnelle, exposition de la réputation et impact sur la conformité, divisés par le temps d'arrêt que l'entreprise peut accepter. Évitez les fausses précisions. Un service de paiement peut n'avoir aucune "heure moyenne" significative car une courte panne pendant une période d'activité intense peut faire plus de dégâts qu'une panne plus longue au milieu de la nuit.
La valeur RTO doit également inclure le temps de détection et de décision. Un basculement qui se termine rapidement après qu'un ingénieur a constaté la panne peut tout de même manquer l'objectif de l'entreprise si la supervision met trop de temps à lever une alerte. Intégrez le comportement de propagation DNS, la réauthentification de session, la reconnexion des appareils, la convergence des pare-feu et l'escalade humaine dans l'estimation de la reprise.
Le RPO mérite la même rigueur. Si une modification de configuration effectuée peu de temps avant la panne disparaît, l'équipe peut-elle la recréer ? Si les sessions d'invités doivent se réauthentifier, est-ce acceptable ? Si un annuaire d'identité est temporairement indisponible, la couche d'accès peut-elle utiliser une politique valide connue sans affaiblir la sécurité ?
Des objectifs de RTO ambitieux nécessitent généralement une capacité actif-actif ou géographiquement indépendante. Un RTO plus flexible peut s'accommoder d'un secours tiède, d'une restauration documentée ou d'une récupération basée sur des sauvegardes. Ne recopiez pas un niveau de service d'entreprise à partir d'un contrat lorsque le site dépend encore d'un seul fournisseur d'accès Internet, d'une seule alimentation électrique ou d'un seul chemin d'identité. L'architecture doit justifier cet objectif.
Choisir la bonne architecture de basculement pour votre parc
Quatre modèles couvrent la majorité des déploiements de sites réels. Aucun n'est automatiquement correct. Le bon choix dépend de la tolérance aux temps d'arrêt, de la taille du parc, des compétences opérationnelles, de l'indépendance des pannes et du budget.
Le mode actif-actif maintient deux composants ou plus capables de desservir le trafic en même temps. Des contrôleurs doubles ou des clusters d'accès peuvent partager la demande, et un côté peut continuer à fonctionner en cas de panne de l'autre. Cela offre une excellente capacité en cas de panne, mais crée plus de synchronisation d'état, de cohérence des politiques et de risques de partitionnement réseau (split-brain). Utilisez-le lorsque les temps d'arrêt coûtent cher et que l'équipe dispose des compétences pour surveiller correctement les deux côtés.
L'architecture actif-passif maintient un composant de secours prêt à prendre le relais. Elle est plus simple à appréhender que l'actif-actif, mais la transition, le transfert d'état et la détection peuvent créer un délai de reprise. Un secours chaud n'a de valeur que s'il dispose d'une configuration à jour, de dépendances accessibles et d'un processus de transition testé.
La formule N+1 fournit une unité de capacité de réserve pour un cluster. C'est une réponse judicieuse lorsqu'un site peut tolérer le remplacement d'un composant mais ne peut pas justifier un environnement entièrement dupliqué. Le N+1 laisse tout de même le parc exposé à des pannes partagées, comme une alimentation électrique commune, une liaison montante commune ou une mauvaise configuration répliquée sur chaque unité.
La redondance géographique place une capacité de service complète sur un autre site ou dans une autre région. Elle permet de faire face à la perte d'un site entier, et pas seulement à une panne d'équipement, et représente la charge financière et opérationnelle la plus élevée. Elle est adaptée aux services partagés qui soutiennent plusieurs établissements ou aux organisations qui ne peuvent pas accepter qu'un bâtiment unique constitue un domaine de défaillance.
Comparaison des architectures de basculement
| Architecture | Coût | Complexité | RTO typique | Idéal pour |
|---|---|---|---|---|
| Actif-actif | Élevé | Élevé | Très court lorsqu'il est correctement exploité | Services critiques, parcs importants, équipes capables de gérer des systèmes synchronisés |
| Actif-passif | Moyen à élevé | Moyen | Court à modéré, selon la promotion | Sites nécessitant un standby prêt sans acheminer de trafic des deux côtés |
| N+1 | Moyen | Moyen | Modéré, selon le remplacement et le provisionnement | Clusters où un composant peut couvrir un pair défaillant |
| Redondance géographique | Le plus élevé | Le plus élevé | Court à prolongé, selon le routage et l'état | Opérateurs multi-sites et services exposés à une défaillance complète de site |
Un groupe hôtelier possédant deux établissements peut utiliser des services de type actif-actif entre les sites si le WAN, l'identité, le DNS, l'alimentation et la gestion opérationnelle sont véritablement indépendants. Un point de vente unique tire généralement plus de valeur d'un pare-feu résilient, d'un trafic segmenté et d'un secours LTE ou 5G que d'une architecture double centre de données qu'il ne peut pas exploiter.
Utilisez un raccourci de décision direct. Si les ressources en personnel sont limitées et que l'entreprise peut tolérer une reprise mesurée, choisissez le mode actif-passif ou N+1. Si les transactions critiques nécessitent une continuité et que l'équipe peut gérer la synchronisation, choisissez le mode actif-actif. Si la perte d'un site entier constitue le risque principal, la redondance géographique est la solution. Si le budget est serré, éliminez les dépendances à chemin unique par ordre d'impact sur l'activité plutôt que d'acheter un doublon de l'équipement le plus visible.
Conception de couches réseau, d'authentification et d'identité résilientes
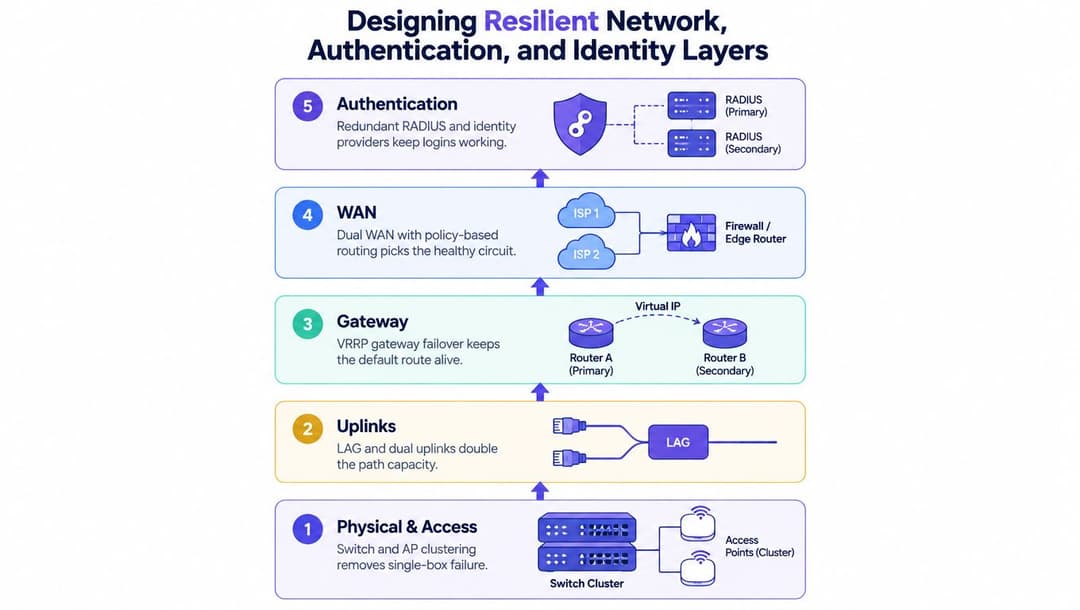
La résilience échoue toujours au niveau de la dépendance la plus faible. Construisez la pile à partir de la couche physique vers le haut, et attribuez à chaque couche un domaine de défaillance indépendant.
Commencez par l'accès et les liaisons montantes
Utilisez le regroupement de commutateurs et de points d'accès en cluster lorsque le parc l'exige, mais vérifiez que les membres du cluster ne partagent pas un domaine de défaillance unique. Deux commutateurs dans la même baie peuvent toujours dépendre d'une seule alimentation électrique. Deux liaisons montantes peuvent toujours suivre le même chemin de câbles. L'agrégation de liens peut fournir de la capacité et de la résilience de chemin, tandis que les liaisons montantes doubles réduisent la dépendance à l'égard d'un seul port, module ou câble.
Au niveau de la passerelle, utilisez VRRP ou un mécanisme de passerelle virtuelle équivalent afin que la route par défaut puisse basculer d'un équipement à l'autre. Testez le basculement d'un pare-feu dynamique plutôt que de supposer qu'une passerelle flottante préserve les sessions actives. Certains services se reconnectent proprement. D'autres nécessitent une gestion de session explicite.
La résilience du WAN doit associer des circuits distincts à un routage basé sur des règles qui prend en compte la qualité de service réelle, et non le simple état de la liaison. Un circuit peut rester actif sur le plan électrique tout en perdant le chemin vers les applications essentielles. La LTE ou la 5G offre un accès hors bande utile pour la gestion et un chemin de secours, mais nécessite sa propre couverture, alimentation, politique de données et contrôles de sécurité.
Traitez le DNS et l'alimentation comme des dépendances de production
Le DNS fait partie du parcours utilisateur. Utilisez une gestion délibérée du TTL, une capacité de résolution secondaire et une architecture split-horizon lorsque les réponses internes et externes doivent différer. Surveillez le temps de résolution et les échecs, pas seulement si un processus de résolution répond.
L'alimentation a également besoin de redondance. Combinez la protection par onduleur avec un budget PoE réaliste, séparez les sources d'alimentation là où le bâtiment le permet, et prévoyez une couverture par groupe électrogène pour les salles qui hébergent les dépendances réseau. Un onduleur doté d'une batterie défectueuse n'offre aucune résilience. Un groupe électrogène qui n'alimente pas la couche d'accès non plus.
Protégez l'authentification aussi soigneusement que la connectivité
Le service RADIUS doit disposer d'instances de service indépendantes et d'un ordre de basculement testé. Le comportement du Captive Portal nécessite un mode dégradé défini. Posez-vous la question de savoir si un utilisateur déjà authentifié peut continuer, si un nouvel utilisateur peut finaliser son parcours et ce qui se passe lorsque le fournisseur d'identité est injoignable.
Pour l'accès du personnel, un service RADIUS géré dans le cloud peut réduire la dépendance vis-à-vis d'un seul serveur sur site, mais il nécessite toujours une disponibilité multi-région, des points de terminaison surveillés, des certificats à jour et une responsabilité claire de la récupération. Le service RADIUS Entra ID de Purple est une option pour connecter l'accès réseau à l'identité basée sur l'annuaire tout en maintenant la couche d'authentification au cœur des discussions de résilience.
Chaque couche doit échouer de manière indépendante. Si les deux nœuds RADIUS partagent le même hôte virtuel, que les deux chemins DNS utilisent le même résolveur et que les deux circuits WAN entrent par la même gaine technique, le diagramme affiche une redondance, mais pas le parc réel.
Tests, surveillance et runbooks qui détectent réellement les pannes
L'architecture sur papier n'est pas l'architecture en production. La seule façon fiable de valider un chemin de basculement est de le tester dans des conditions contrôlées, d'observer l'expérience utilisateur et de corriger ce qui ne fonctionne pas.
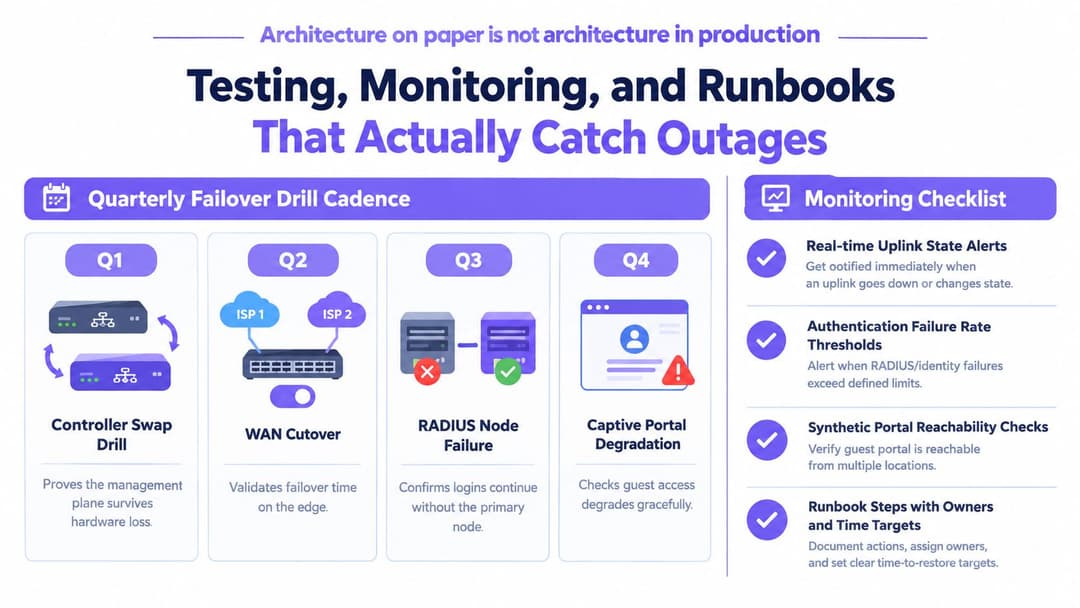
Exécutez un programme d'exercices trimestriels axé sur un type de défaillance différent à chaque cycle :
- Bascule de contrôleur : Prouvez que la gestion et le service sans fil continuent après le retrait du contrôleur principal.
- Bascule WAN : Validez la détection de circuit, le routage des politiques, l'état du pare-feu et l'accessibilité des applications.
- Panne de nœud RADIUS : Confirmez que les nouvelles connexions et la réauthentification utilisent le service secondaire.
- Dégradation du Captive Portal : Vérifiez que l'accès invité échoue de manière sécurisée et que les utilisateurs existants bénéficient de l'expérience prévue.
Le chaos contrôlé l'emporte sur un exercice théorique. Lors d'une nuit à faible risque, déconnectez un empilement de commutateurs, désactivez un chemin WAN ou isolez un nœud RADIUS avec une demande de changement approuvée. Limitez la portée du test, définissez un plan de retour arrière et demandez au responsable du service d'observer l'impact sur l'activité plutôt que de simplement regarder le tableau de bord de supervision.
Surveillez les symptômes, pas la vanité des équipements
Les signaux utiles comprennent :
- Accessibilité du contrôleur et état du cluster.
- Latence de réponse du serveur RADIUS et taux d'échec d'authentification.
- Temps de résolution DNS et échecs de requêtes.
- État d'association des points d'accès et réassociation des clients.
- Utilisation de la liaison montante, erreurs et changements de chemin.
- Accessibilité synthétique du Captive Portal.
- Santé du réseau WAN basée sur des sondes applicatives, et non sur le seul état de l'interface.
Définissez des seuils d'alerte basés sur l'impact client. Une légère augmentation des échecs d'authentification peut indiquer une panne d'identité avant même que les utilisateurs n'appellent le support. Une liaison montante saturée de manière prolongée peut être le signe avant-coureur d'un basculement dégradé. Ne contactez pas les ingénieurs pour chaque événement transitoire. Alertez-les lorsque plusieurs signaux se combinent pour former un symptôme de service.
Un manuel de procédures doit contenir un arbre de décision, les responsables d'escalade désignés, l'ordre de contact des fournisseurs, les exigences d'accès, les étapes de retour en arrière et des objectifs de temps liés au RTO du service. Incluez des captures d'écran ou les emplacements exacts de la console lorsque cela est approprié, mais ne vous appuyez pas sur le savoir informel. Après chaque exercice, enregistrez le temps de détection, le temps de décision, le temps de récupération, l'impact utilisateur et les modifications requises.
Le test de latence et de gigue de Purple WiFi peut vous aider à valider concrètement la qualité du réseau, mais aucun test ne remplace un véritable exercice de basculement. Si vous n'avez pas volontairement provoqué la panne d'une dépendance, vous ne l'avez pas validée.
Considérations sectorielles pour l'hôtellerie, le commerce, la santé et le WiFi multi-locataires
Le même schéma de résilience nécessite des priorités différentes selon les environnements. Commencez par classer les services, puis choisissez les contrôles d'identité et de réseau qui protègent le parcours utilisateur ayant la plus grande valeur.
| Secteur | Services critiques (Tier-1) | Posture de basculement recommandée | Risques clés liés à l'identité et au réseau |
|---|---|---|---|
| Hôtellerie | Authentification des invités, accès aux paiements, systèmes de gestion de propriété, connectivité du personnel | Double WAN, RADIUS résilient, récupération de Captive Portal testée, alimentation électrique protégée | Une dépendance à un portail ou à une authentification unique des invités peut perturber les arrivées et la prestation de services |
| Vente au détail | Trafic des points de vente, services de paiement, opérations du magasin, accès du personnel | VLANs isolés, périphérie (edge) résiliente, secours LTE ou 5G, basculement de circuit testé | Le trafic de paiement et opérationnel peut entrer en concurrence avec l'accès des invités sans une segmentation stricte |
| Santé | WiFi clinique, dossiers médicaux électroniques, télémétrie, BYOD approuvé | Couches réseau secourues par batterie, identité résiliente, récupération de chiffrement contrôlée, modifications prêtes pour l'audit | Une défaillance d'authentification ou d'alimentation peut interrompre les flux de travail cliniques et créer des risques de sécurité |
| Espaces multi-locataires | Accès locataires, WiFi des zones communes, opérations du bâtiment, services du personnel | SSIDs segmentés, politique sensible aux locataires, domaines d'authentification indépendants, chemins diversifiés | La défaillance de l'identité, du DNS ou de la politique d'un seul opérateur peut se propager en cascade à l'ensemble des locataires |
Les exploitants du secteur de l'hôtellerie doivent traiter le WiFi invité comme un canal opérationnel et commercial, et non comme un simple service de courtoisie. Les équipes du commerce de détail doivent maintenir les flux de paiement isolés du trafic invité et vérifier que le circuit de secours prend en charge le flux réel des transactions. Les administrateurs de la santé ont besoin d'historiques de modifications conformes aux audits, tout en vérifiant que les équipements sur batterie couvrent bien le chemin d'accès utilisé par les cliniciens.
Pour les stades, les bâtiments résidentiels, les espaces de coworking et autres sites multi-locataires, la segmentation doit s'étendre à l'authentification et au DNS. Des SSID distincts ne suffisent pas à garantir l'isolation des locataires si les politiques, les recherches d'identité ou les chemins de gestion restent partagés.
Une première étape judicieuse consiste à réaliser un inventaire pilote de 30 jours. Répertoriez les points d'accès, les commutateurs, les contrôleurs, les circuits WAN, les services d'identité, les DNS, l'alimentation et les propriétaires sur un site ou un établissement représentatif. Créez ensuite une carte des SLA par niveau pour le secteur, effectuez un test de basculement contrôlé et utilisez les résultats pour financer la prochaine réduction des risques. La pression actuelle sur la planification des effectifs rend également crucial l'aspect du risque humain. Le CIPD Labour Market Outlook pour l'été 2026 a indiqué que 21 % des employeurs britanniques prévoyaient des licenciements au cours des trois mois précédant septembre 2026. Moins de personnel signifie moins de tolérance pour le travail de reprise non documenté - concevez donc les manuels opérationnels et attribuez les responsabilités avant le prochain changement d'effectifs.
Les obligations de licenciement collectif au Royaume-Uni font également des parcs fragmentés un problème de calendrier et de données. Les directives du gouvernement sur les consultations de licenciement stipulent que le seuil de 20 personnes ou plus s'applique à un seul établissement dans un délai de 90 jours, le calendrier de notification étant lié à la période de licenciement envisagée. Pour les responsables réseau, la leçon analogue est de cartographier précisément les sites et les dépendances. Un parc multi-site ne peut pas simplement supposer que des bâtiments, circuits ou équipes distincts créent des domaines de défaillance isolés sans prouver comment le trafic, l'identité et les opérations sont interconnectés.
Purple fournit une authentification WiFi gérée dans le cloud et un accès basé sur l'identité, y compris une fonctionnalité RADIUS conçue avec des chemins de service redondants, afin de s'intégrer dans un plan de résilience plutôt que de laisser la connexion des invités devenir un point de défaillance unique caché. Découvrez comment Purple s'adapte à votre réseau, à vos identités et à vos exigences de basculement, puis commencez par un inventaire au niveau de l'établissement et un exercice d'authentification contrôlé.