Um hotel perde o acesso à internet durante o check-in. Os hóspedes não se conseguem autenticar no WiFi, os terminais de pagamento começam a falhar por esgotamento de tempo, a equipa perde o acesso aos sistemas de nuvem e a receção começa a distribuir uma palavra-passe partilhada que ninguém pode revogar. O circuito de cópia de segurança existe, mas a política da firewall nunca foi testada. O segundo servidor RADIUS está configurado, mas ninguém sabe se os pontos de acesso irão conseguir chegar até ele. A UPS está a reportar um estado saudável porque ninguém testou a bateria sob carga.
Isso não é um problema de hardware. É uma falha no planeamento de redundância.
Resiliência de rede significa manter a autenticação, a conectividade e os serviços essenciais disponíveis quando um componente, ligação, local, alimentação de energia ou dependência de identidade falha. Um switch sobressalente num armário não cria resiliência. Um caminho testado que mantém uma VLAN de pagamentos, uma aplicação clínica, o início de sessão da equipa ou uma sessão de WiFi de convidados a funcionar, sim.
O que o Planeamento de Redundância Realmente Significa para as Redes Modernas
O planeamento de redundância de rede é uma disciplina de continuidade de negócio, não um exercício de compra de equipamento. A questão não é se possui dois switches. É se os utilizadores continuam a conseguir ligar-se, autenticar-se, resolver serviços e aceder às aplicações que mantêm a operação a funcionar após uma falha definida.
Isso exige uma visão clara dos domínios de falha. Um domínio de falha é um componente ou dependência que pode falhar de forma independente e arrastar um serviço consigo. Os domínios típicos incluem:
- Infraestrutura de acesso, incluindo switches, pontos de acesso, orçamentos PoE, uplinks e controladores sem fios.
- Serviços de identidade, incluindo RADIUS, integrações de diretórios, certificados, Captive Portals e fornecedores de identidade.
- Serviços principais, incluindo DHCP, DNS, funções de gateway e política de rede.
- Caminhos externos, incluindo circuitos WAN, equipamentos de ISP, plataformas de nuvem e serviços de autenticação de terceiros.
- Instalações, incluindo distribuição de energia, baterias de UPS, cobertura de geradores e salas de quadros de distribuição intermédios.
Um design pode ter routers core resilientes e mesmo assim falhar na periferia. Se a resolução de DNS parar, os utilizadores podem estar ligados ao WiFi mas incapazes de aceder aos serviços de que necessitam. Se o RADIUS parar de responder, uma rede sem fios saudável pode rejeitar todos os logins de funcionários ou convidados. Se o Captive Portal depender de um caminho de cloud inacessível, o local pode ter cobertura de rádio mas sem acesso de convidado utilizável.
Separe a continuidade do serviço da redundância de componentes
Comece pelos serviços, não pelos dispositivos. Escreva os serviços que a empresa deve preservar e, em seguida, rastreie todas as dependências subjacentes a cada um deles. A autenticação do WiFi de convidados, por exemplo, pode depender de pontos de acesso, comutação, PoE, plano de controlo sem fios, DHCP, DNS, acesso WAN, RADIUS, fornecedor de identidade e do próprio portal.
Uma referência útil de planeamento de WiFi para equipas de rede deve levar à mesma conclusão: o acesso sem fios é um sistema operacional, não uma camada de rádio acoplada à LAN.
Os empregadores do Reino Unido utilizam um significado legal distinto para o planeamento de despedimento coletivo. Quando um empregador se propõe a despedir 20 ou mais colaboradores num único estabelecimento num período móvel de 90 dias, aplica-se a consulta coletiva, devendo esta iniciar-se pelo menos 30 dias antes do primeiro despedimento para 20 a 99 despedimentos, ou 45 dias antes do primeiro despedimento para 100 ou mais. O guia de consulta do governo do Reino Unido explica que a consulta deve abordar os motivos dos despedimentos propostos, formas de os evitar e formas de reduzir o número de despedimentos. Trata-se de um enquadramento de planeamento de Recursos Humanos. A disciplina de rede descrita aqui diz respeito à falha de serviços, ao mapeamento de dependências e à arquitetura de recuperação.
Regra prática: Não conte os dispositivos de cópia de segurança. Conte os caminhos independentes do utilizador ao serviço.
O resto deste guia utiliza essa perspetiva prática. Identifique os riscos de falha, defina metas de recuperação que reflitam o impacto no negócio, selecione uma arquitetura que a sua equipa consiga operar, proteja todas as camadas - desde a energia à identidade - e teste o resultado sob condições controladas. Se um componente nunca falhou numa simulação, trate a sua redundância como uma suposição, não como uma capacidade.
Mapear os Riscos de Falha Antes de Desenhar a Solução
A maioria das equipas de rede não precisa de uma plataforma de governação para encontrar os seus pontos únicos de falha mais perigosos. Precisam de um registo curto que identifique o risco, o classifique de forma consistente, atribua um proprietário e registe se alguém o mitigou.
Utilize três eixos:
- Probabilidade, ou seja, a frequência com que a falha ocorre em infraestruturas comparáveis ou ocorreu no seu próprio ambiente.
- Raio de impacto, ou seja, quantos utilizadores, locais, serviços ou atividades geradoras de receita ficam indisponíveis.
- Dificuldade de recuperação, ou seja, quão difícil é a restauração com as competências, acessos, peças sobressalentes, suporte do fornecedor e documentação de que dispõe hoje.
Classifique cada eixo numa escala local, depois multiplique os três valores ou aplique uma fórmula ponderada. A matemática importa menos do que a consistência. Um circuito WAN único deve ser classificado acima de um ecrã de marketing isolado porque a sua falha pode afetar todos os serviços dependentes de uma só vez.
Construa o registo com base em dependências reais
Inclua ativos que as equipas costumam ignorar. Uma primeira análise útil deve conter:
- Um único ISP WAN ou circuito a servir todo o espaço.
- Um serviço RADIUS ou uma integração de fornecedor de identidade.
- Um caminho de resolvedor DNS.
- Um único controlador sem fios ou dependência de gestão na nuvem.
- Uma sala de bastidor de distribuição intermédia sem cobertura de gerador.
- Baterias de UPS que reportam o estado mas que nunca foram testadas sob uma carga significativa.
- Um Captive Portal sem modo de degradação documentado.
- Um empilhamento de switches cujos uplinks partilham uma rota física.
- Un serviço DHCP sem procedimento de recuperação testado.
O registo também deve registar o proprietário do serviço, proprietário técnico, data da última falha, mitigação atual, data do teste e próxima ação. "Equipa de rede" não é um proprietário. Nomeie a pessoa ou equipa responsável por planear a alteração e provar que esta funciona.
Exemplo de pontuação do registo de riscos de rede
O modelo seguinte é um modelo de trabalho, não uma afirmação sobre qualquer infraestrutura específica. Utilize uma escala local consistente para cada eixo e calcule a pontuação final da mesma forma para todas as entradas.
| Cenário de Falha | Probabilidade (1-5) | Raio de Impacto (1-5) | Dificuldade de Recuperação (1-5) | Pontuação de Risco |
|---|---|---|---|---|
| Circuito WAN único | Avaliar localmente | Avaliar localmente | Avaliar localmente | Probabilidade × raio de impacto × dificuldade de recuperação |
| Serviço RADIUS único | Avaliar localmente | Avaliar localmente | Avaliar localmente | Probabilidade × raio de impacto × dificuldade de recuperação |
| Caminho de resolução DNS único | Avaliar localmente | Avaliar localmente | Avaliar localmente | Probabilidade × raio de impacto × dificuldade de recuperação |
| Controlador sem fios único | Avaliar localmente | Avaliar localmente | Avaliar localmente | Probabilidade × raio de impacto × dificuldade de recuperação |
| Sala IDF sem gerador | Avaliar localmente | Avaliar localmente | Avaliar localmente | Probabilidade × raio de impacto × dificuldade de recuperação |
| Baterias UPS não monitorizadas | Avaliar localmente | Avaliar localmente | Avaliar localmente | Probabilidade × raio de impacto × dificuldade de recuperação |
Não espere por um registo perfeito. Uma lista de uma página com proprietários credíveis é mais útil do que um sistema de risco polido que ninguém atualiza. O objetivo imediato é a priorização. Classifique as falhas que podem desativar serviços críticos e, em seguida, utilize esses resultados para definir metas de recuperação e escolher a arquitetura.
As informações oficiais de gestão do Reino Unido mostram porque é que o planeamento estruturado e antecipado é importante num contexto laboral diferente, mas relacionado. Os empregadores submeteram 368 formulários HR1 abrangendo 29.496 potenciais despedimentos em janeiro de 2020, e 326 formulários abrangendo 27.804 potenciais despedimentos em fevereiro de 2020, de acordo com os dados de notificação de despedimento do governo. A lição para os líderes de rede é simples: o planeamento formal existe porque as grandes alterações operacionais são difíceis de improvisar. O mesmo se aplica quando uma rede multi-site perde uma dependência partilhada.
Definir Metas de RTO e RPO que Correspondam à Dor Real do Negócio
O RTO e o RPO só são úteis quando os proprietários do negócio os conseguem compreender.
O objetivo de tempo de recuperação, ou RTO, é o tempo máximo aceitável que um serviço pode permanecer indisponível. O objetivo de ponto de recuperação, ou RPO, é a perda máxima aceitável de dados, configuração ou estado da sessão desde o último ponto recuperável. Para uma rede, o RPO pode dizer respeito à configuração, política, estado do dispositivo, registos de eventos ou contexto de autenticação ativa, em vez de uma transação de base de dados tradicional.
Traduza ambas as medidas em consequências operacionais. Pergunte o que para primeiro quando o serviço falha. A receção coloca os convidados em fila? As caixas registadoras param de aceitar pagamentos? Os médicos perdem o acesso aos registos eletrónicos? Um gestor de propriedade perde o controlo de acesso dos inquilinos? O proprietário do serviço deve indicar a consequência para o negócio, e não apenas repetir um objetivo de TI.
Utilize níveis de serviço em vez de uma promessa para toda a propriedade
Um mapa de serviços prático separa o acesso crítico dos serviços que podem esperar.
| Nível de Serviço | Exemplos de Serviços | RTO Alvo | RPO Alvo | Implicação na Arquitetura |
|---|---|---|---|---|
| Nível 1 | Autenticação de guest WiFi, VLAN de pagamentos, acesso a aplicações clínicas | Minutos, com base na tolerância do negócio | Perda mínima de política e de estado de autenticação | Caminhos independentes, failover rápido, identidade resiliente, energia testada |
| Nível 2 | WiFi para colaboradores, sistemas de back-office, sincronização de analítica | Cerca de uma hora, sempre que a operação o permita | Configuração recente e estado do serviço | Warm standby, caminhos duplos quando justificado, recuperação documentada |
| Nível 3 | Entretenimento para convidados, páginas de portal (splash pages) de marketing, relatórios não críticos | Várias horas podem ser aceitáveis | A recuperação baseada em cópias de segurança (backups) pode ser suficiente | Standby de menor custo ou restauração manual |
Estes são exemplos de planeamento, não níveis de serviço universais. O departamento financeiro deve validar o objetivo utilizando um modelo de perda simples: estimativa da contribuição de receita horária, perturbação operacional, exposição de reputação e impacto de conformidade, divididos pelo tempo de inatividade que a empresa consegue aceitar. Evite a falsa precisão. Um serviço de pagamentos pode não ter uma "hora média" significativa, uma vez que uma breve interrupção durante um período de pico de atividade pode prejudicar mais do que uma interrupção mais longa durante a noite.
O RTO também deve incluir o tempo de deteção e de decisão. Uma falha de redundância que seja resolvida rapidamente após um engenheiro notar a falha pode ainda assim falhar o objetivo de negócio se a monitorização demorar demasiado tempo a emitir um alerta. Inclua o comportamento de propagação de DNS, a reautenticação de sessão, a religação de dispositivos, a convergência de firewall e a escalada humana na estimativa de recuperação.
O RPO merece a mesma disciplina. Se uma alteração de configuração efetuada pouco antes da falha desaparecer, a equipa consegue recriá-la? Se as sessões de convidados tiverem de se reautenticar, isso é aceitável? Se um diretório de identidade estiver temporariamente indisponível, a camada de acesso pode utilizar uma política comprovadamente boa sem enfraquecer a segurança?
Metas de RTO agressivas requerem normalmente capacidade ativo-ativo ou geograficamente independente. Um RTO mais flexível pode suportar um warm standby, restauro documentado ou recuperação baseada em backups. Não copie um nível de serviço empresarial de um contrato quando o local ainda depende de um único ISP, de uma única alimentação elétrica ou de um único caminho de identidade. A arquitetura tem de justificar a meta.
Escolher a Arquitetura de Failover Certa para a Sua Infraestrutura
Quatro padrões cobrem a maioria das implementações em locais reais. Nenhum é automaticamente o correto. A escolha certa depende da tolerância ao tempo de inatividade, do tamanho da infraestrutura, da competência operacional, da independência de falhas e do orçamento.
O modelo Ativo-ativo mantém dois ou mais componentes capazes a processar tráfego em simultâneo. Controladores duplos ou clusters de acesso podem partilhar a procura, e um dos lados pode continuar a funcionar quando o outro falha. Isto proporciona uma excelente capacidade durante as falhas, mas cria uma maior necessidade de sincronização de estados, consistência de políticas e risco de cenários "split-brain". Utilize esta abordagem quando o tempo de inatividade for dispendioso e a equipa puder monitorizar ambos os lados adequadamente.
Ativo-passivo mantém um componente de reserva pronto a assumir o controlo. É mais fácil de compreender do que o ativo-ativo, mas a promoção, a transferência de estado e a deteção podem criar uma lacuna na recuperação. Uma reserva ativa só é valiosa se tiver a configuração atual, dependências acessíveis e um processo de promoção testado.
N+1 fornece uma unidade de capacidade sobressalente para um cluster. É uma resposta sensata quando um local pode tolerar a substituição de um componente mas não consegue justificar um ambiente totalmente duplicado. O N+1 ainda deixa a infraestrutura exposta a falhas partilhadas, tais como uma alimentação de energia comum, um uplink comum ou uma configuração incorreta replicada em todas as unidades.
A redundância geográfica coloca uma capacidade de serviço completa noutro local ou região. Resolve a perda de um local, não apenas a falha de equipamentos, e acarreta o maior encargo operacional e de capital. É adequada para serviços partilhados que suportam várias propriedades ou para organizações que não podem aceitar um único edifício como um domínio de falha.
Comparação de arquiteturas de failover
| Arquitetura | Custo | Complexidade | RTO Típico | Melhor Ajuste |
|---|---|---|---|---|
| Ativo-ativo | Alto | Alto | Muito curto quando operado corretamente | Serviços críticos, infraestruturas maiores, equipas capazes de gerir sistemas sincronizados |
| Ativo-passivo | Médio a alto | Médio | Curto a moderado, dependendo da ativação | Instalações que necessitam de um standby pronto sem processar tráfego em ambos os lados |
| N+1 | Médio | Médio | Moderado, dependendo da substituição e do aprovisionamento | Clusters onde um componente pode cobrir a falha de um par |
| Redundância geográfica | Mais elevado | Mais elevado | Curto a prolongado, dependendo do encaminhamento e do estado | Operadores multi-site e serviços expostos a falhas totais de instalações |
Um grupo hoteleiro com duas propriedades pode utilizar serviços ativo-ativo entre locais se a WAN, a identidade, o DNS, a energia e a propriedade operacional forem genuinamente independentes. Uma única loja de retalho geralmente obtém mais valor de uma firewall resiliente, tráfego segmentado e cópia de segurança LTE ou 5G do que de um design de segundo centro de dados que não consegue operar.
Utilize um atalho de decisão direta. Se os recursos da equipa forem limitados e a empresa puder tolerar uma recuperação moderada, escolha ativo-passivo ou N+1. Se as transações críticas necessitarem de continuidade e a equipa puder gerir a sincronização, escolha ativo-ativo. Se uma infraestrutura inteira for o risco dominante, a redundância geográfica é a resposta. Se o orçamento for limitado, remova as dependências de caminho único por ordem de impacto comercial, em vez de comprar um duplicado do dispositivo mais visível.
Conceber Redes, Autenticação e Camadas de Identidade Resilientes
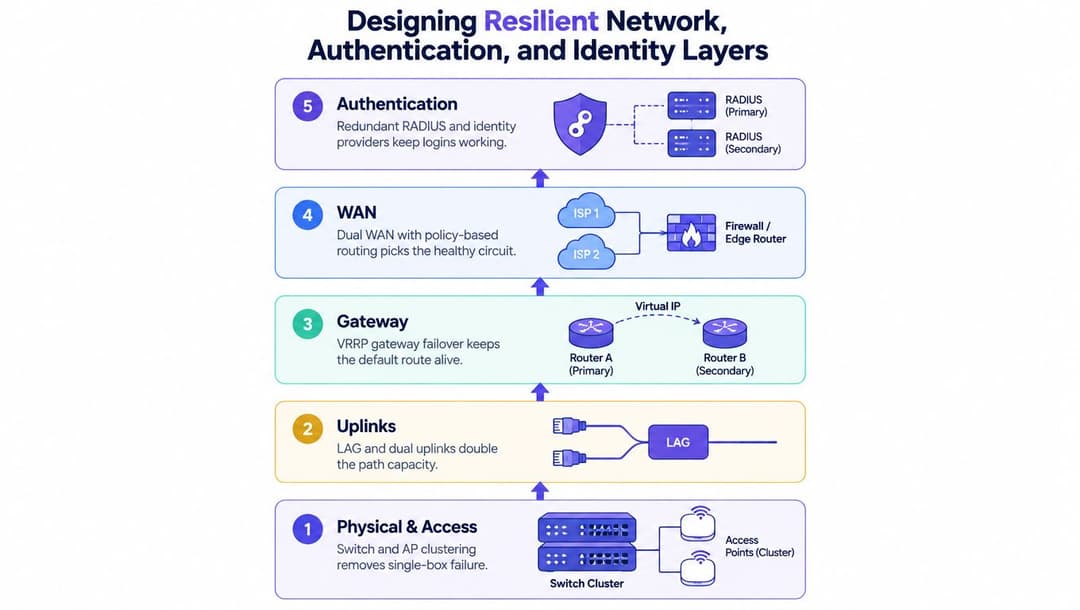
A resiliência falha na dependência mais fraca. Construa a stack a partir da camada física para cima e atribua a cada camada um domínio de falha independente.
Comece pelo acesso e uplinks
Utilize clustering de switches e access points onde a infraestrutura o exigir, mas verifique se os membros do cluster não partilham um domínio de falha único. Dois switches no mesmo bastidor podem ainda assim depender de uma única alimentação elétrica. Dois uplinks podem ainda assim seguir pela mesma calha de cabos. A agregação de links pode fornecer capacidade e resiliência de caminho, enquanto os uplinks duplos reduzem a dependência de uma única porta, módulo ou cabo.
No gateway, utilize VRRP ou um mecanismo de gateway virtual equivalente para que a rota predefinida se possa mover entre dispositivos. Teste o failover de firewall com inspeção de estado (stateful) em vez de assumir que um gateway flutuante preserva as sessões ativas. Alguns serviços ligam-se novamente de forma limpa. Outros necessitam de tratamento de sessão explícito.
A resiliência de WAN deve combinar circuitos separados com encaminhamento baseado em políticas que reconheça o estado de funcionamento, e não apenas o estado da ligação. Um circuito pode manter-se eletricamente ativo enquanto perde o caminho para as aplicações que importam. O LTE ou 5G fornece um acesso out-of-band útil para gestão e um caminho de redundância, mas precisa da sua própria cobertura, energia, política de dados e controlos de segurança.
Trate o DNS e a alimentação elétrica como dependências de produção
O DNS faz parte do percurso do utilizador. Utilize uma gestão deliberada de TTL, capacidade de resolução secundária e um design split-horizon onde as respostas internas e externas precisam de diferir. Monitorize o tempo de resolução e as falhas, e não apenas se o processo de um resolver responde.
A energia também necessita de camadas. Combine a proteção por UPS com um orçamento PoE realista, fontes de alimentação separadas onde o edifício o suporte e cobertura por gerador para as salas que alojam dependências de rede. Uma UPS com uma bateria falhada não é resiliência. Um gerador que não chega à camada de acesso também não.
Proteja a autenticação com o mesmo cuidado que a conectividade
O RADIUS deve ter instâncias de serviço independentes e uma ordem de failover testada. O comportamento do Captive Portal necessita de um modo degradado definido. Pergunte se um utilizador que já se autenticou pode continuar, se um novo utilizador pode concluir o percurso e o que acontece quando o fornecedor de identidade está inacessível.
Para o acesso da equipa, um serviço RADIUS gerido na nuvem pode reduzir a dependência de um único servidor local, mas ainda assim necessita de disponibilidade multi-região, monitorização de endpoints, certificados atualizados e uma clara atribuição de responsabilidades de recuperação. O serviço RADIUS para Entra ID da Purple é uma opção para ligar o acesso à rede com a identidade baseada em diretório, mantendo a camada de autenticação no centro da discussão sobre resiliência.
Cada camada deve falhar de forma independente. Se ambos os nós RADIUS utilizarem o mesmo anfitrião virtual, ambos os caminhos de DNS utilizarem o mesmo resolvedor e ambos os circuitos WAN entrarem pela mesma conduta, o diagrama é redundante mas a infraestrutura não é.
Testes, Monitorização e Runbooks que Realmente Detetam Falhas
A arquitetura no papel não é a arquitetura em produção. A única forma fiável de validar um caminho de failover é testá-lo sob condições controladas, observar a experiência do utilizador e corrigir o que falhar.
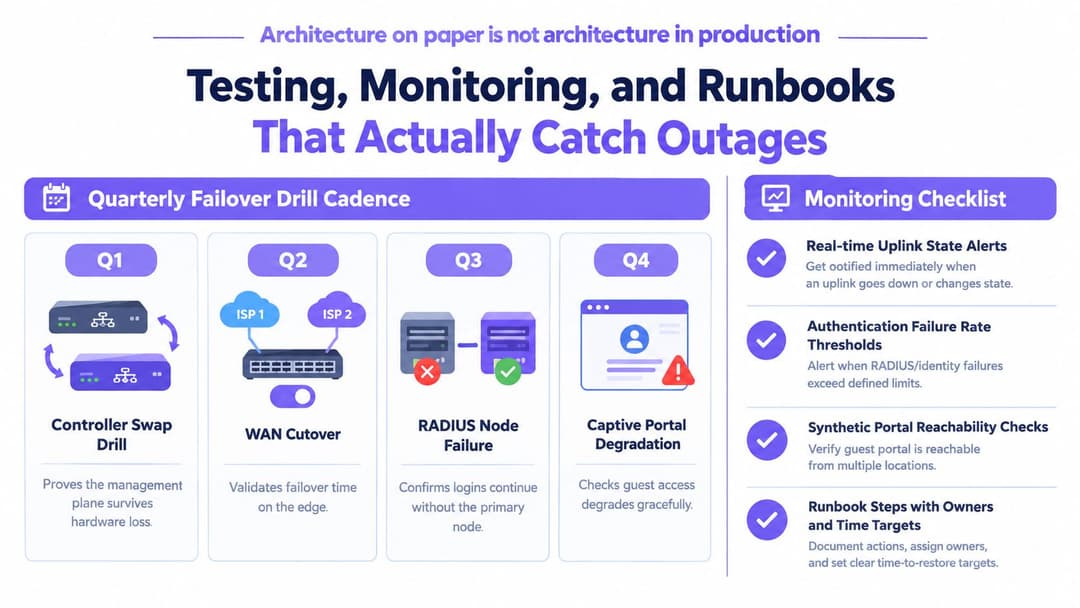
Execute um programa trimestral de simulações com um foco de falha diferente a cada ciclo:
- Substituição de controlador: Prove que a gestão e o serviço sem fios continuam após a remoção do controlador primário.
- Comutação de WAN: Valide a deteção de circuitos, o encaminhamento de políticas, o estado da firewall e a acessibilidade das aplicações.
- Falha no nó RADIUS: Confirme que os novos inícios de sessão e a reautenticação utilizam o serviço secundário.
- Degradação do Captive Portal: Verifique se o acesso de convidados falha de forma segura e se os utilizadores existentes recebem a experiência pretendida.
O caos controlado supera um exercício teórico. Numa noite de baixo risco, desligue uma pilha de switches, desative um caminho WAN ou isole um nó RADIUS com um registo de alteração aprovado. Mantenha o teste delimitado, defina uma reversão e faça com que o proprietário do serviço assista ao resultado de negócio em vez de apenas olhar para o painel de monitorização.
Monitorize sintomas, não a vaidade dos dispositivos
Sinais úteis incluem:
- Acessibilidade do controlador e estado do cluster.
- Latência de resposta do RADIUS e taxa de falha de autenticação.
- Tempo de resolução de DNS e pesquisas falhadas.
- Estado de associação do ponto de acesso e reassociação do cliente.
- Utilização da ligação ascendente, erros e alterações de caminho.
- Acessibilidade sintética do Captive Portal.
- Estado da WAN com base em testes de aplicação, e não apenas no estado da interface.
Defina limiares de alerta em torno do impacto para o cliente. Um pequeno aumento nas falhas de autenticação pode indicar uma interrupção de identidade antes que os utilizadores liguem para o suporte técnico. Um uplink em capacidade sustentada pode ser um precursor de uma falha de redundância degradada. Não envie alertas urgentes aos engenheiros para cada evento transitório. Envie sim quando vários sinais se combinam num sintoma de serviço.
Um runbook deve conter uma árvore de decisão, responsáveis de escalamento designados, ordem de contacto dos fornecedores, requisitos de acesso, etapas de rollback e metas de tempo associadas ao RTO do serviço. Inclua capturas de ecrã ou localizações exatas de consola onde apropriado, mas não dependa de conhecimento informal. Após cada simulação, registe o tempo de deteção, tempo de decisão, tempo de recuperação, impacto no utilizador e a alteração necessária.
O teste de latência e jitter Purple WiFi pode apoiar a validação prática da qualidade da rede, mas nenhum teste substitui um exercício real de failover. Se não falhou uma dependência de propósito, não a validou.
Considerações Específicas do Setor para Hotelaria, Retalho, Saúde e WiFi Multi-Tenant
O mesmo modelo de resiliência necessita de prioridades diferentes em ambientes distintos. Comece por classificar os serviços e, em seguida, escolha os controlos de identidade e de rede que protegem a jornada do utilizador de maior valor.
| Setor | Serviços de Nível 1 | Postura de Failover Recomendada | Principal Risco de Identidade e Rede |
|---|---|---|---|
| Hotelaria | Autenticação de convidados, acesso a pagamentos, sistemas da propriedade, conectividade do pessoal | WAN dupla, RADIUS resiliente, recuperação de Captive Portal testada, energia protegida | Uma dependência de portal ou início de sessão de convidado partilhado pode perturbar o check-in e a prestação do serviço |
| Retalho | Tráfego de POS, serviços de pagamento, operações de loja, acesso do pessoal | VLANs isoladas, edge resiliente, backup LTE ou 5G, transição de circuito testada | O tráfego de pagamentos e operacional pode competir com o acesso de convidados sem uma segmentação rigorosa |
| Saúde | WiFi clínico, registos eletrónicos, telemetria, BYOD aprovado | Camadas de rede com backup de bateria, identidade resiliente, recuperação de encriptação controlada, alterações prontas para auditoria | Uma falha de autenticação ou de energia pode interromper os fluxos de trabalho clínicos e criar riscos de segurança |
| Espaços multi-inquilino | Acesso de inquilinos, WiFi de áreas comuns, operações do edifício, serviços do pessoal | SSIDs segmentados, política sensível ao inquilino, domínios de autenticação independentes, caminhos diversos | A falha de identidade, DNS ou política de um único operador pode propagar-se em cascata por todos os inquilinos |
Os operadores de hotelaria devem tratar o WiFi de convidados como um canal operacional e comercial, não como um serviço de cortesia. As equipas de retalho devem manter os caminhos de pagamento isolados do tráfego de convidados e verificar se o circuito de backup suporta o fluxo real de transações. Os administradores de saúde necessitam de registos de alterações que resistam a auditorias, verificando também se o equipamento alimentado por bateria cobre o caminho de acesso que os médicos utilizam.
Para estádios, edifícios residenciais, espaços de coworking e outros locais multi-tenant, a segmentação deve estender-se à autenticação e ao DNS. SSIDs separados por si só não garantem o isolamento dos tenants se as políticas, as pesquisas de identidade ou os caminhos de gestão continuarem a ser partilhados.
Um primeiro passo sensato é um inventário piloto de 30 dias. Catalogue pontos de acesso, switches, controladores, circuitos WAN, serviços de identidade, DNS, energia e proprietários numa propriedade ou espaço representativo. De seguida, crie um mapa de SLA estruturado para o setor, execute uma falha controlada e utilize os resultados para financiar a próxima redução de riscos. A atual pressão sobre o planeamento da força de trabalho também torna importante a perspetiva do risco humano. O CIPD Labour Market Outlook para o verão de 2026 revelou que 21% dos empregadores do Reino Unido planeavam despedimentos nos três meses anteriores a setembro de 2026. Menos pessoas significa menor tolerância para tarefas de recuperação não documentadas, por isso desenhe manuais de procedimentos (runbooks) e atribua responsabilidades antes da próxima alteração de pessoal.
Os deveres de despedimento coletivo no Reino Unido também tornam as propriedades fragmentadas num problema de prazos e dados. As diretrizes do governo sobre consultas de despedimento estabelecem que o limite de 20 ou mais funcionários se aplica a um estabelecimento no prazo de 90 dias, com o calendário de notificação associado ao intervalo de despedimento proposto. Para os líderes de rede, a lição análoga é mapear locais e dependências com precisão. Uma infraestrutura multi-site não pode assumir com segurança que edifícios, circuitos ou equipas separados criam domínios de falha independentes sem provar como o tráfego, a identidade e as operações se ligam.
A Purple disponibiliza autenticação WiFi gerida na nuvem e acesso baseado em identidade, incluindo funcionalidade RADIUS concebida com caminhos de serviço redundantes, pelo que pode fazer parte de um plano de resiliência em vez de deixar o início de sessão de convidados como um ponto único de falha oculto. Analise como a Purple se adequa aos seus requisitos de rede, identidade e failover, e depois comece com um inventário ao nível da propriedade e um simulacro de autenticação controlado.